
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Escrever SQL é uma barreira entre a pergunta de negócio e o dado que a responde. Por isso a ideia de pedir a um modelo de linguagem que escreva a consulta atrai tantas equipes. Essa técnica se chama text-to-SQL. Ela entrega bons resultados em demonstração e erra de formas difíceis de perceber em produção. Entender onde está a diferença leva ao Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Text-to-SQL é a técnica em que um modelo de linguagem recebe uma pergunta em linguagem natural e devolve uma consulta SQL que, executada, traz a resposta. O problema é estudado há décadas em pesquisa de linguagem natural para SQL. Em 2018, o benchmark Spider reuniu perguntas anotadas por pessoas sobre bancos de domínios variados e virou referência para medir a capacidade dos modelos de gerar consultas em esquemas que nunca viram.
Com os LLMs, o pipeline mais comum tem quatro etapas:
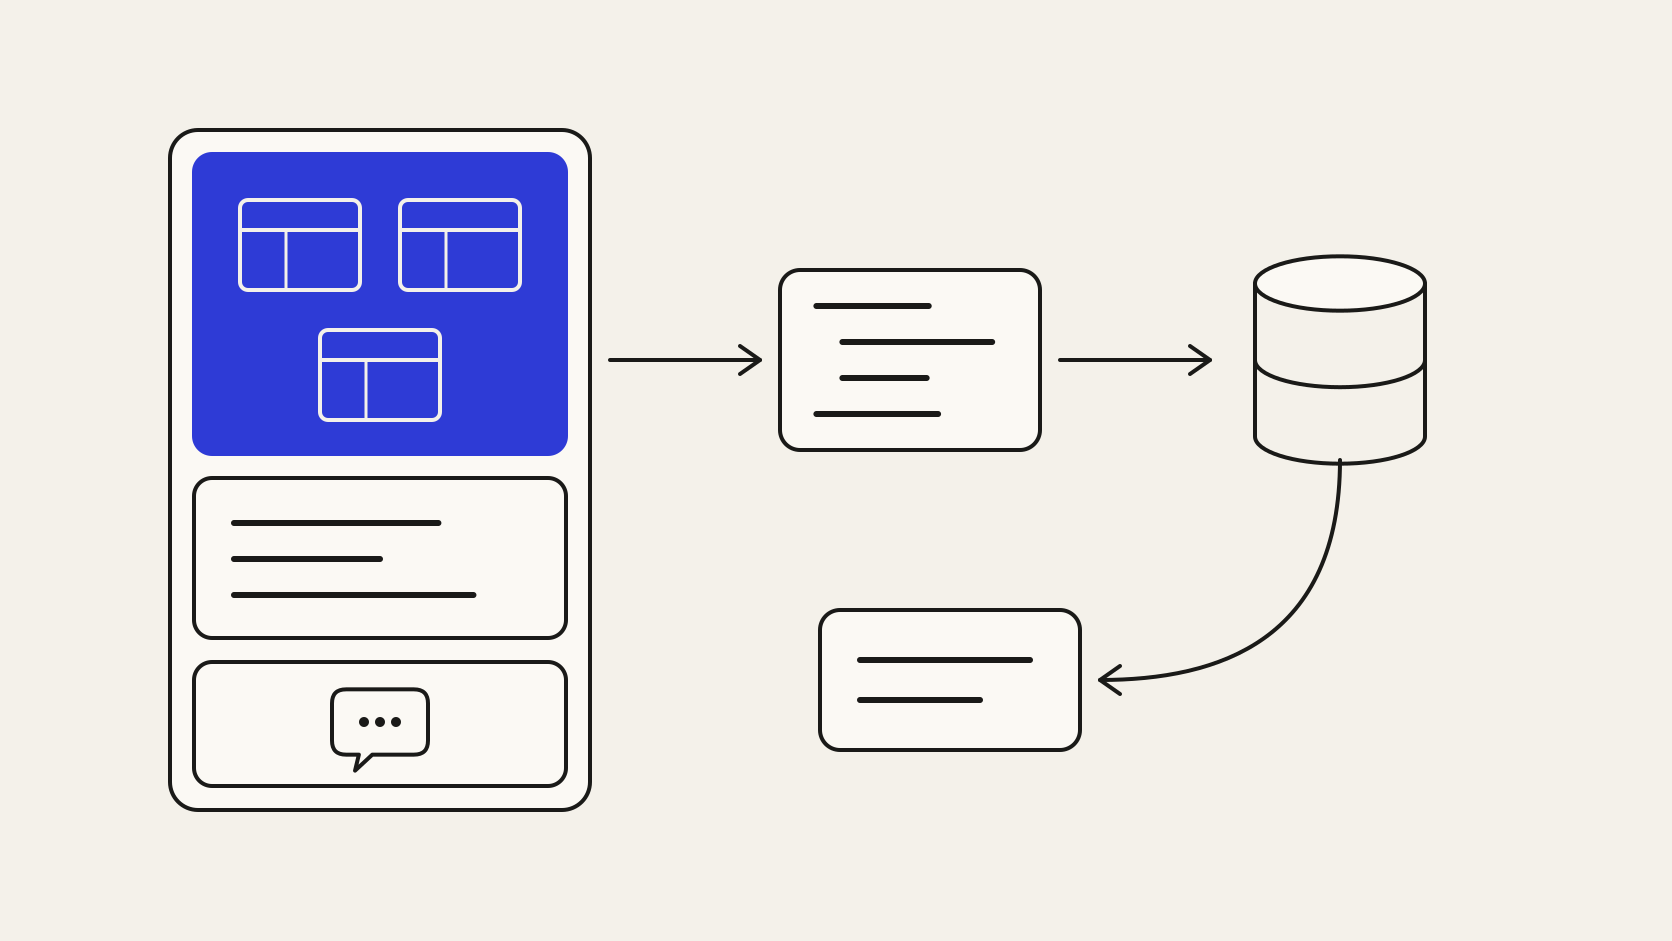
O cenário favorável tem duas condições. O banco tem tabelas e colunas com nomes claros, chaves documentadas e poucas regras implícitas. Quem pergunta sabe ler a consulta gerada e reconhece um resultado estranho.
Uma analista que precisa de um recorte ad hoc sobre um data mart bem desenhado ganha tempo real. A consulta sai em segundos, ela revisa a junção, ajusta um filtro e segue. Nesse uso, o text-to-SQL acelera quem já sabe SQL.
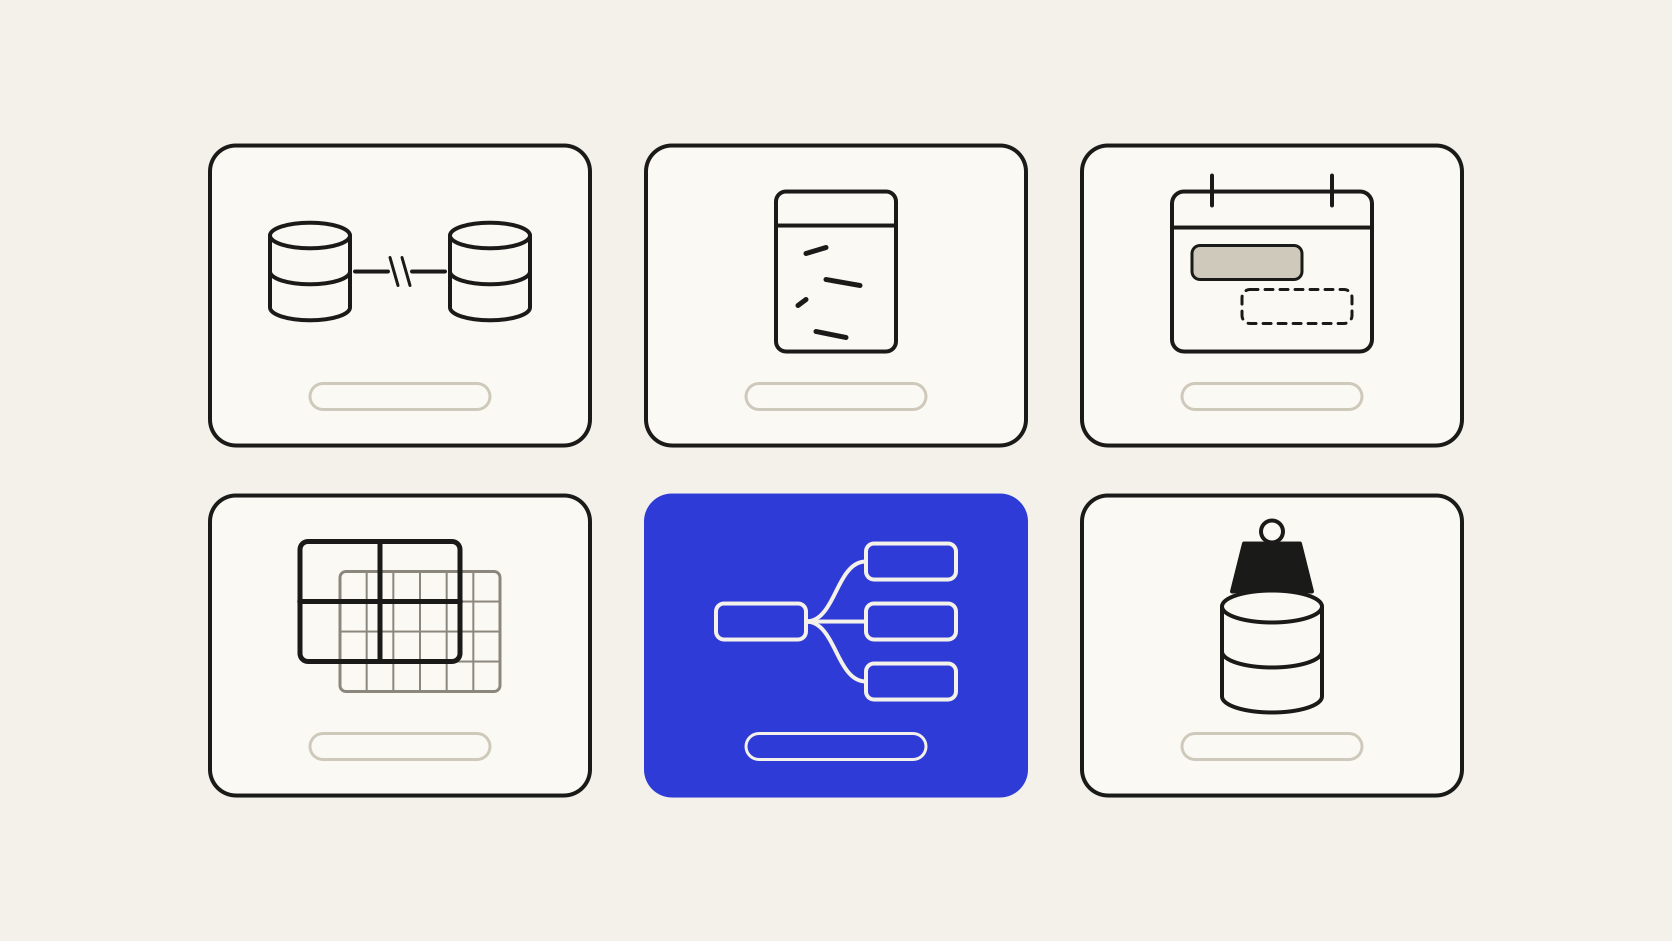
O cenário muda quando a pergunta vem de alguém que não lê SQL e o banco reflete anos de operação. Os erros mais frequentes não geram mensagem de erro. Eles devolvem um número:
Nesses casos, a regra que decide a resposta certa está fora do esquema. Ela vive no hábito da equipe financeira ou em uma planilha de conciliação. O text-to-SQL escolhe a interpretação mais provável, a consulta parece correta para quem não conhece a operação e o número segue para o relatório sem alerta.
Muitos pilotos de text-to-SQL conectam o modelo ao banco com uma credencial de serviço de acesso amplo. A consulta gerada para um vendedor pode então ler a carteira de outro ou a tabela de comissões, porque o banco enxerga a credencial do serviço e ignora a pessoa.
Há também o risco de injeção. Um texto inserido na pergunta, ou guardado em um campo de dado que entra no prompt, pode induzir o modelo a gerar comandos de alteração ou consultas a tabelas sensíveis. Usuário somente leitura, lista de tabelas permitidas e limite de tempo de execução reduzem o dano. A permissão por pessoa continua sem solução nesse desenho.
Para acertar, o modelo precisa do esquema, de exemplos e de notas sobre colunas. Em um ERP com centenas de tabelas, esse material ocupa boa parte do prompt e é reenviado a cada pergunta. Técnicas de seleção de tabelas diminuem o volume e acrescentam uma etapa que também pode errar.
O custo por resposta cresce com o número de sistemas incluídos. Na tentativa de reduzir erros, as equipes migram para modelos maiores, e o custo cresce de novo.
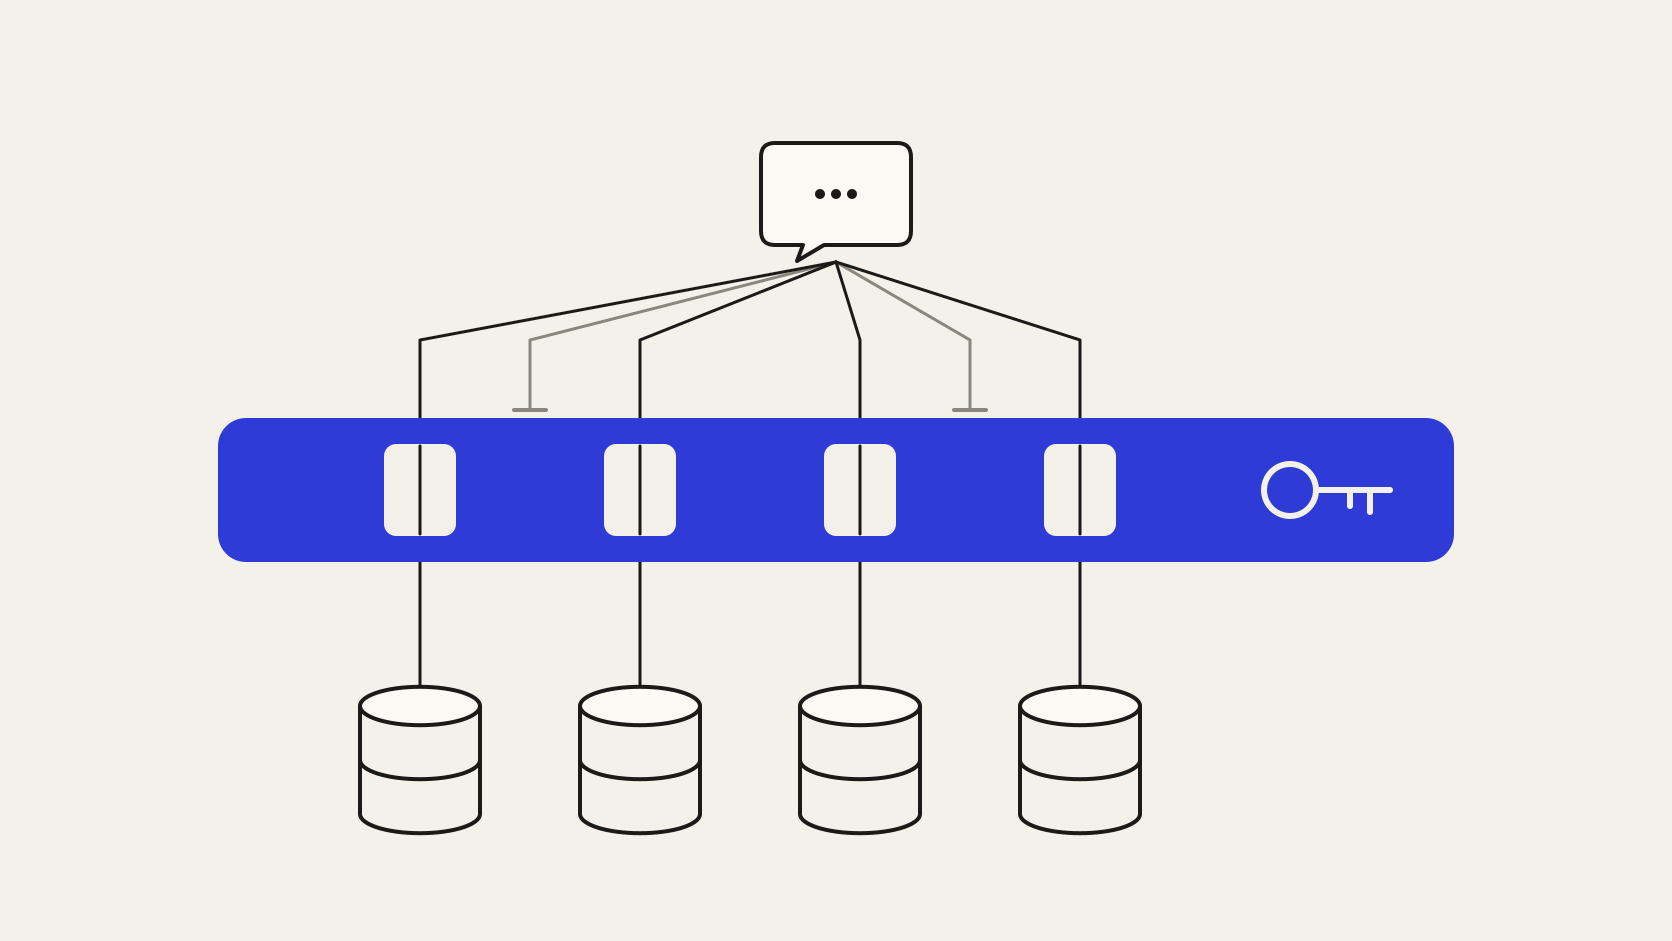
A camada semântica do Company Brain registra métricas e entidades com definição, área responsável e fontes nomeadas. A ontologia do negócio define qual data vale para vendas do mês e qual campo é o valor líquido. O grafo de conhecimento resolve como a meta da regional se liga à venda do vendedor.
O modelo recebe esse vocabulário via MCP, em vez do esquema bruto. O SQL gerado fica restrito às métricas e entidades aprovadas, e a consulta é executada com a permissão herdada do sistema de origem. O prompt encolhe, a tarefa cabe em um modelo de custo menor e cada resultado aponta a definição e a fonte usadas.
A camada semântica cobre o que foi definido. Pergunta fora do vocabulário aprovado precisa ser recusada ou encaminhada a uma pessoa, e as definições exigem manutenção pelas áreas donas dos dados. Para perguntas exploratórias de analistas, o text-to-SQL livre sobre o esquema continua útil, desde que a consulta seja revisada antes de o número circular.
O primeiro passo prático é separar as perguntas que chegam toda semana à equipe de dados, registrar a resposta correta de cada uma e transformar as métricas envolvidas nas primeiras definições. Esse conjunto passa a medir cada mudança de modelo, prompt ou fonte.