
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma empresa liga o agente de cobrança a um modelo externo. Meses depois, negociações com clientes e regras de renegociação estão guardadas na infraestrutura do fornecedor, em outro país, sob termos que o jurídico leu uma vez. Na hora de trocar de modelo, esse histórico fica na plataforma antiga. A soberania de dados trata dessas perguntas: onde o dado está, sob qual lei e quem decide sobre ele. Na IA, a resposta depende de como o contexto chega ao modelo, papel do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
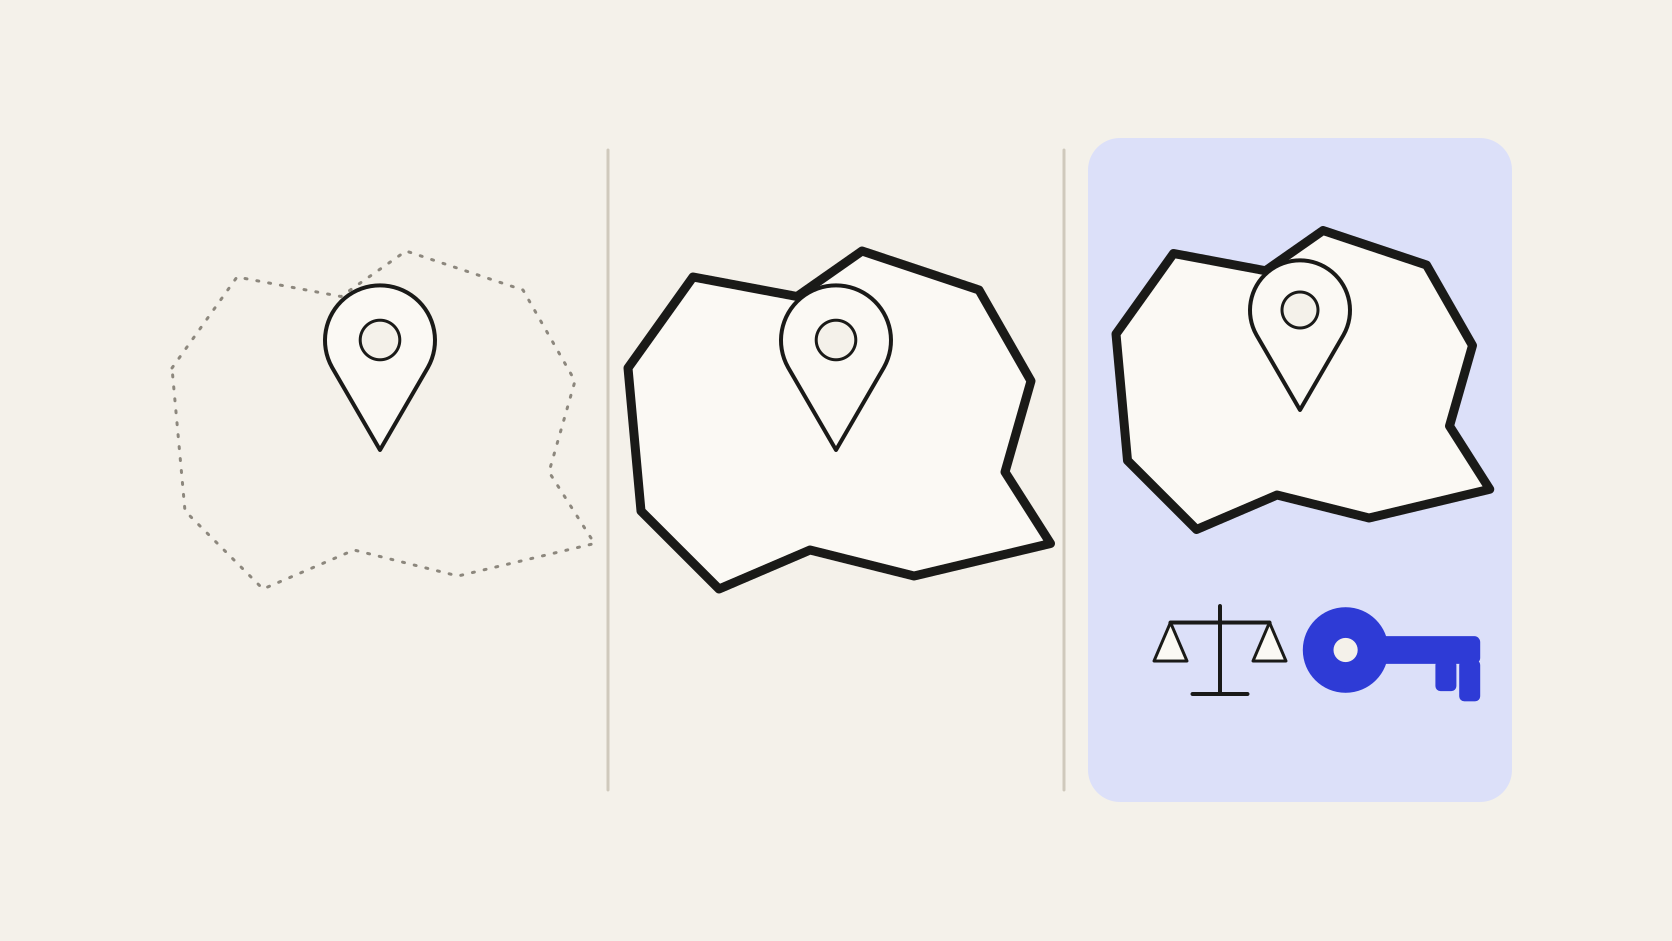
Soberania de dados é a condição em que o dado fica sujeito às leis aplicáveis e às decisões de quem tem legitimidade sobre ele. Ela tem duas camadas:
A segunda camada costuma pesar mais em projetos de IA, porque um dado armazenado no Brasil pode estar sob termos que permitem retenção, revisão por terceiros ou treinamento de modelos.
Residência de dados é a exigência, legal, contratual ou interna, de que o dado seja armazenado em uma região geográfica definida.
Localização de dados é a versão mais estrita: o dado deve ser armazenado e processado dentro do país, em geral por determinação legal.
A soberania de dados abrange as duas e acrescenta o controle. Uma empresa pode cumprir a residência com o dado em um data center nacional e depender de um fornecedor que decide sobre retenção, acesso e uso daquele dado.
Com modelos e agentes, surgem caminhos novos:
Cada caminho nasce de uma decisão de projeto, como ativar a memória ou indexar uma pasta. Por isso a soberania de dados entra no desenho da arquitetura.
O histórico de clientes, as regras comerciais, os preços e as exceções aprovadas descrevem como aquela empresa vende e decide. Concorrentes não conseguem comprar esse conhecimento.
Organizado dentro da ferramenta de um terceiro, esse ativo passa a viver em um ambiente que a empresa não governa. A soberania de dados protege esse conhecimento em dois sentidos: o dado fica fora do produto de outra empresa, e a empresa consegue levá-lo consigo ao trocar de fornecedor.
Na União Europeia, o Data Act, aplicável desde 12 de setembro de 2025, criou regras para clientes trocarem de provedor de processamento de dados, tratando a portabilidade como parte do controle.
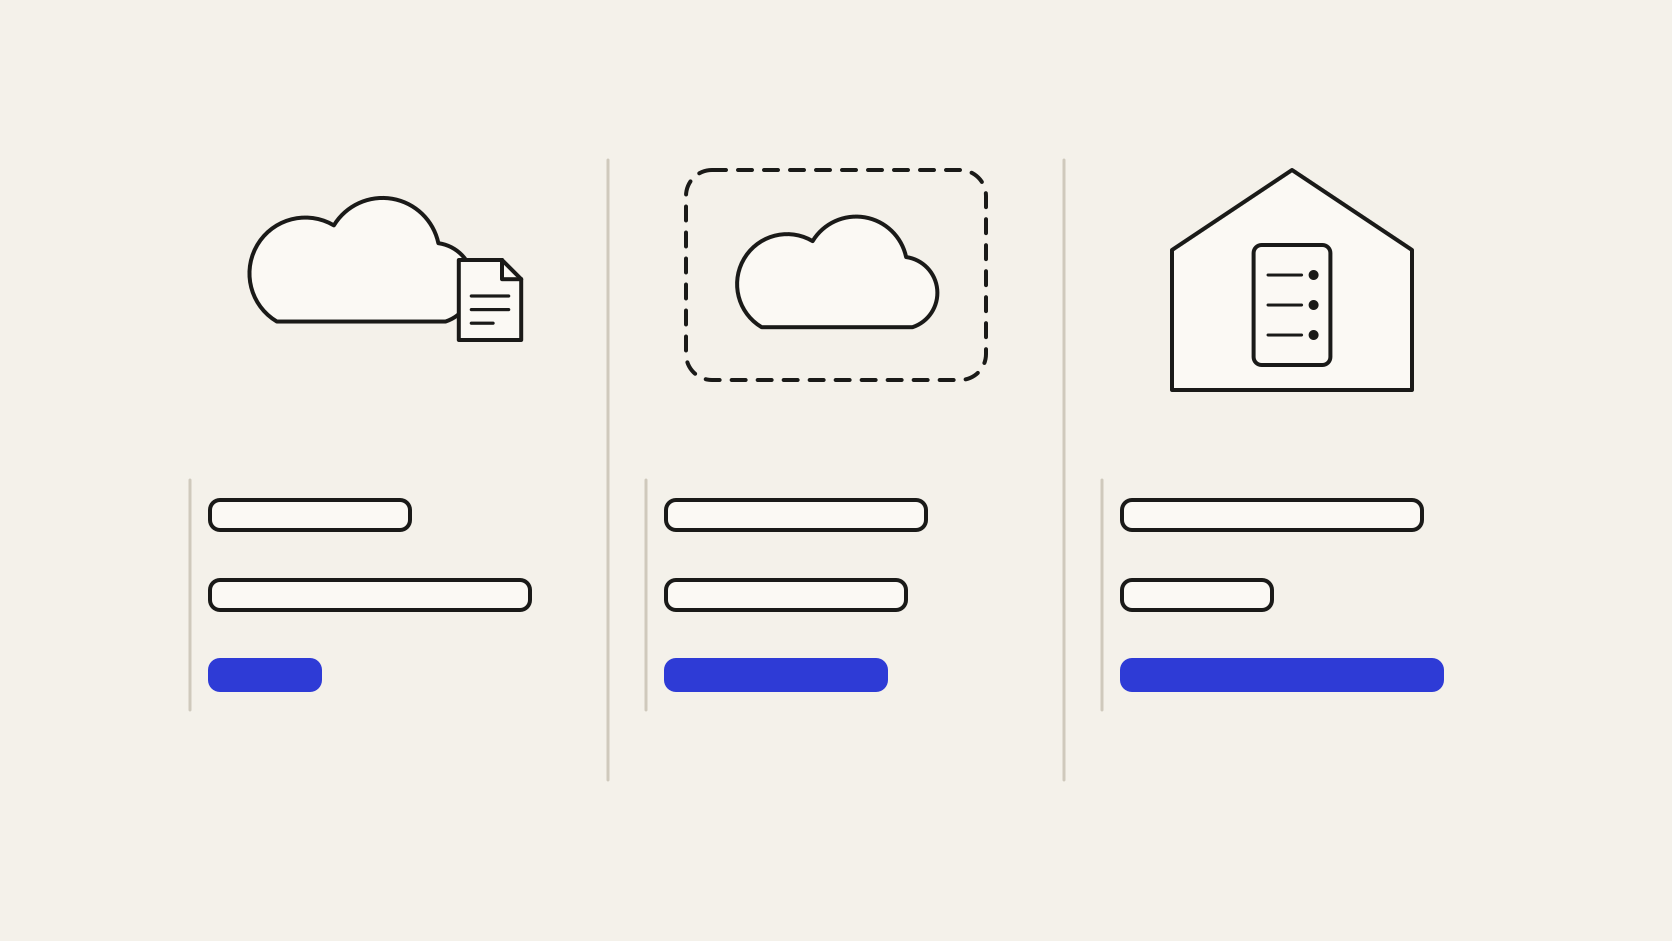
O lugar onde o modelo roda define boa parte da soberania de dados:
Muitas empresas combinam as opções e escolhem a arquitetura por tipo de dado.
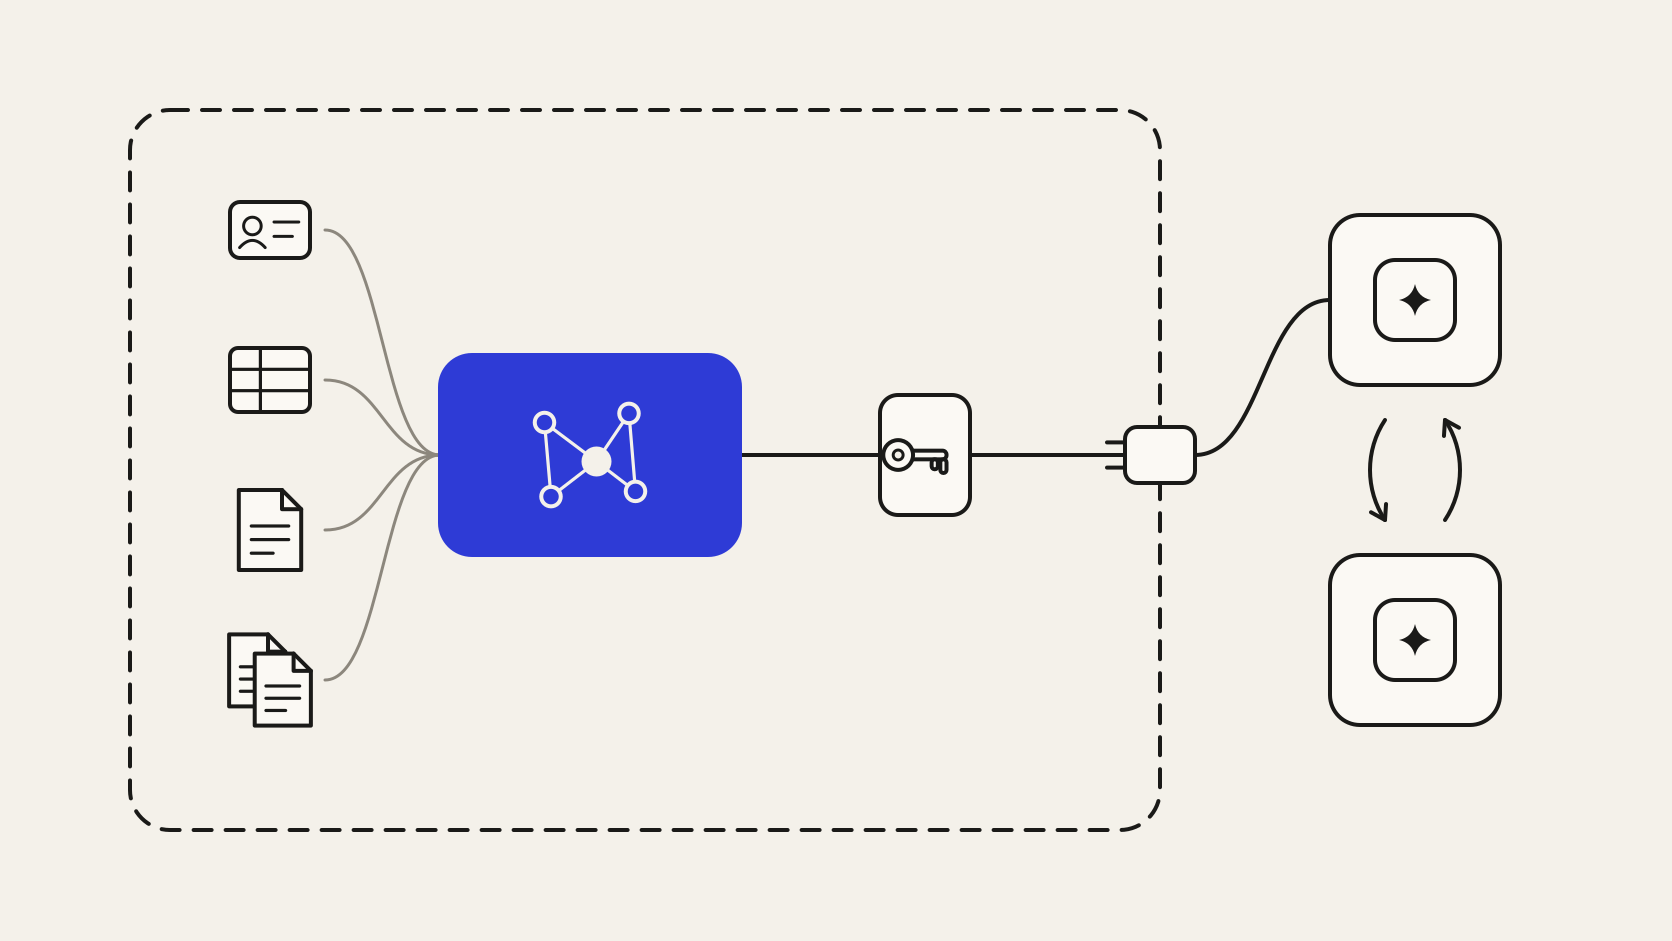
O Company Brain conecta CRM, ERP, helpdesk, contratos e documentos uma vez e organiza esses dados em grafo de conhecimento, ontologia do negócio e camada semântica. Os dados permanecem nos sistemas e no ambiente do cliente, sem cópia das bases para o provedor do modelo.
A cada pergunta, o modelo recebe via MCP, o protocolo aberto que conecta modelos a fontes de dados, apenas o recorte necessário, filtrado pela permissão herdada da origem. O que sai do ambiente depende da arquitetura escolhida: com serviço externo, sai o recorte daquela chamada, sob os termos contratados; com nuvem própria ou modelo local, o recorte também fica com a empresa.
O contexto organizado, com entidades, relações e regras, pertence à empresa. Como o modelo o consome por um protocolo aberto, trocar de modelo dispensa refazer integrações, e cada resposta aponta a fonte de cada informação.
A arquitetura sozinha não fecha a questão. Um contrato que permite treinamento anula o cuidado com o recorte, e uma região mal configurada leva o processamento para outro país. Avaliar termos e registrar transferências continua sendo trabalho do jurídico, da segurança e do encarregado de dados. Restringir material sensível a modelos locais também pode reduzir a qualidade em tarefas complexas.
O mapa registra, para cada uso de IA em operação, quais dados entram, em qual serviço, em qual país são processados, sob quais termos de retenção e treinamento e o que seria preciso para trocar de fornecedor.
Os fluxos com dado pessoal ou segredo comercial e sem plano de saída são os primeiros candidatos a mudar. Para eles, conectar as fontes ao Company Brain e escolher o modelo por tipo de dado coloca nas mãos da empresa a decisão sobre onde o contexto fica.