
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Um cliente pede a devolução de uma mercadoria com defeito. O atendimento abre um protocolo no helpdesk, a logística agenda a coleta no sistema de armazém, o fiscal emite a nota de devolução e o financeiro faz o estorno no ERP. Cada área registra a própria etapa com o próprio número, e ninguém consegue dizer em que ponto a devolução está sem consultar as outras três. Esse é o efeito prático dos silos de dados. Eles acompanham o organograma, e os processos que valem automatizar com IA atravessam o organograma. Ligar essas partes é o papel do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
O termo descreve dados mantidos por uma área ou por um sistema que o restante da empresa não alcança de forma confiável. O isolamento tem duas camadas. A técnica é a falta de integração: o sistema fiscal não lê o protocolo do helpdesk. A semântica é a diferença de significado: o mesmo termo descreve coisas distintas em cada área.
Nos silos de dados, os dois isolamentos costumam aparecer juntos. Integrar os sistemas resolve o primeiro e deixa o segundo intacto, porque os registros passam a circular com rótulos que cada área lê de um jeito.
A empresa distribui orçamento, metas e responsabilidade por área. Cada área escolhe o sistema que atende o próprio trabalho, e cada sistema traz o próprio cadastro, o próprio identificador e as próprias regras. Em 1968, Melvin Conway observou que as organizações produzem sistemas que copiam a própria estrutura de comunicação. Os silos de dados são essa cópia aplicada à informação.
No exemplo da devolução, a pergunta sobre quando ela foi concluída tem quatro respostas. Para a logística, quando o item chegou ao armazém. Para o fiscal, quando a nota foi autorizada. Para o financeiro, quando o estorno saiu. Para o atendimento, quando o protocolo foi fechado.
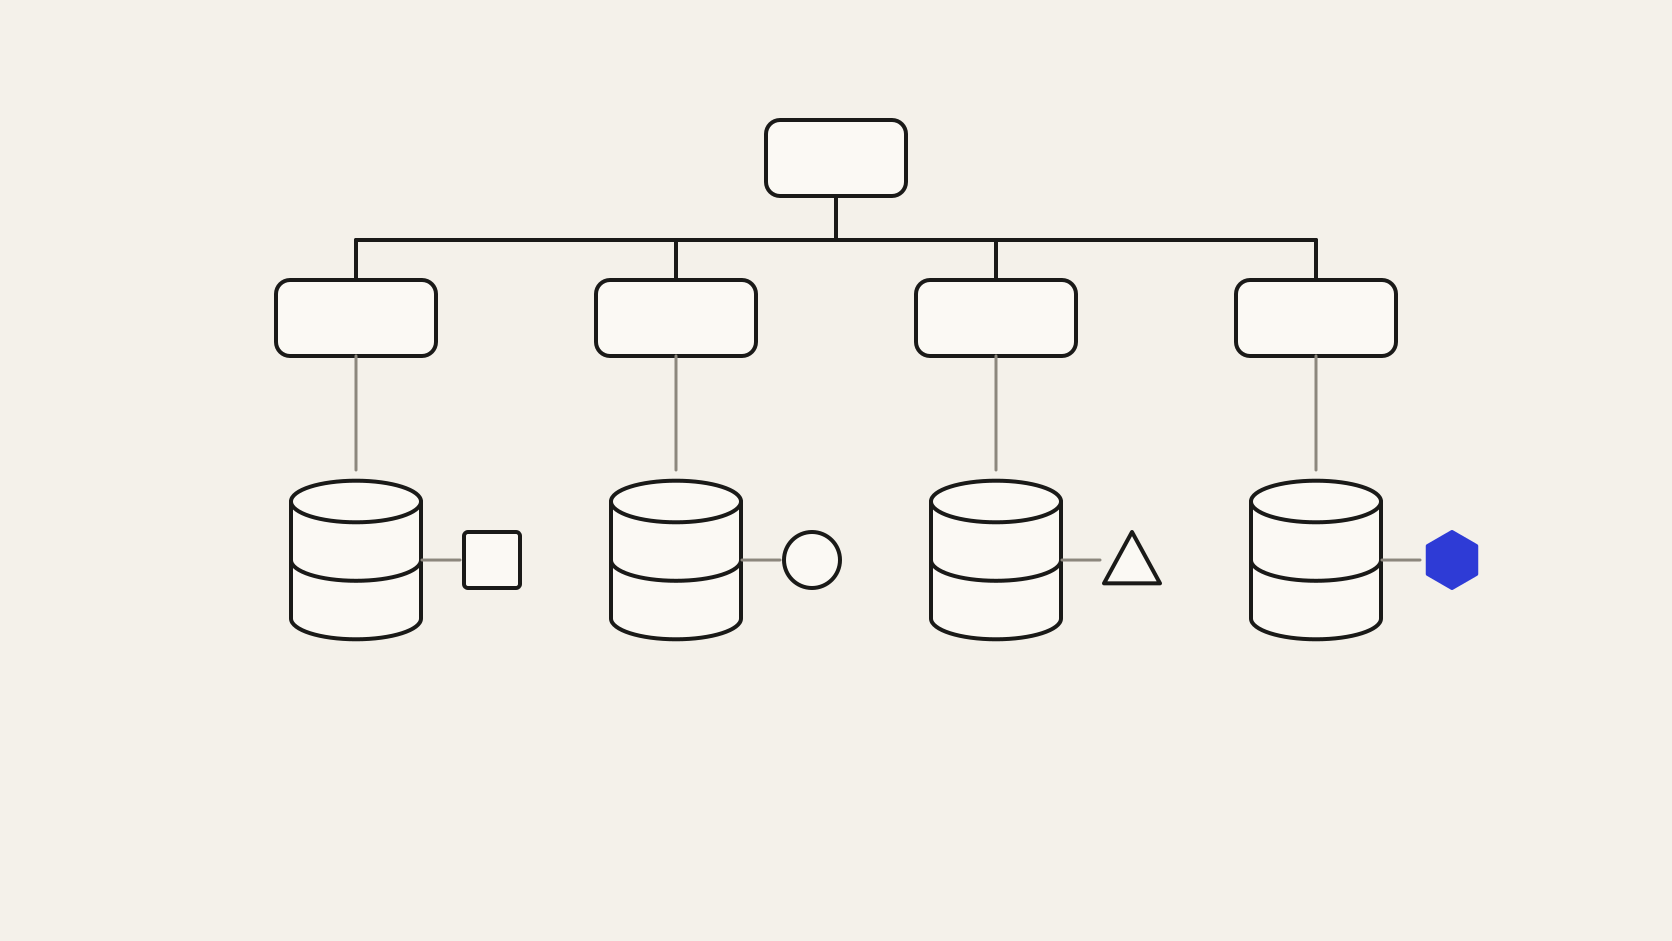
Um agente que acompanha devoluções precisa ler as quatro fontes em sequência:
Sem uma dessas fontes, a resposta ao cliente sai incompleta. O mesmo vale para o onboarding de um cliente B2B, que passa por vendas, jurídico, implantação e cobrança, e para quase todo processo que gera reclamação recorrente.
O atendimento compra um assistente ligado ao helpdesk. Ele responde que a devolução está em análise, porque não enxerga que a coleta já foi feita. O financeiro constrói um agente sobre o ERP, que informa o estorno sem saber que a conferência reprovou o item. Cada projeto vê um pedaço do processo.
O custo desses novos silos de dados aparece em três frentes. As respostas entram em conflito, e o cliente recebe versões diferentes conforme o canal. A integração com o ERP e com o cadastro de clientes é refeita em cada projeto. E cada agente carrega uma cópia própria das regras de acesso, que precisa ser atualizada separadamente.
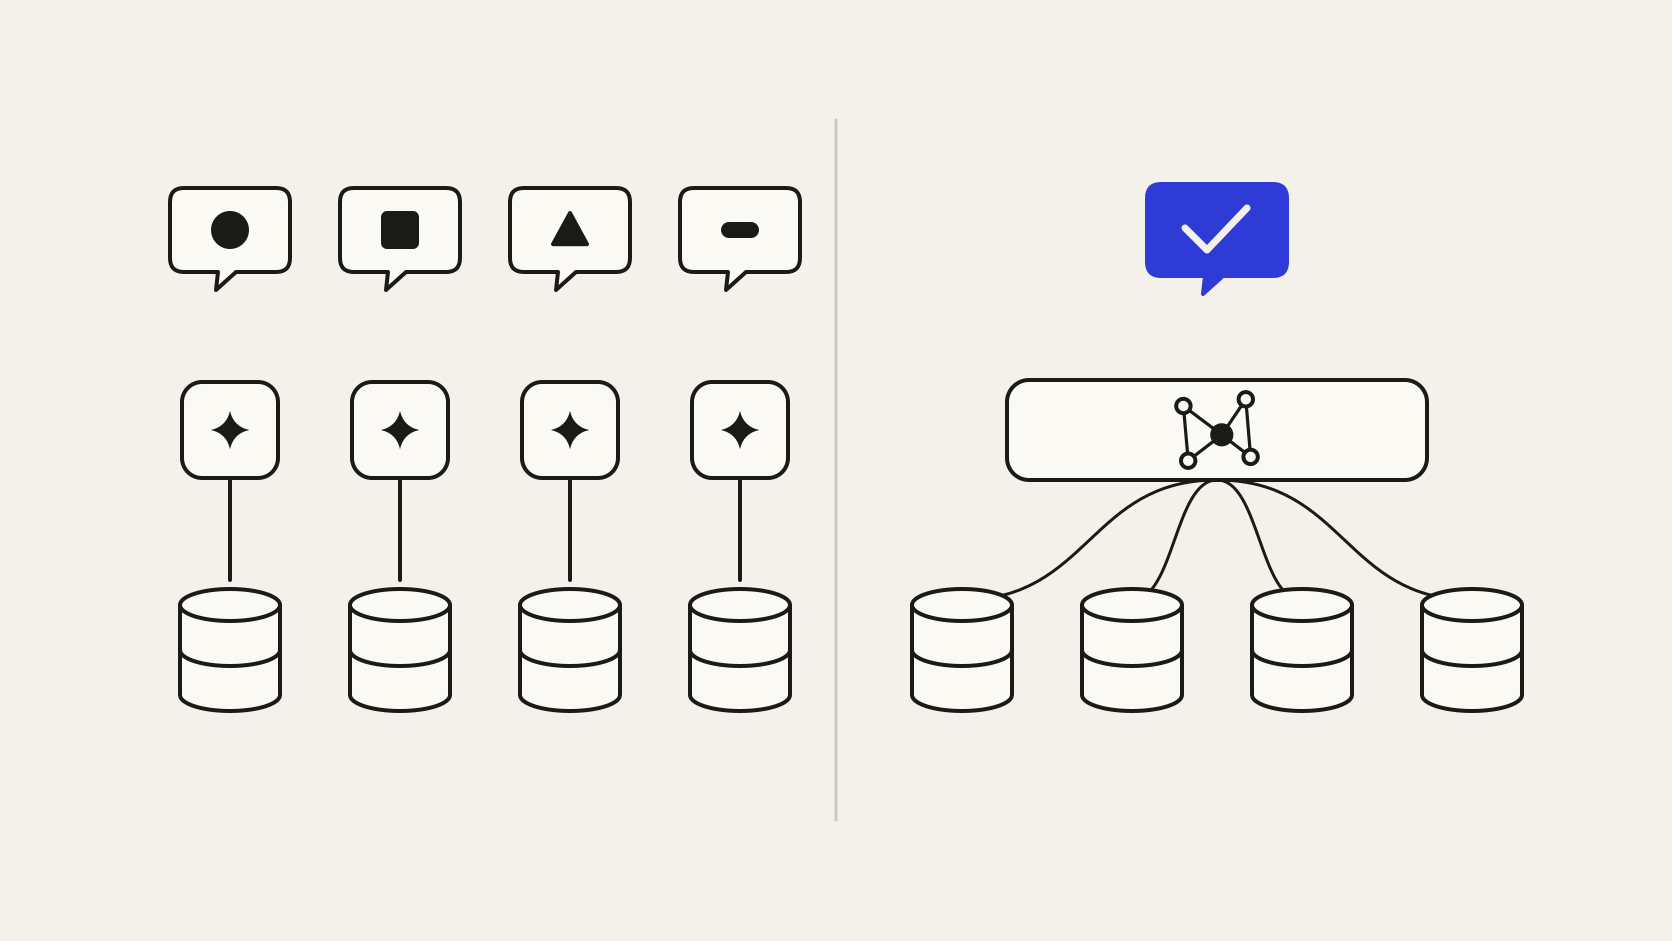
Reorganizar a empresa em torno de cada processo custa caro e dura até o próximo processo, que corta as áreas por outro caminho. A alternativa é deixar a estrutura de áreas como está e ligar o dado em outra camada. A camada de contexto reconhece que o protocolo, a ordem de coleta, a nota e o estorno pertencem à mesma devolução e ao mesmo cliente.
Cada área continua dona do próprio sistema. O que passa a existir é um mapa compartilhado das entidades e das etapas que ligam os registros dessas áreas.
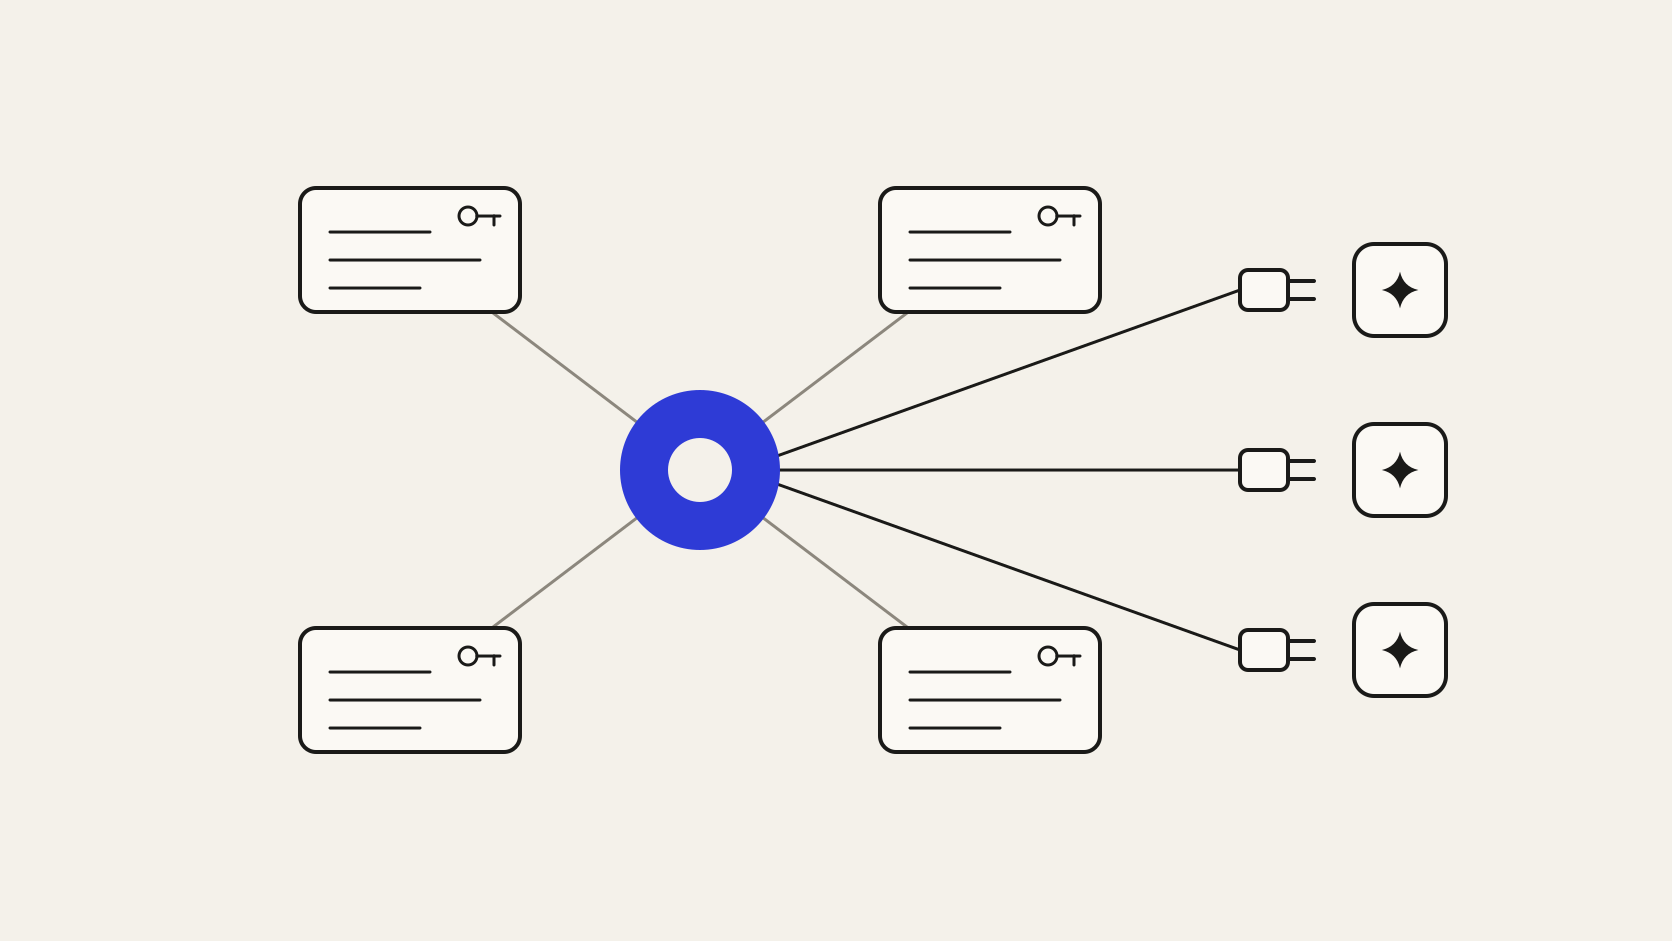
O contexto é servido via MCP, o protocolo aberto que conecta modelos a fontes de dados, e cada resposta aponta o sistema de origem. O agente do atendimento e o agente do fiscal usam a mesma base. O segundo projeto parte do que o primeiro deixou ligado, e a integração com cada fonte acontece uma vez.
Os vínculos entre áreas e as definições do processo de ponta a ponta pertencem a todas e a nenhuma delas. Sem um responsável nomeado, ninguém decide qual definição prevalece quando duas áreas discordam. Esse papel costuma ficar com dados ou operações, com um fórum curto das áreas envolvidas para as divergências.
A camada também tem pré-requisitos. As fontes precisam ser acessíveis por API ou banco, e algum identificador comum, como o número do pedido, precisa aparecer em pelo menos dois sistemas. Quando uma regra de negócio diverge entre áreas, a camada registra a divergência e a decisão continua com as pessoas.
O ponto de partida é um processo que gera reclamação recorrente e atravessa duas ou três áreas. Mapear os sistemas envolvidos, os identificadores que cada um usa e os termos com definições diferentes mostra quais entidades modelar primeiro. O processo seguinte reaproveita o cliente, o pedido e as permissões já ligados, e o mapa dos silos de dados diminui a cada projeto.