
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma empresa quer saber quanto gastou com um fornecedor no ano. O sistema de compras mostra um valor, o contas a pagar mostra outro, e a diferença está em três cadastros do mesmo fornecedor criados por equipes diferentes ao longo do tempo. Decidir quais registros representam a mesma empresa se chama resolução de entidades, e dela depende a qualidade de qualquer resposta de IA sobre fornecedores, produtos ou pessoas. Ela também é a base do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
A resolução de entidades é o processo de identificar quais registros, em sistemas diferentes ou dentro do mesmo sistema, representam a mesma entidade do mundo real. Em inglês, o termo é entity resolution. Deduplicação e record linkage são nomes usados para recortes do mesmo problema: eliminar cadastros repetidos em uma base e ligar registros entre bases distintas.
O problema surge em qualquer entidade que mais de um sistema cadastra:
Os projetos de resolução de entidades costumam seguir a mesma sequência:
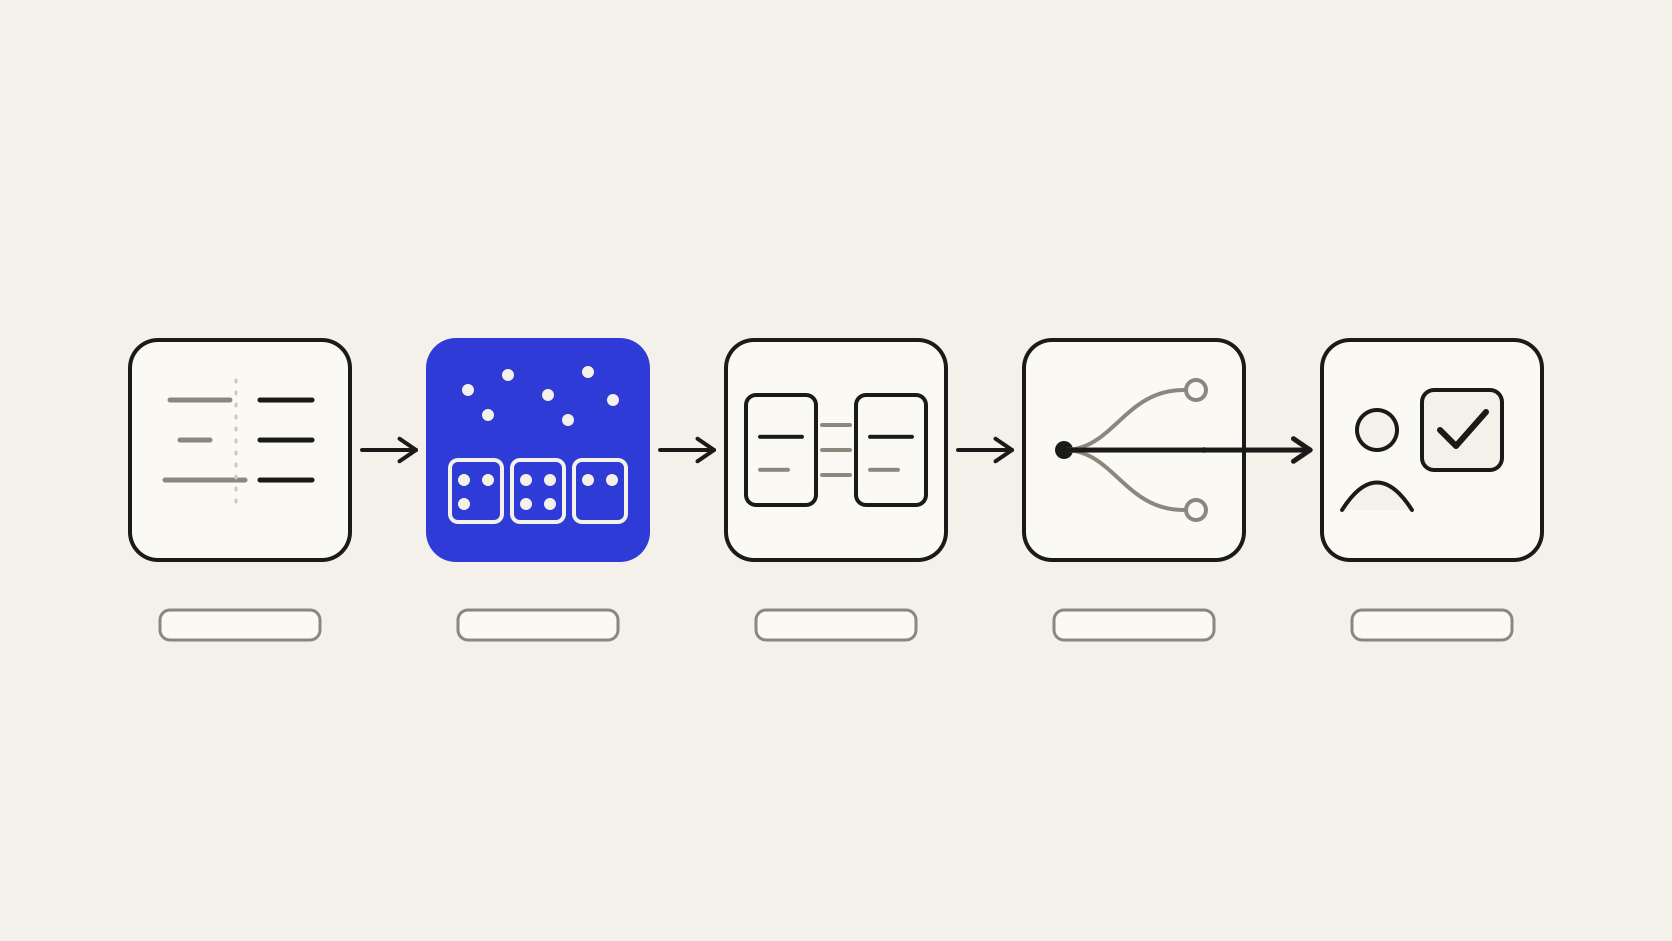
Uma regra determinística exige concordância exata em um identificador confiável, como o mesmo código de barras no ERP e no e-commerce ou a mesma matrícula no HRIS e no sistema de despesas. Ela é simples de auditar e depende de o identificador estar preenchido nas duas pontas.
Quando não há identificador comum, entra a abordagem probabilística. Cada atributo recebe um peso, e coincidir em um sobrenome raro pesa mais que coincidir em um sobrenome frequente. A base formal dessa abordagem é o modelo publicado por Ivan Fellegi e Alan Sunter em 1969, com dois limiares de pontuação e três saídas possíveis. Um relatório do U.S. Census Bureau que revisa o modelo de Fellegi e Sunter e as técnicas de blocagem descreve a faixa entre os limiares como a zona destinada à revisão manual.
A resolução de entidades erra de duas formas. A primeira é separar o que é igual. O fornecedor continua com três cadastros e o gasto aparece fragmentado, um erro visível porque a resposta sai incompleta.
A segunda é juntar o que é diferente. Dois fornecedores com nomes parecidos viram um único registro, e as ocorrências de entrega de um entram no histórico do outro. O erro é silencioso, porque o resultado parece dado consolidado.
Com IA, o segundo erro pesa mais. O modelo recebe a entidade fundida como fato e redige uma resposta coerente sobre um fornecedor que não existe, com o atraso de um e o contrato do outro. Por isso os limiares costumam ser mais conservadores para a fusão: um caso duvidoso enviado à revisão custa menos que um vínculo errado propagado para todas as consultas.
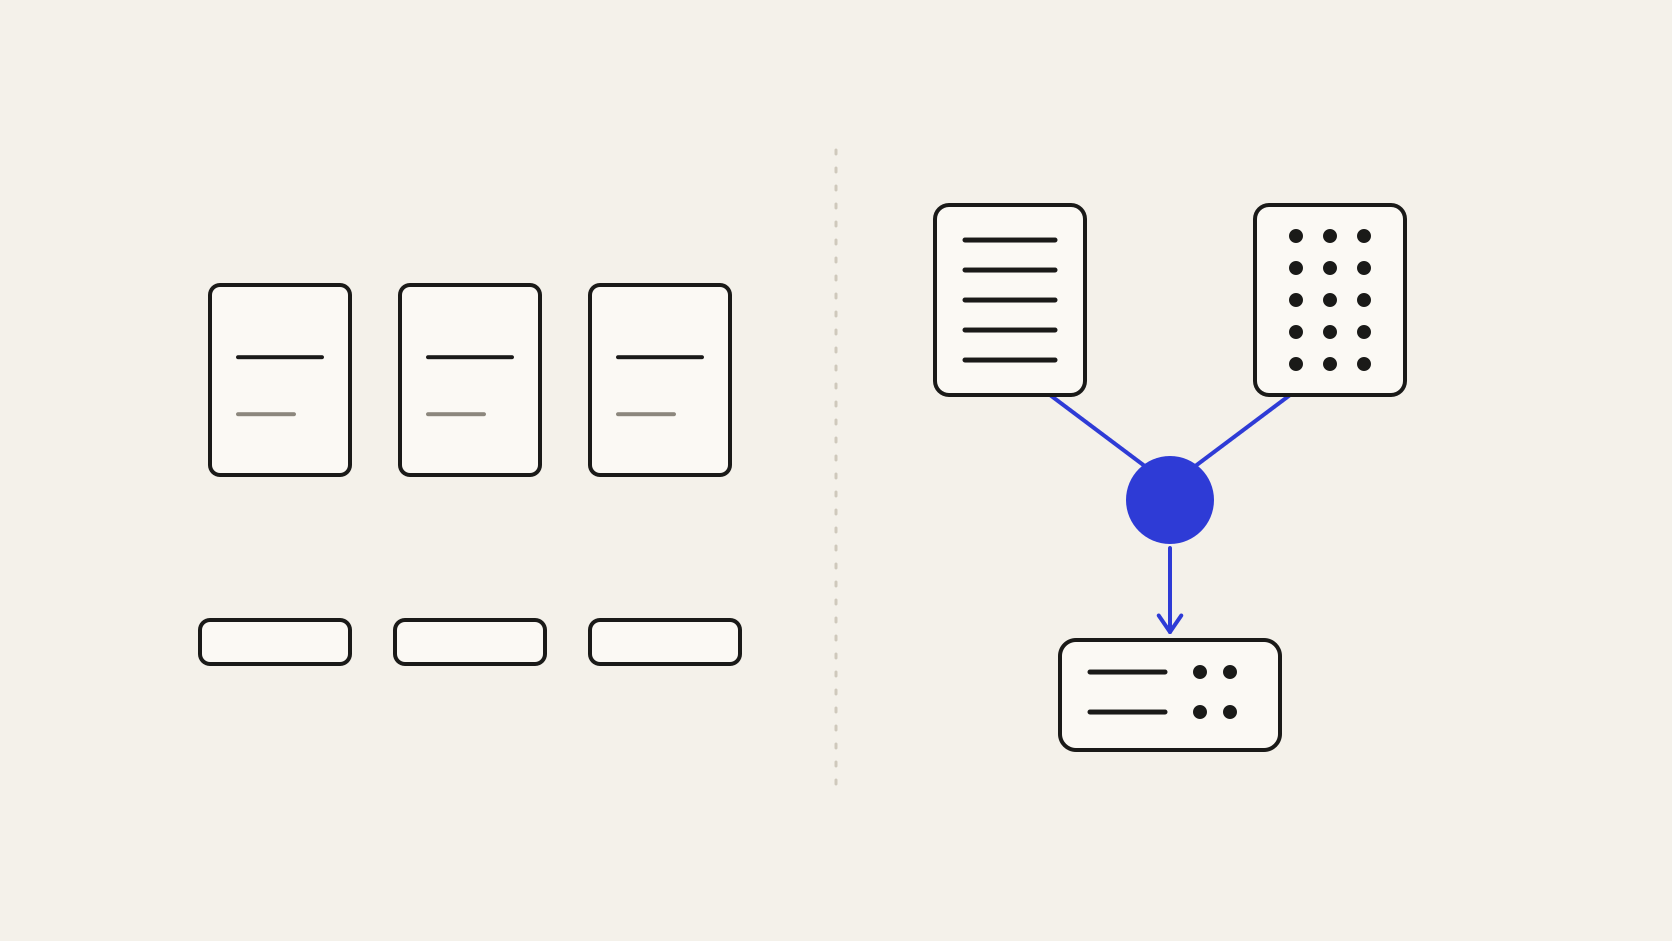
Para cada par ligado, o registro guarda a regra ou a pontuação que motivou a decisão, os atributos comparados, quem aprovou nos casos revisados e a data.
A reversibilidade depende de como o vínculo é armazenado. Quando a resolução de entidades sobrescreve os registros originais, desfazer uma fusão errada exige reconstruir dados à mão. Quando os registros de origem permanecem intactos e o vínculo fica em uma camada separada, a correção consiste em remover a ligação.
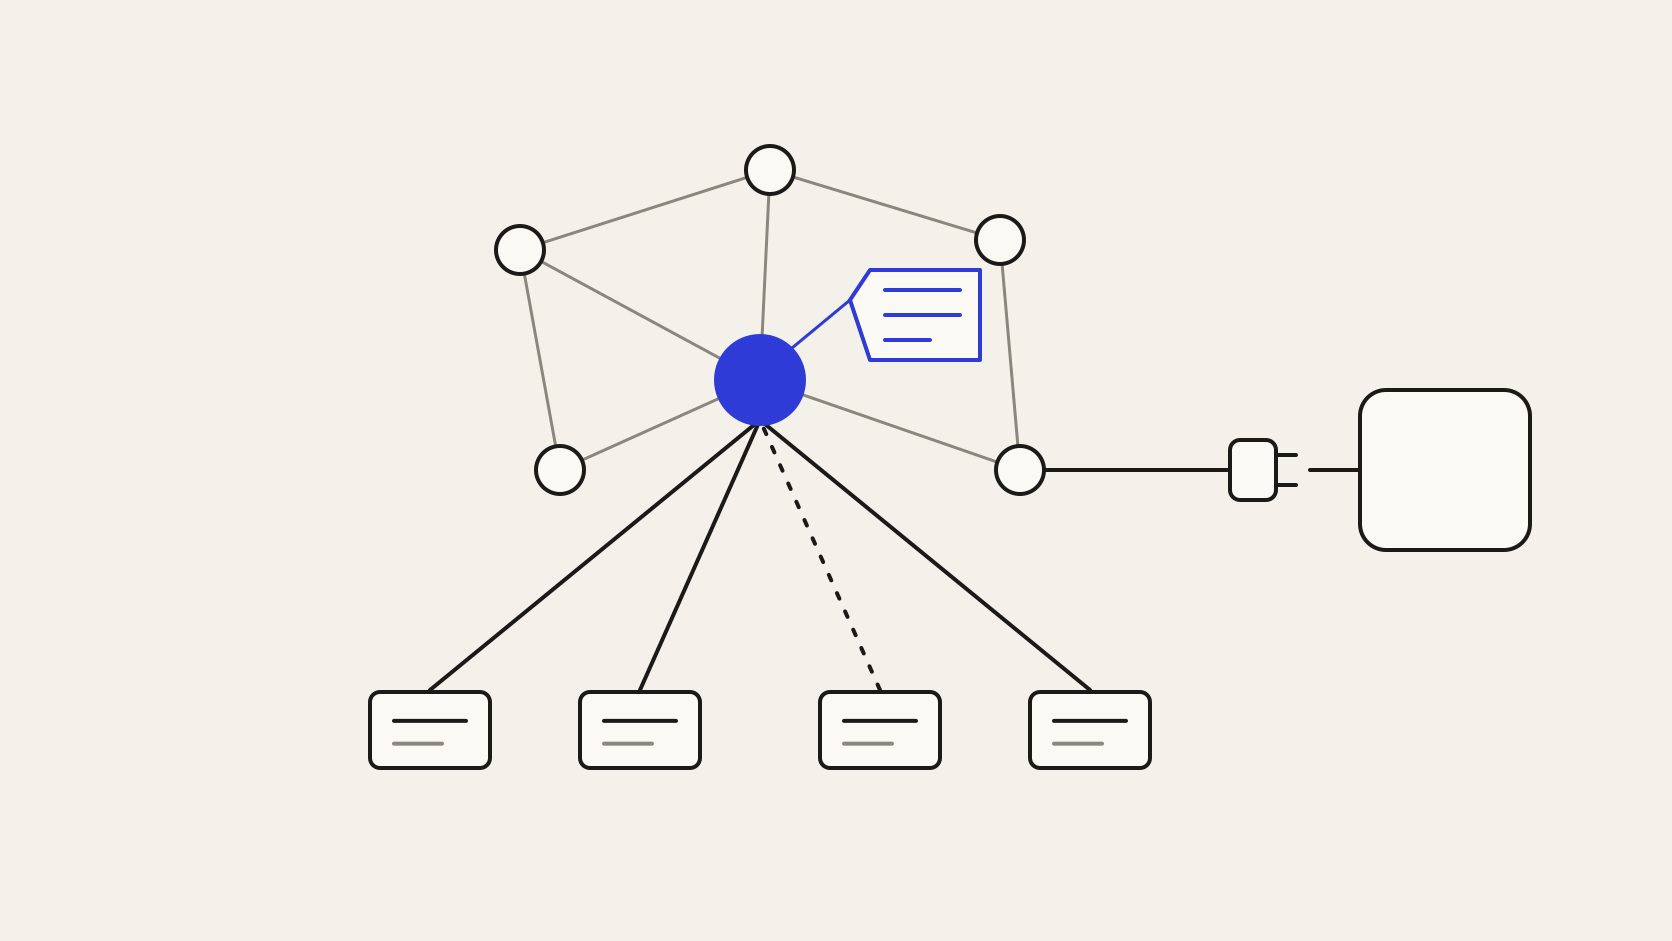
Cada nó do grafo de conhecimento é uma entidade já resolvida, ligada aos registros de origem em cada sistema. Sem essa etapa, o grafo repetiria a fragmentação dos sistemas.
A ontologia do negócio define o que conta como a mesma entidade. Compras pode tratar matriz e filial como fornecedores distintos, porque o prazo de entrega muda entre elas, enquanto o financeiro consolida as duas para medir a exposição total. A regra de vínculo segue essa definição, e o grafo guarda os dois níveis.
Quando um agente consulta o Company Brain via MCP, recebe a entidade já resolvida, com a indicação dos registros que a compõem. A permissão é herdada de cada sistema de origem, e a resposta aponta de onde veio cada informação.
Nenhum método liga registros que não compartilham atributos comparáveis. Se um sistema guarda apenas o nome e outro apenas um código interno, a ligação depende de uma terceira fonte ou de cadastro manual.
Os limiares precisam de calibração com quem conhece os dados, e a fila de revisão precisa de um responsável na área. O processo também é contínuo, porque cada novo cadastro passa pelas mesmas etapas.
O ponto de partida recomendado é uma pergunta recorrente que hoje esbarra em duplicidade, como o gasto anual por fornecedor cruzado com as ocorrências de entrega. Ela define a entidade, as duas primeiras fontes e os atributos para comparação.
O volume da fila de revisão nas primeiras semanas mostra onde vale corrigir o cadastro na origem. As entidades resolvidas nesse recorte passam a servir o próximo caso de uso, que parte delas em vez de recomeçar a conciliação.