
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo: A maioria das empresas define os requisitos de contexto depois do terceiro agente de IA, quando já existem três integrações, três índices e três regras de permissão para o mesmo cliente. Definir antes do primeiro agente exige responder a quatro perguntas de integração, latência, escala e governança. Este texto mostra como cada uma aparece no desenho de uma infraestrutura unificada de contexto e o que medir na prova de conceito.
O primeiro agente de IA de uma empresa costuma nascer dentro de uma área: um assistente de vendas que lê o CRM, um bot de atendimento que lê a base de conhecimento. Funciona bem até a segunda área pedir o próprio agente com o mesmo cliente, o mesmo contrato e uma regra de acesso diferente. A partir daí, cada projeto refaz a integração, e o contexto do cliente passa a existir em várias versões.
A infraestrutura unificada de contexto resolve isso conectando as fontes uma única vez e servindo o mesmo contexto a todos os agentes.
Company Brain (cérebro operacional do negócio): camada que conecta os sistemas da empresa uma única vez, organiza dados, memória e conhecimento e entrega esse contexto a qualquer agente de IA, com as permissões de cada pessoa.
Na Strattum, os requisitos que definimos com os clientes antes do primeiro agente cabem em quatro grupos.
A lista de conectores importa menos do que a resposta a uma pergunta: onde mora a regra que o agente vai aplicar? Em muitas empresas, ela está em uma planilha do financeiro, no ERP customizado ou em um e-mail de aprovação, fora do pipeline de dados oficial. O requisito precisa listar essas fontes e dizer qual sistema vale para cada atributo quando CRM e ERP discordam. É aqui que entra a ontologia, a descrição das entidades do negócio e das relações entre elas, que no Company Brain é versionada em Git e revisada como código.
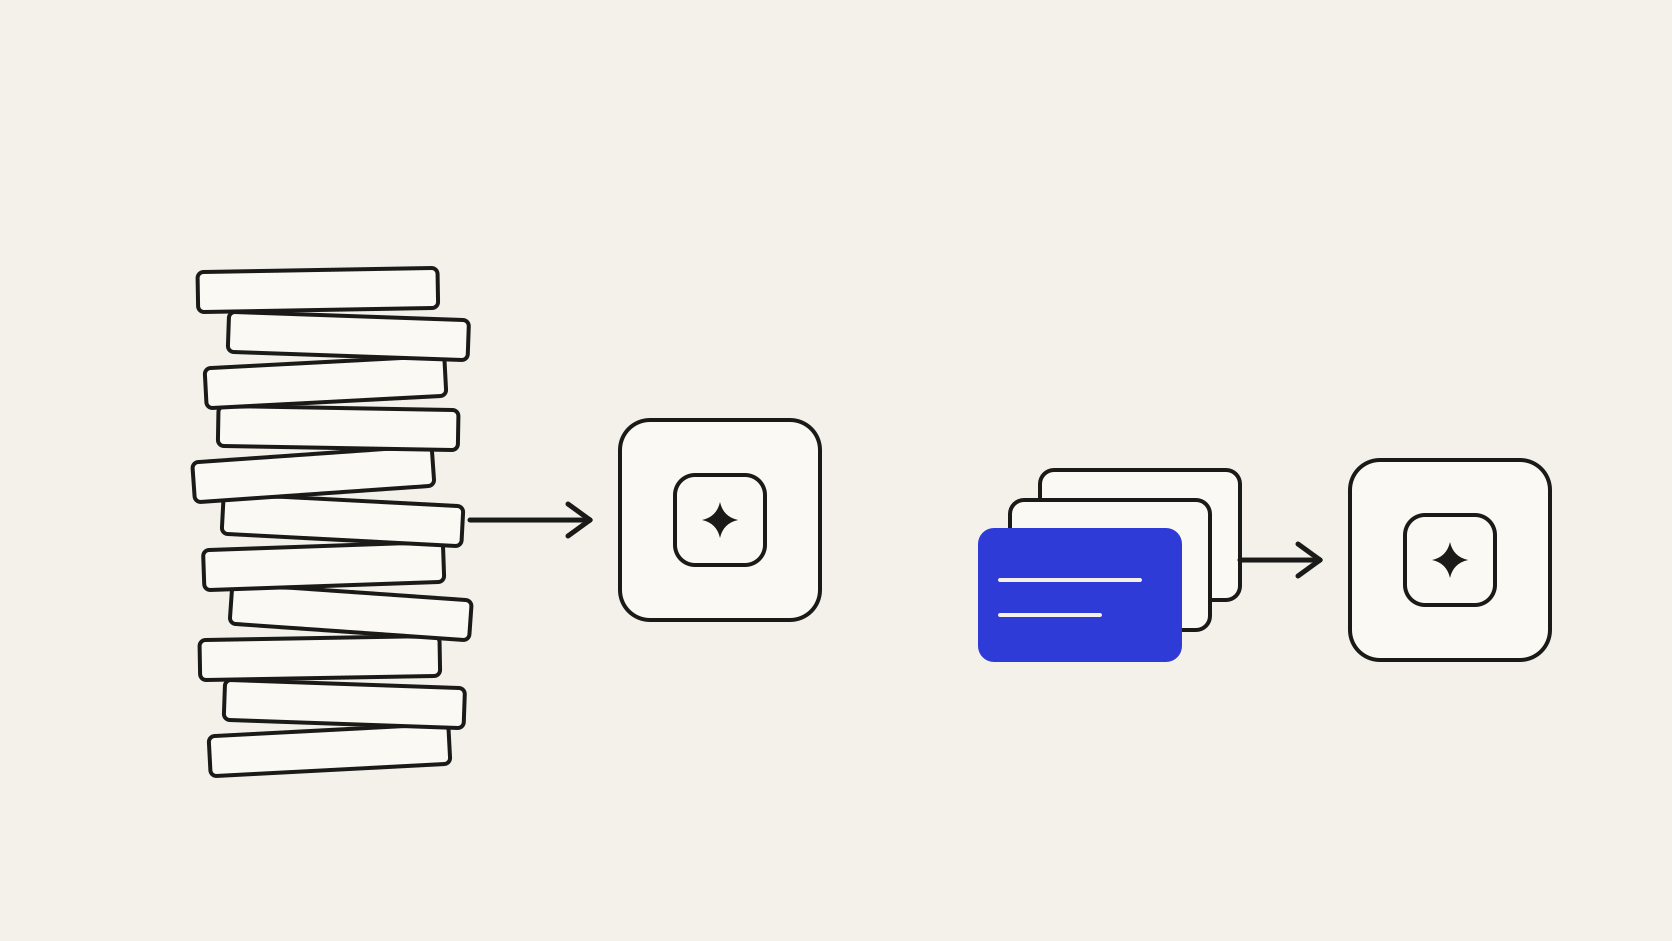
A latência percebida soma recuperação, montagem do prompt e resposta do modelo. O item que mais pesa costuma ser o tamanho do contexto. Quando o contexto chega como pilha de documentos, o prompt cresce, a resposta demora e o custo sobe. Quando chega organizado em entidades, o agente recebe só o que a pergunta exige. Na prova de conceito, medimos o tempo de recuperação, o tamanho do contexto enviado e o consumo de tokens por resposta. Esse último número mostra se a empresa consegue usar modelos menores na maior parte das tarefas.
O volume de documentos, entidades e consultas define a escolha do motor de grafo, do índice e da infraestrutura. A conta precisa ser feita antes do contrato, com o volume real da empresa e a projeção de novos casos de uso. A Strattum publica uma calculadora de capacidade para projetar ingestão, memória, disco e custo.
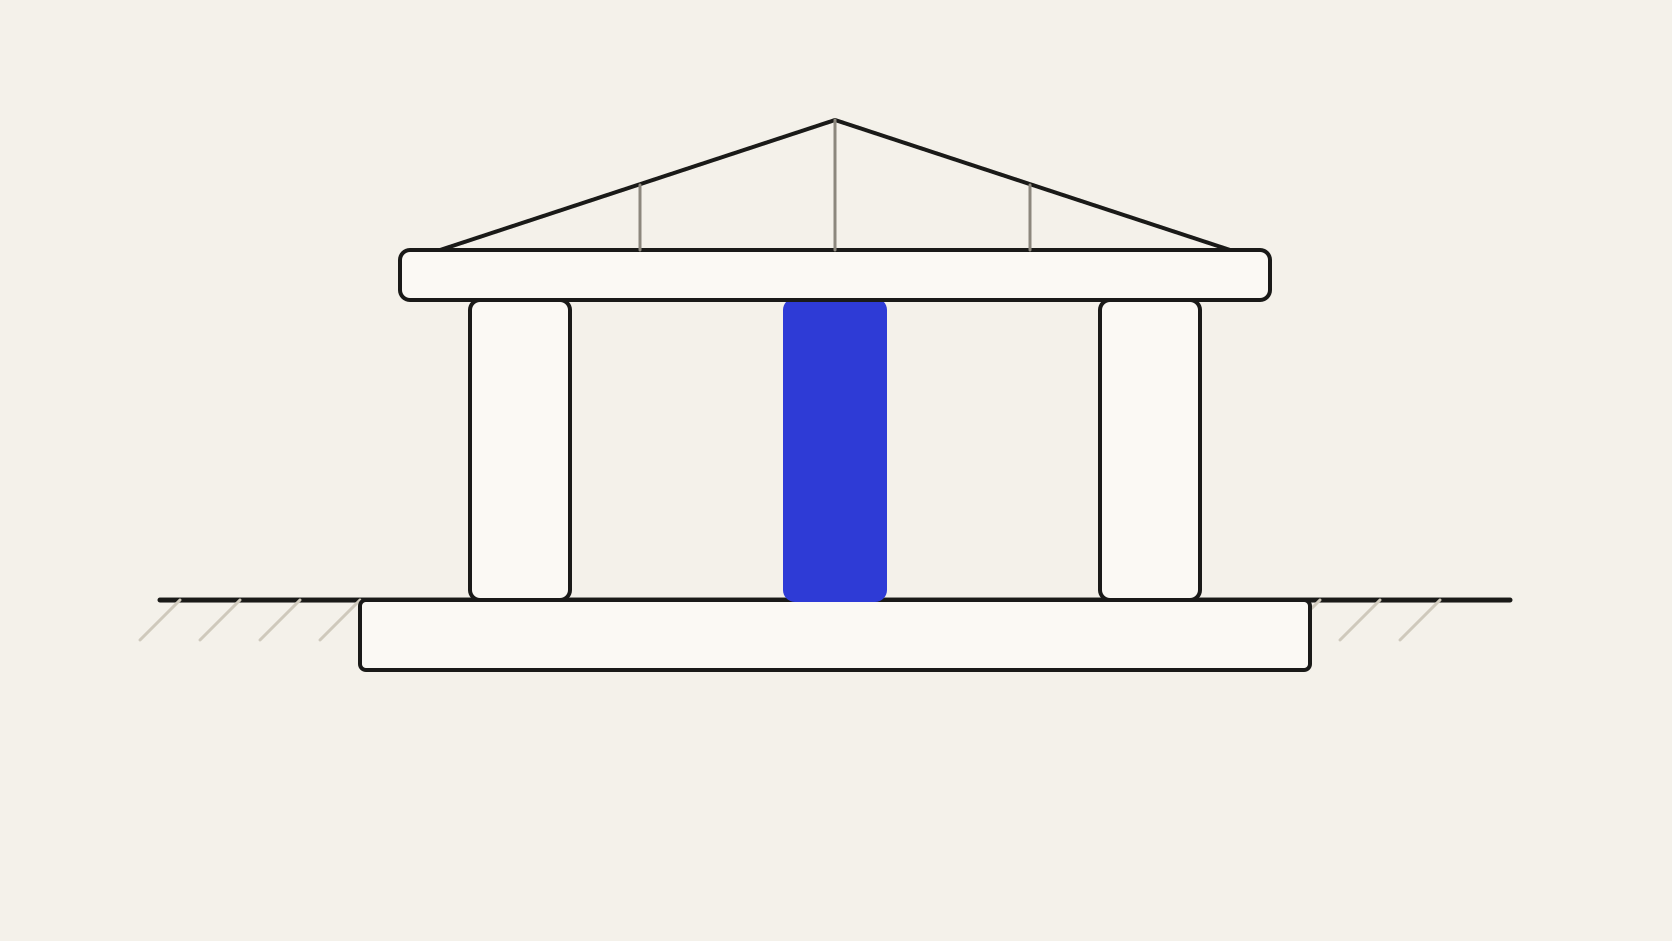
Permissão aplicada antes da recuperação, citação de documento e versão em cada resposta e log de cada consulta. Esses três controles custam pouco quando entram na arquitetura e caro quando entram depois do primeiro incidente. Para setores regulados, o requisito inclui onde a camada roda: o Company Brain roda inteiro na nuvem do cliente.
Detalhei os oito critérios de avaliação no guia O que avaliar em uma infraestrutura de contexto para IA antes de implementar. Para desenhar esses requisitos com o time da Strattum, o caminho é strattum.ai/contato.