
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Um atendente procura na base de conhecimento por cobrança em duplicidade e não encontra nada. O artigo que resolve o caso existe e se chama pagamento lançado duas vezes. A busca por palavra-chave falha porque as duas expressões quase não têm palavras em comum. Os embeddings resolvem esse tipo de desencontro ao representar o sentido do texto em forma numérica, e são a base da busca vetorial. Eles têm lugar no Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Um embedding é um vetor, uma lista longa de números, gerado por um modelo treinado para que conteúdos de sentido parecido recebam vetores parecidos. O conteúdo pode ser uma frase, um documento inteiro, uma imagem ou um registro descrito por seus atributos, como um produto com nome, categoria e descrição.
A técnica moderna ganhou impulso em 2013, com o artigo de pesquisa que propôs arquiteturas para aprender representações vetoriais de palavras a partir de grandes volumes de texto e deu origem ao word2vec. Os modelos atuais aplicam a mesma lógica a trechos inteiros.
Cada vetor pode ser lido como um ponto em um espaço com centenas ou milhares de dimensões. Textos sobre frete ficam em uma região, textos sobre férias em outra, e cobrança em duplicidade fica perto de pagamento lançado duas vezes.
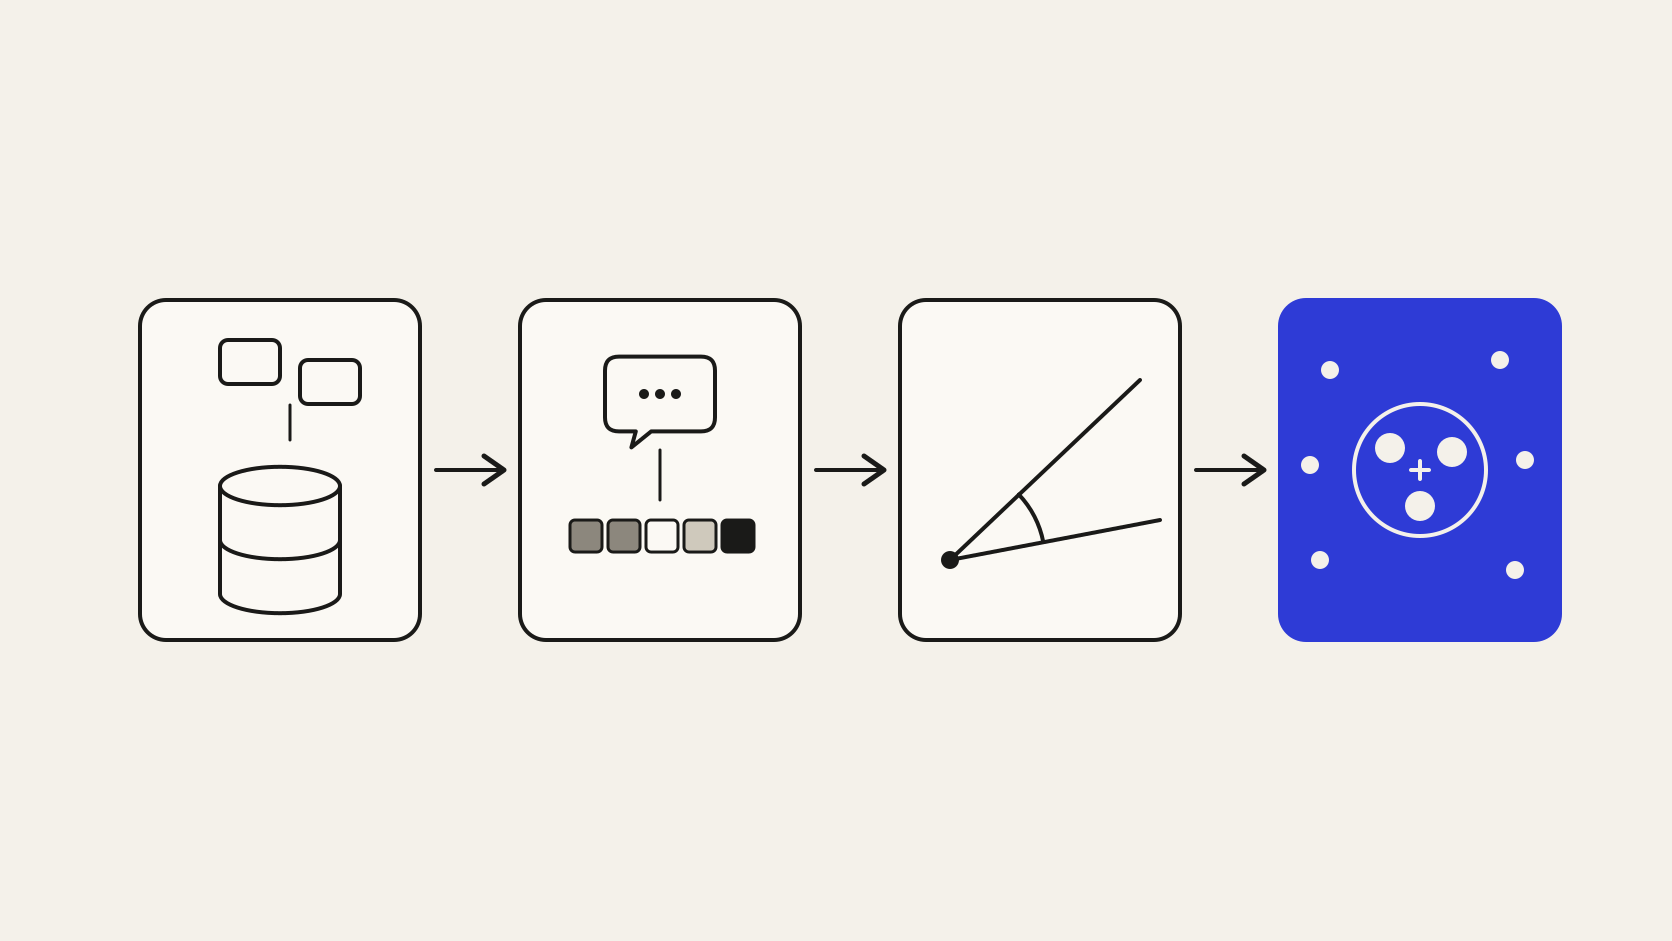
A medida mais usada para comparar dois vetores é a similaridade de cosseno. Ela observa o ângulo entre eles: quanto menor o ângulo, mais próximos os sentidos.
O processo tem quatro etapas:
Comparar a pergunta com cada vetor fica lento quando a base é grande. Por isso, os sistemas usam índices de vizinhos mais próximos aproximados, que examinam apenas as regiões mais promissoras do espaço. A busca aceita uma pequena perda de precisão em troca de respostas rápidas.
O banco de vetores é o sistema que guarda essas representações, mantém os índices aproximados e permite filtrar o resultado por metadados.
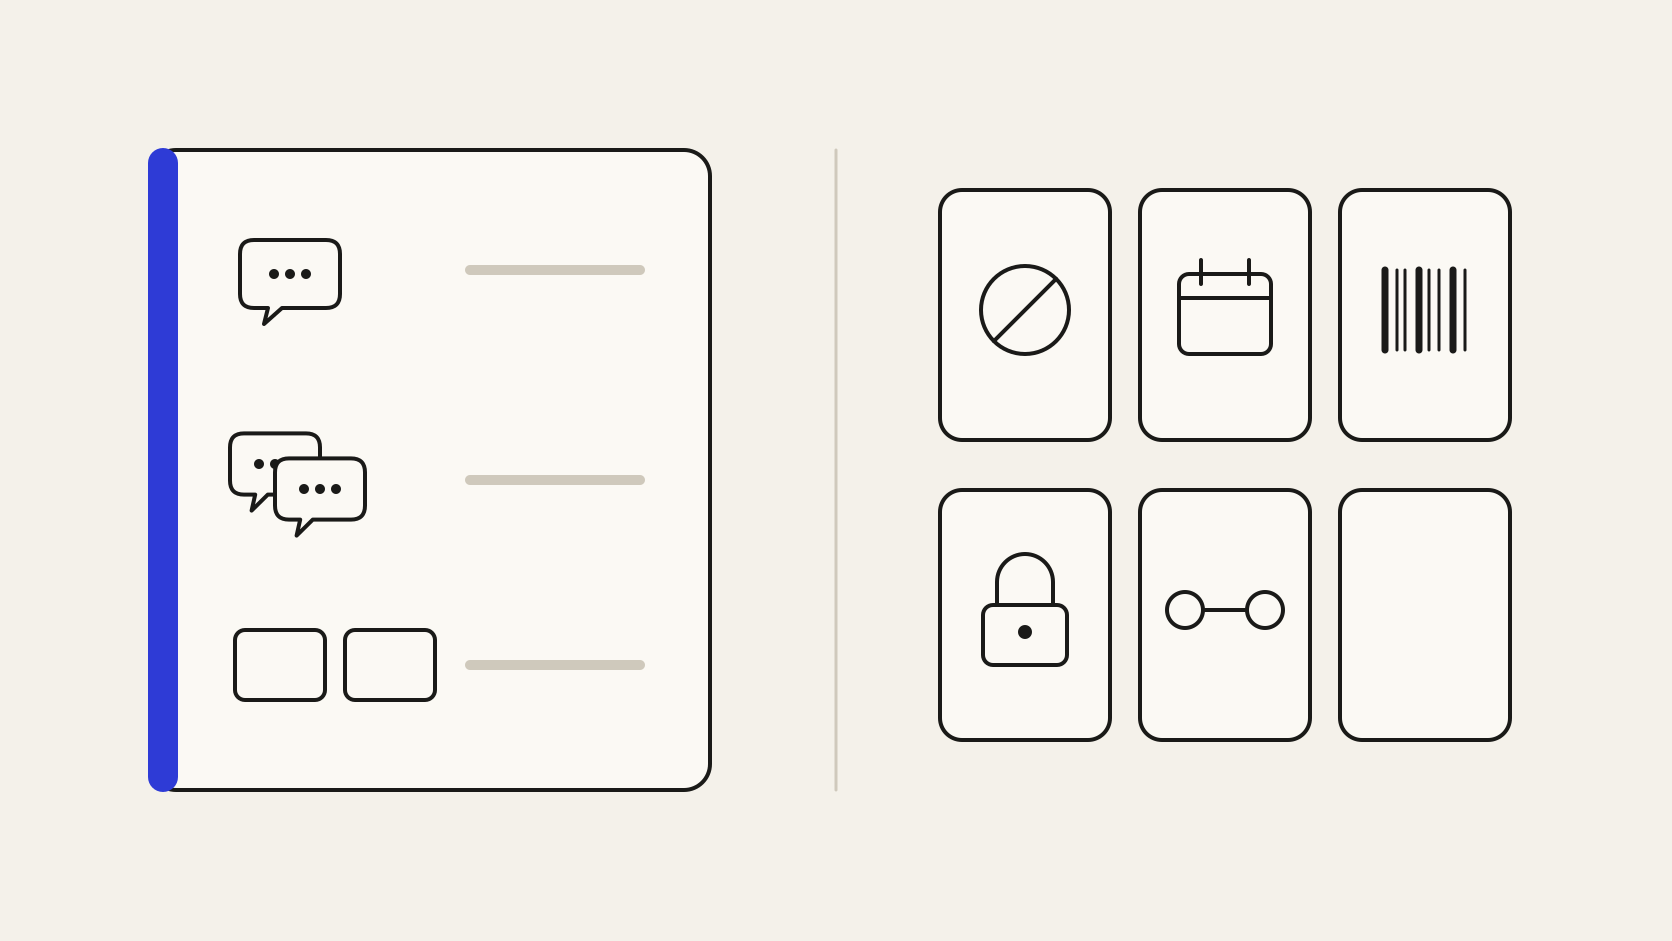
As aplicações mais sólidas exploram a proximidade de significado:
Um vetor captura o assunto e o tom de um conteúdo. Detalhes que mudam o fato e preservam o assunto pesam pouco nele:
O custo de uma base vetorial aparece em três momentos. O primeiro é a indexação inicial, em que cada item passa pelo modelo. O segundo é a atualização, porque cada versão nova de um documento ou registro precisa de um vetor novo.
O terceiro é a troca de modelo. Vetores de modelos diferentes ocupam espaços diferentes e não podem ser comparados. Adotar um modelo de embeddings mais preciso significa reprocessar todo o acervo, recalcular índices e revalidar a busca. Bases espalhadas por vários projetos multiplicam esse custo.
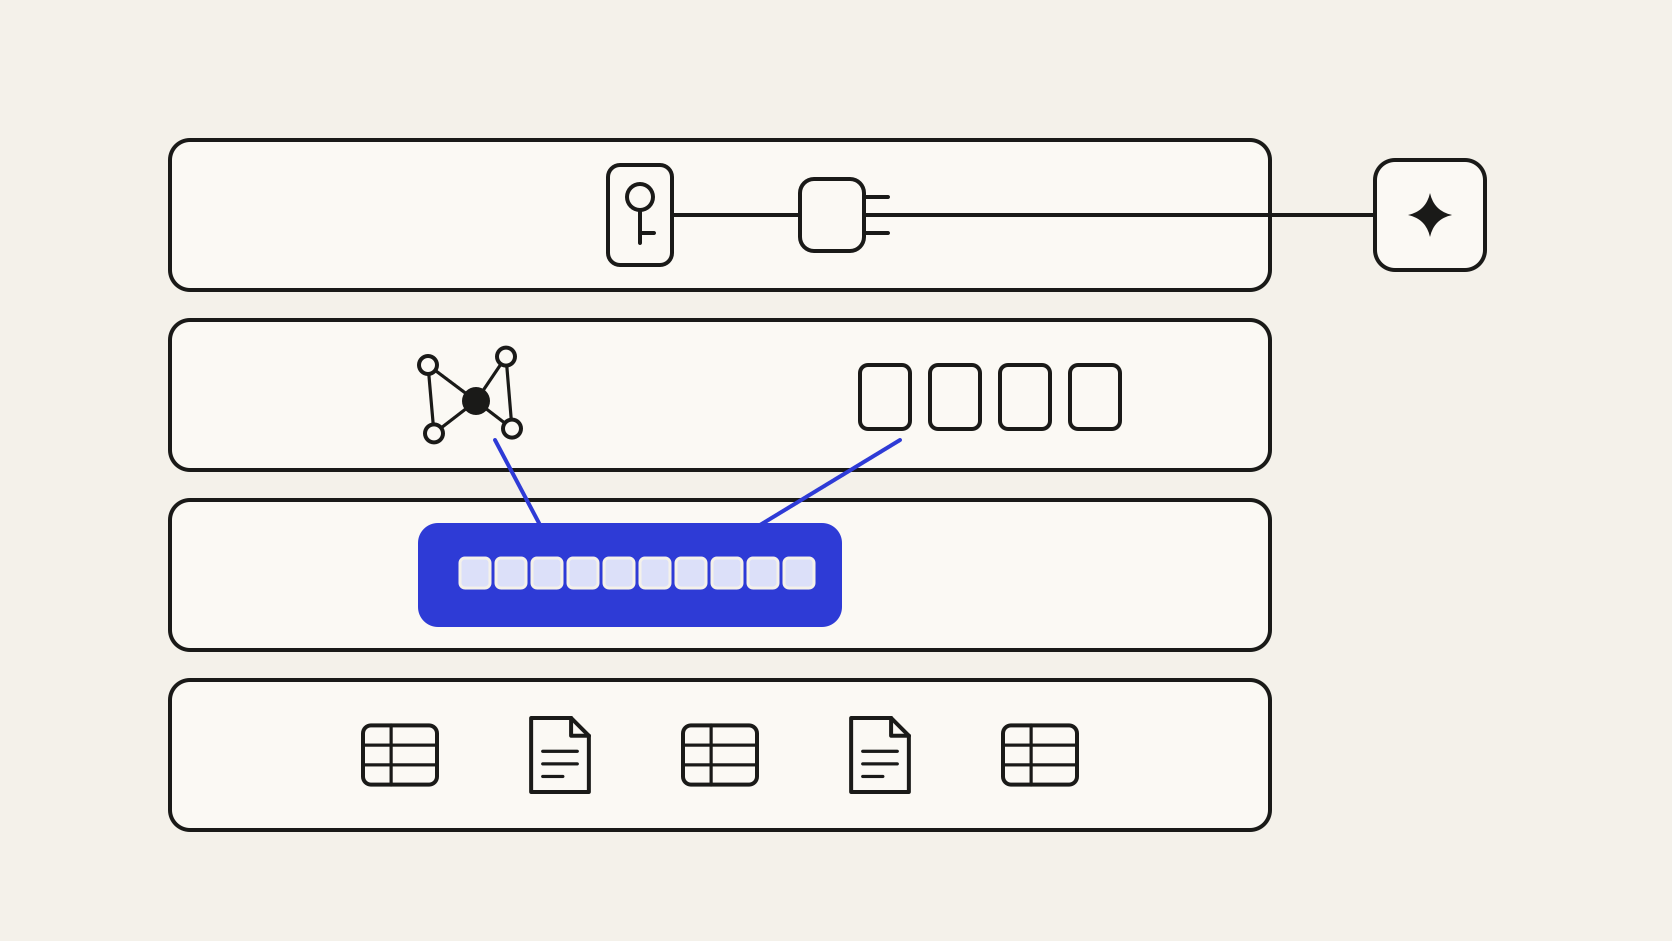
No Company Brain, as representações vetoriais são uma das ferramentas da camada semântica. Quando a pergunta chega em linguagem natural, os vetores ajudam a ligar as palavras de quem perguntou aos termos da ontologia do negócio. Cobrança em duplicidade chega à categoria de chamado certa sem coincidência de palavras.
Os vetores também apoiam a resolução de entidades. Eles sugerem cadastros candidatos a representar o mesmo fornecedor ou o mesmo produto, e a decisão final fica com regras determinísticas e com revisão humana nos casos ambíguos.
O restante fica com estruturas exatas. O grafo de conhecimento guarda as relações entre registros, a ontologia define o que cada termo significa e a permissão é herdada do sistema de origem. O modelo recebe via MCP apenas o recorte que a pergunta exige, com a fonte de cada item, e o prompt menor reduz o custo por resposta. Como a base vetorial é mantida em um lugar só, a troca do modelo de embeddings acontece uma vez para todos os casos de uso.
O ponto de partida prático é uma base de texto em que as pessoas procuram a mesma coisa com palavras diferentes, como a base de conhecimento do suporte. O registro das buscas sem resultado mostra onde a busca semântica tem mais a acrescentar.
Desde o primeiro índice, cada vetor deve ser gravado com a fonte, a versão do conteúdo, a regra de acesso de origem e o nome do modelo que o gerou. Esses metadados permitem filtrar por permissão, atualizar apenas o que mudou e planejar a próxima troca de modelo com o custo conhecido.