
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Quando uma empresa começa a usar modelos de linguagem com os próprios dados, a primeira arquitetura costuma ser a mesma. Os documentos são divididos em trechos, cada trecho vira um vetor numérico e, a cada pergunta, o sistema busca os trechos mais parecidos e os envia ao modelo junto com a pergunta. Essa técnica se chama RAG, sigla em inglês para geração aumentada por recuperação. Ela resolve uma parte importante do problema de contexto e é uma das fontes que alimentam o Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
O termo foi apresentado em 2020, em um artigo de pesquisadores do Facebook AI Research, da University College London e da New York University que propôs combinar um modelo gerador com um índice de documentos consultado a cada resposta. A ideia central é separar o que o modelo aprendeu no treinamento do conhecimento que ele consulta no momento da pergunta.
Na prática corporativa, o pipeline tem quatro etapas:
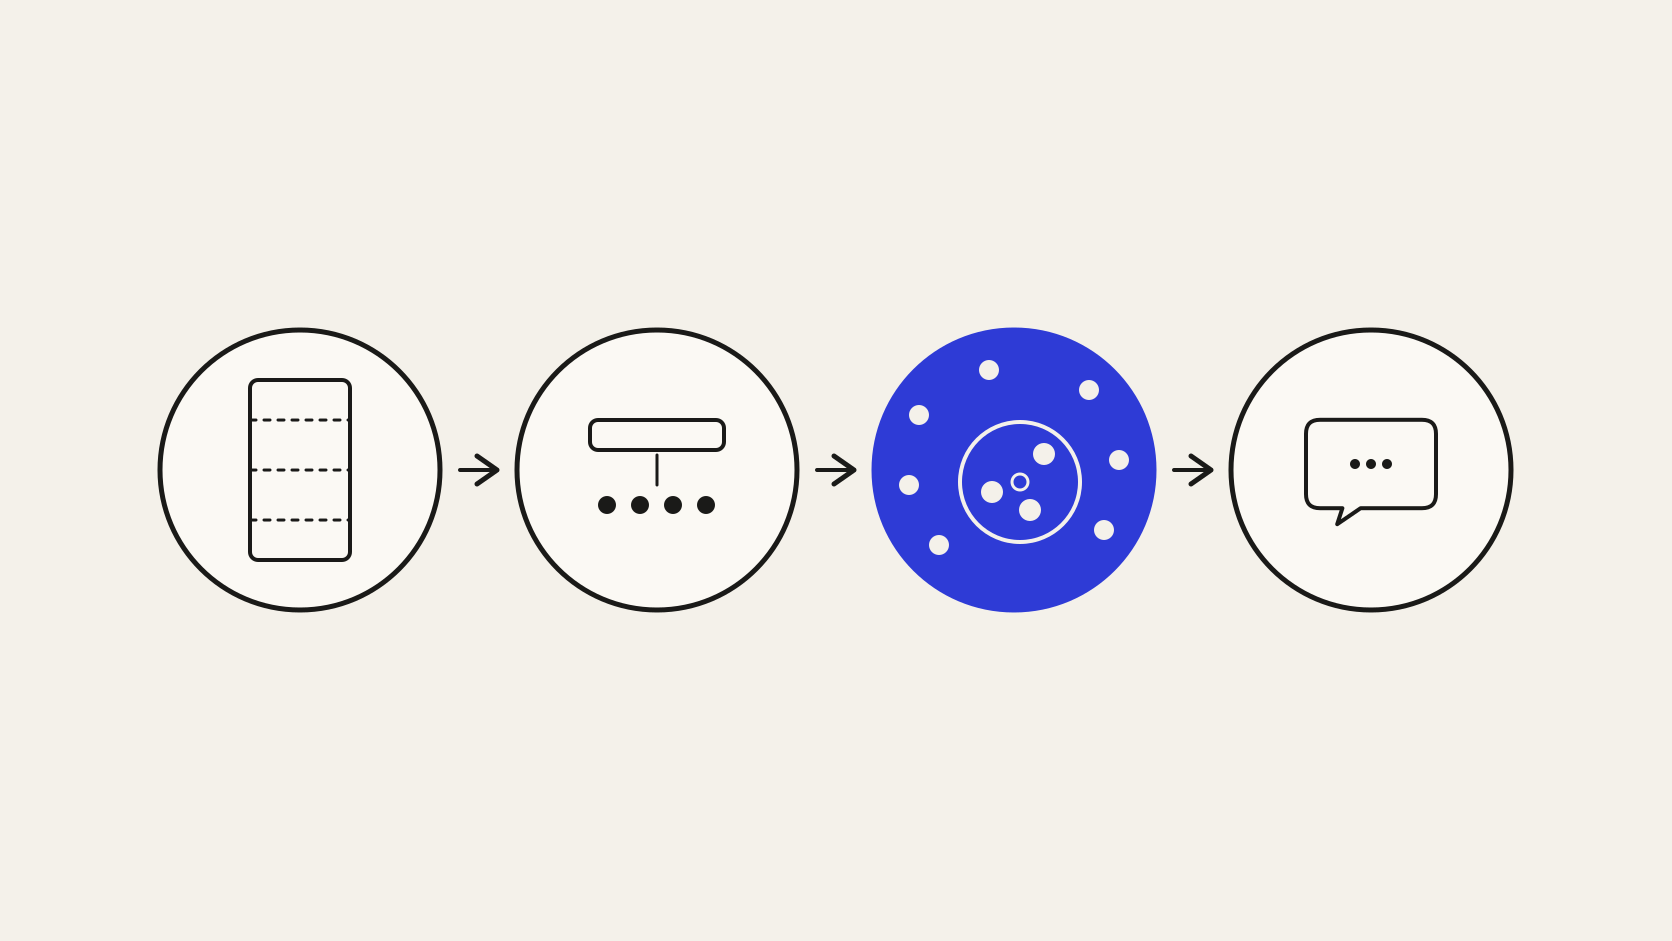
A recuperação de trechos tem um ponto forte claro: perguntas cuja resposta está escrita em algum documento. Qual é a política de reembolso, o que diz o manual de integração de um produto, qual é o procedimento para abrir um chamado de segurança. Nesses casos, o trecho certo contém a resposta, e o modelo precisa apenas reformulá-la.
Ela também é relativamente simples de implantar. Uma base de documentos pode ser indexada sem alterar os sistemas de origem, o que explica por que o RAG aparece em tantos pilotos.
Boa parte das perguntas de negócio depende de dado que não está em documento. Quantos pedidos deste cliente atrasaram no trimestre, qual SLA foi contratado para este tipo de chamado, quais contas têm renovação próxima e chamado crítico aberto. A resposta está em registros do ERP, do CRM e do helpdesk, e na relação entre eles.
A busca por semelhança foi desenhada para encontrar texto parecido com a pergunta. Uma pergunta sobre pedidos atrasados pode recuperar o trecho da política de prazos de entrega, que se parece com a pergunta e não contém o número. O modelo recebe um contexto relevante na forma e insuficiente no conteúdo, e completa a lacuna com a continuação mais provável.
Há também a fragmentação. Um contrato dividido em trechos perde a ligação entre a cláusula de desconto e o anexo que define a tabela de preços. O trecho recuperado está certo, e a resposta sai incompleta.
Variações da técnica, como a busca híbrida, que combina palavras-chave e vetores, e o reranqueamento dos trechos recuperados, melhoram a precisão. Elas tornam o RAG melhor em encontrar o texto certo e continuam dependentes de que a resposta esteja escrita em algum lugar.
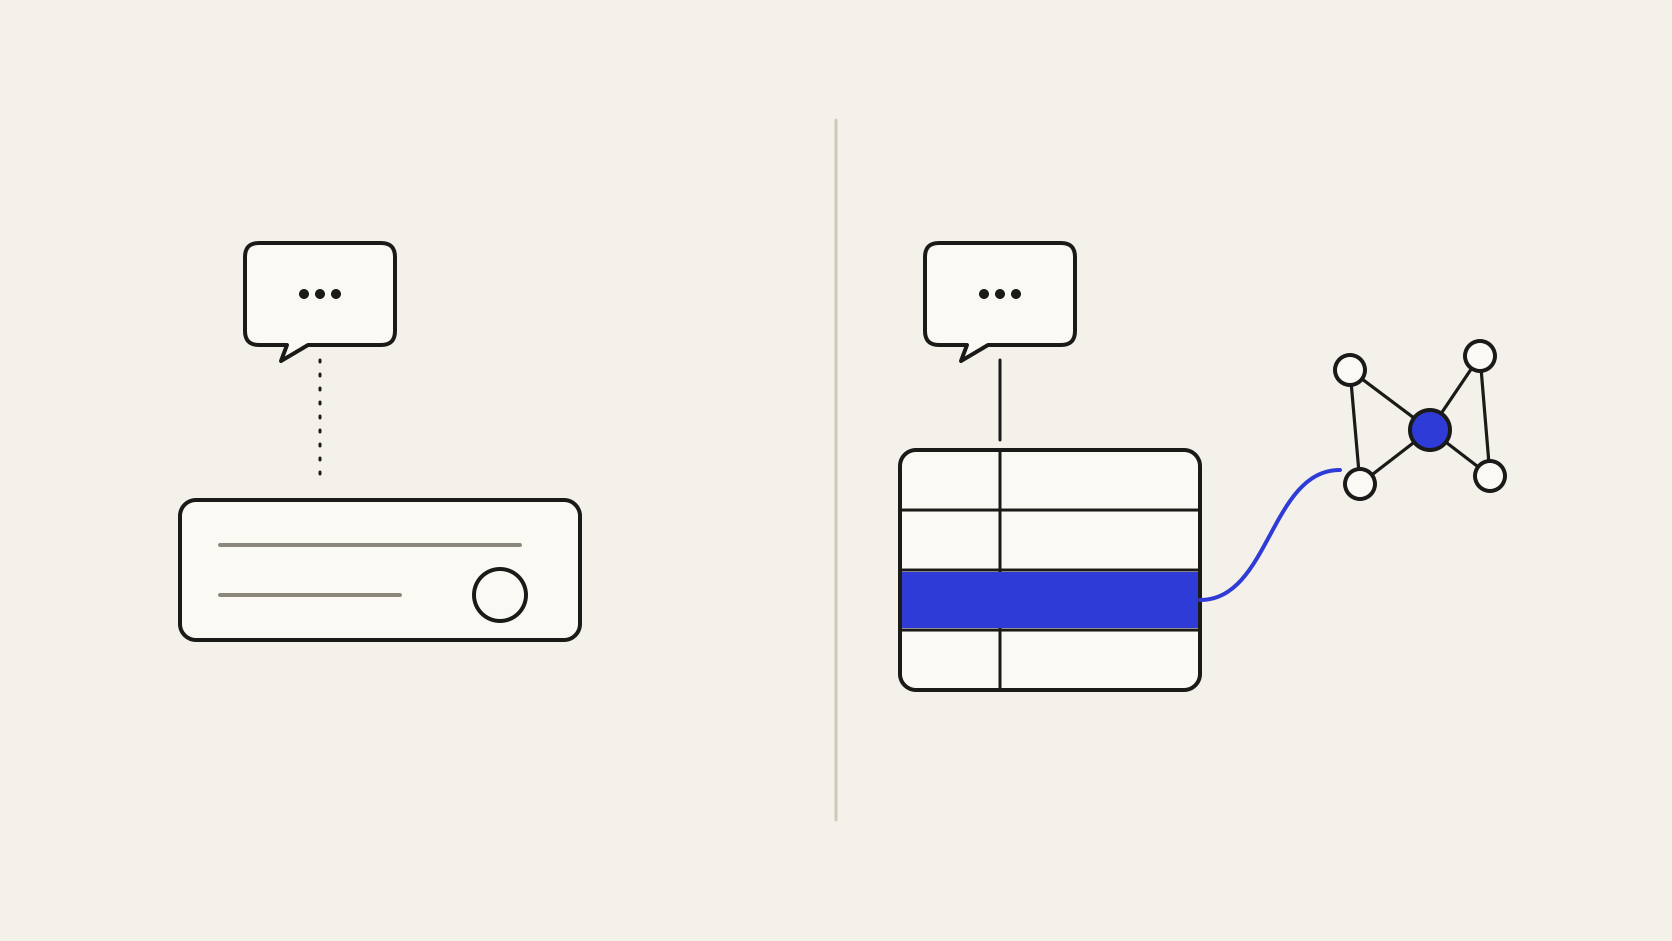
O primeiro projeto de RAG costuma ser desenhado para uma base e um tipo de pergunta. No segundo caso de uso, a empresa descobre que precisa de outra base, outra estratégia de divisão de trechos, outros filtros e outro controle de acesso. Cada novo projeto reconstrói a integração do zero.
Esse retrabalho tem custo direto em tokens. Para compensar a falta de precisão, os pipelines aumentam o número de trechos enviados ao modelo, e o prompt cresce. Mais texto por chamada significa custo maior por resposta e, muitas vezes, a necessidade de um modelo mais caro para lidar com o volume.
O efeito aparece também na manutenção. Cada base indexada precisa ser atualizada quando os documentos mudam, e um RAG que indexou a versão anterior de uma política continua respondendo com ela até a próxima reindexação. Com várias bases independentes, ninguém sabe ao certo qual versão cada assistente está usando.
Um índice vetorial guarda trechos sem o contexto de quem pode ver cada um. Se a política salarial e o manual de onboarding estão no mesmo índice, a busca pode recuperar o trecho restrito para quem não deveria acessá-lo. O controle de acesso trecho a trecho, sincronizado com as permissões dos sistemas de origem, costuma ficar fora do piloto de RAG e voltar como obstáculo na aprovação de segurança.
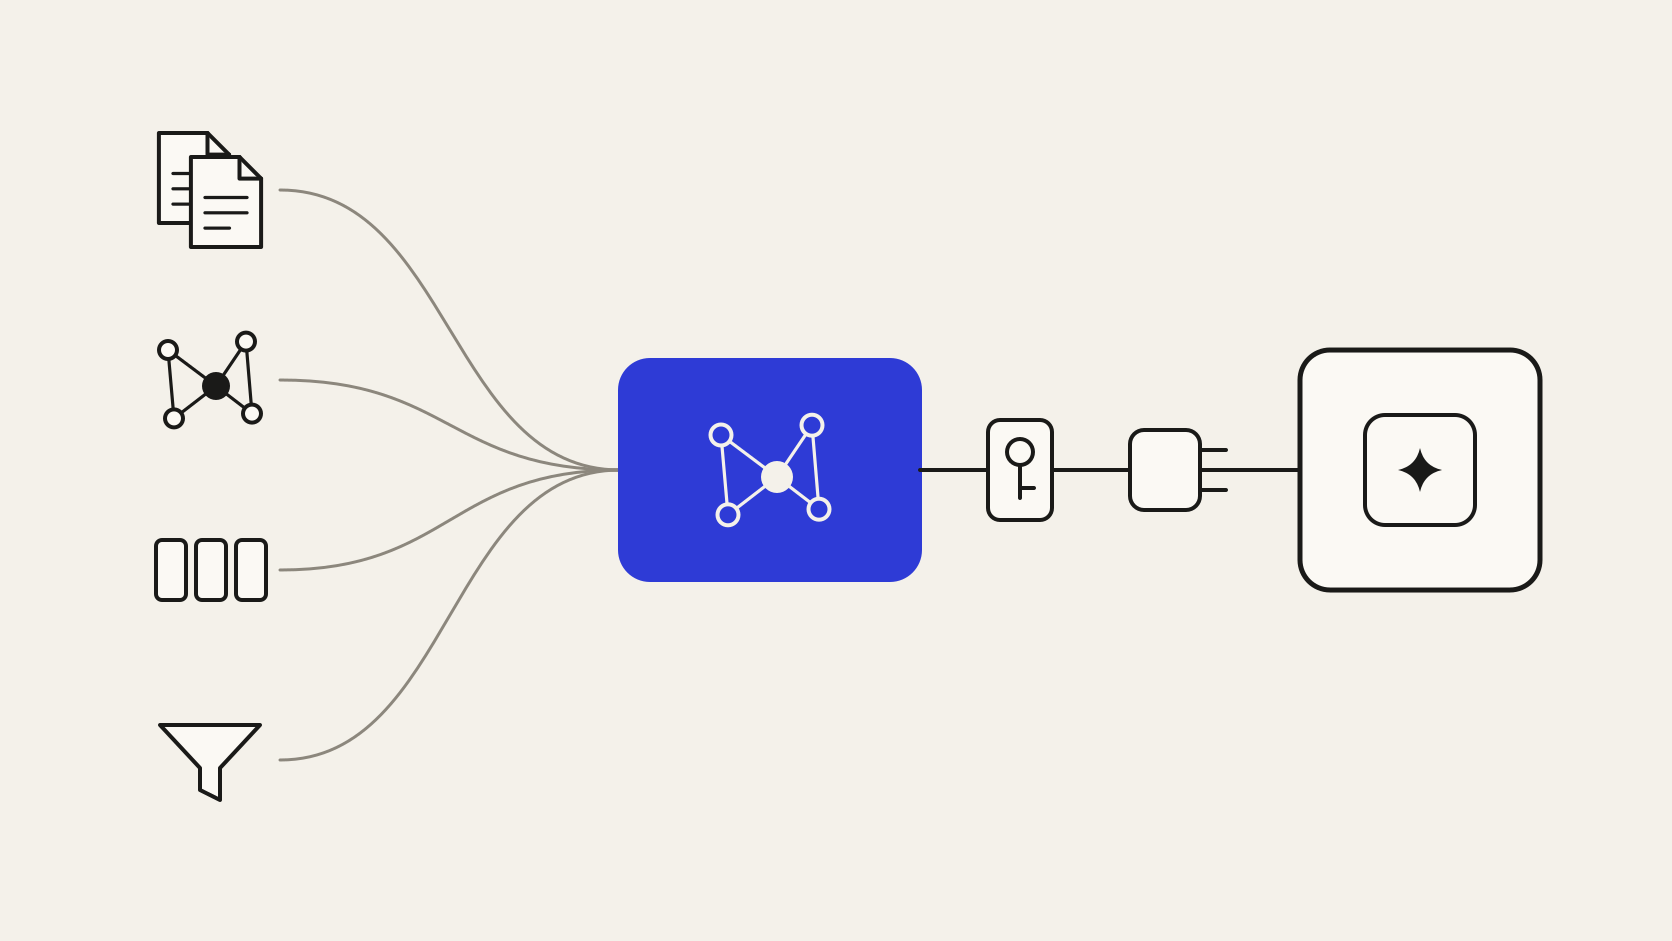
A busca em documentos continua útil. No Company Brain, ela opera ao lado do grafo de conhecimento, da ontologia do negócio e da camada semântica. Quando a pergunta depende de texto, a camada semântica aciona a recuperação de trechos. Quando depende de registro, consulta a fonte estruturada. Quando depende dos dois, como saber qual cláusula se aplica ao pedido atrasado de um cliente, combina as duas e liga o trecho do contrato à entidade certa no grafo.
A permissão é herdada do sistema de origem nos dois caminhos, e o contexto é servido ao modelo via MCP com a fonte de cada informação. O prompt recebe apenas o recorte que a pergunta exige, o que reduz tokens e permite rodar a mesma tarefa em modelos de custo menor.
Para empresas que já têm um RAG em produção, o ponto de partida é listar as perguntas em que ele falha. Com frequência, elas dependem de um registro estruturado ou da relação entre dois sistemas, e indicam onde o primeiro recorte do Company Brain deve começar.