
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Cada agente de IA que entra em produção precisa ler dados de algum lugar: o CRM, o ERP, o helpdesk, o repositório de código. Por muito tempo, cada ligação foi escrita sob medida, para uma aplicação e um sistema específicos. O MCP, sigla para Model Context Protocol, padroniza essa ligação. Ele é um protocolo aberto que define como modelos e agentes de IA se conectam a fontes de dados e ferramentas. Para quem não é da área técnica, funciona como uma tomada comum entre as aplicações de IA e os sistemas da empresa. É também o canal pelo qual o Company Brain, a camada que conhece a empresa (quais dados existem, onde vivem, como se relacionam e quem pode ver o quê), chega aos modelos.
O MCP foi lançado como padrão aberto em novembro de 2024, com especificação pública, kits de desenvolvimento em várias linguagens e servidores de referência. Desde então, passou a ser suportado por assistentes, ambientes de desenvolvimento e plataformas de agentes de diferentes fornecedores.
A consequência prática é a portabilidade. Um conector escrito uma vez para o sistema de chamados atende qualquer aplicação que fale o protocolo, e a troca de modelo deixa as integrações intactas.
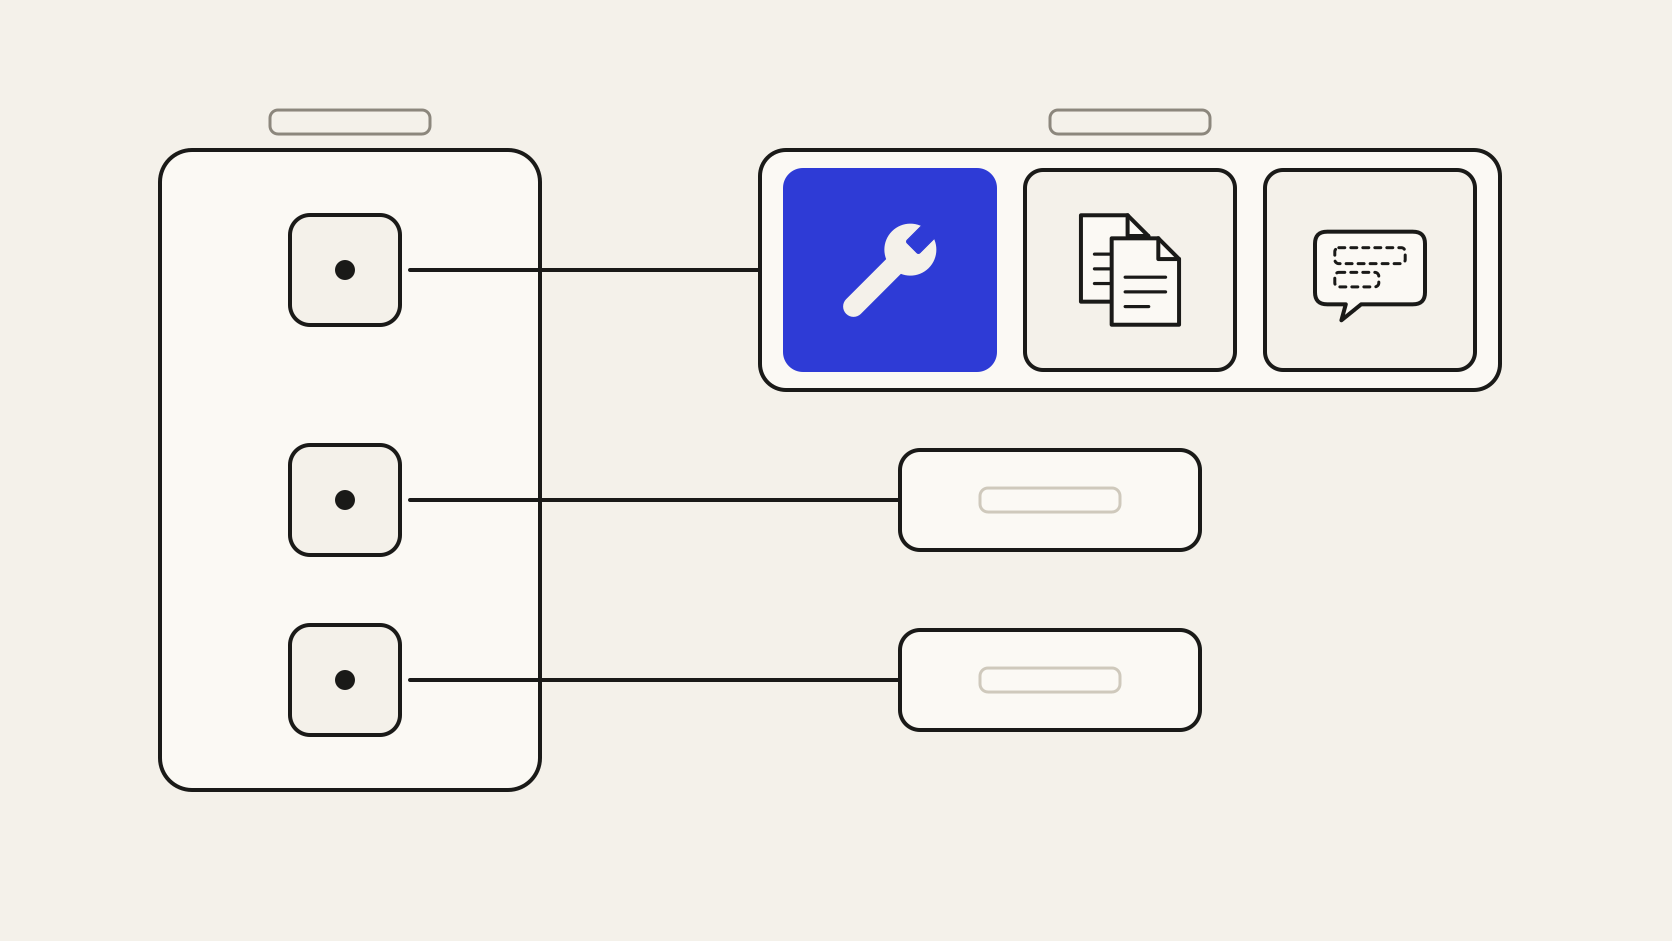
A documentação oficial descreve uma arquitetura cliente-servidor com três participantes. O host é a aplicação de IA, como um assistente ou um ambiente de desenvolvimento. Para cada fonte, o host cria um cliente, que mantém uma conexão dedicada com um servidor. O servidor é o programa que expõe os dados e as ações de um sistema.
Cada servidor oferece três primitivas:
O cliente descobre o que cada servidor oferece por meio de listagens, e o host decide o que entra na chamada ao modelo. As mensagens seguem o padrão JSON-RPC 2.0 e trafegam por entrada e saída padrão, quando o servidor roda na mesma máquina, ou por HTTP, quando o servidor é remoto.
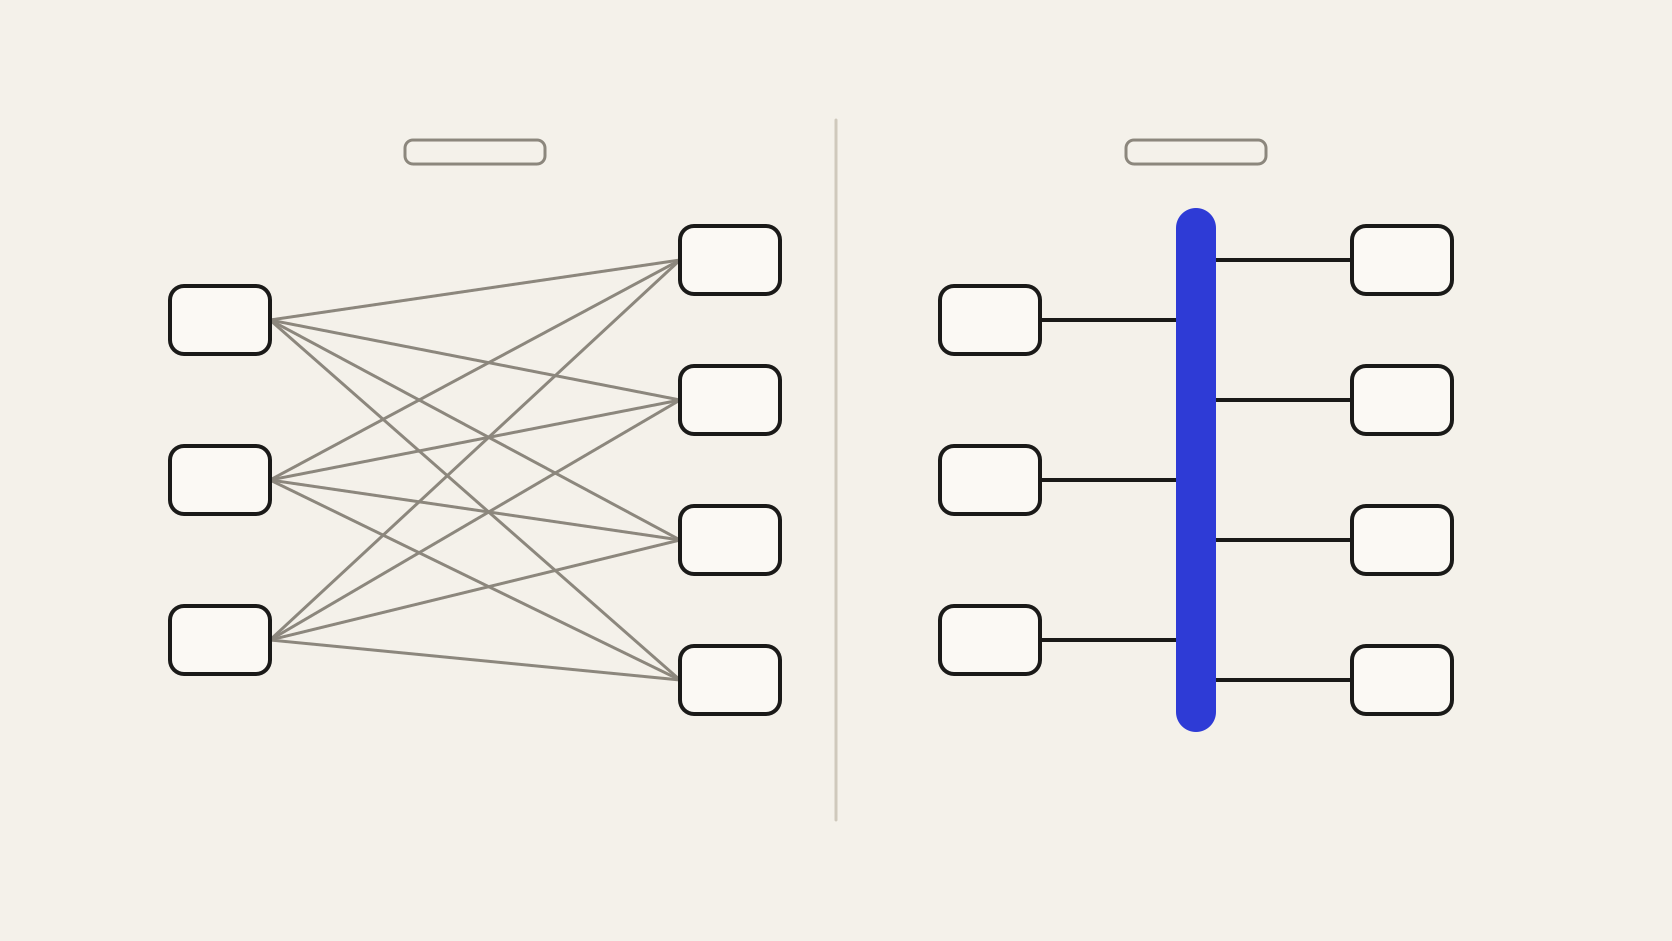
Sem um padrão, cada aplicação de IA precisa de um conector próprio para cada sistema. Com N aplicações e M sistemas, a empresa mantém N vezes M integrações, cada uma com autenticação, formato de dados e tratamento de erro escritos à parte.
Com o MCP, cada sistema ganha um servidor e cada aplicação implementa um cliente. O total cai para N mais M, e o servidor do ERP escrito para o primeiro agente atende também o segundo. É daí que vem o ganho de velocidade de implementação: o projeto seguinte parte de conexões que já existem.
O MCP padroniza o transporte do contexto. A própria documentação registra que ele não define como as aplicações usam os modelos nem como gerenciam o contexto recebido. O que o dado significa e como ele se liga ao dado de outro sistema fica a cargo de quem implementa cada lado.
Na prática, um agente ligado a dez servidores crus recebe dez visões parciais da empresa. O servidor do e-commerce devolve o pedido pelo número da loja, o do ERP pela nota fiscal e o da transportadora pelo código de rastreio. Nenhum deles sabe que os três registros descrevem a mesma entrega. Três lacunas aparecem em seguida:
Há também o custo. Cada servidor acrescenta descrições de ferramentas à janela do modelo, e o agente gasta chamadas e tokens juntando as partes antes de responder.
No Company Brain, as fontes são conectadas uma vez e organizadas antes de chegar ao protocolo. O grafo de conhecimento liga o pedido da loja, a nota do ERP e o rastreio da transportadora à mesma entrega. A ontologia do negócio define o que cada status significa. A camada semântica traduz a pergunta em linguagem natural para a consulta certa.
O agente se conecta a um único servidor e recebe o recorte que a pergunta exige, com as entidades já resolvidas e a fonte de cada informação. Um agente novo ou um modelo diferente precisa apenas de outro cliente do protocolo, e o contexto continua o mesmo.
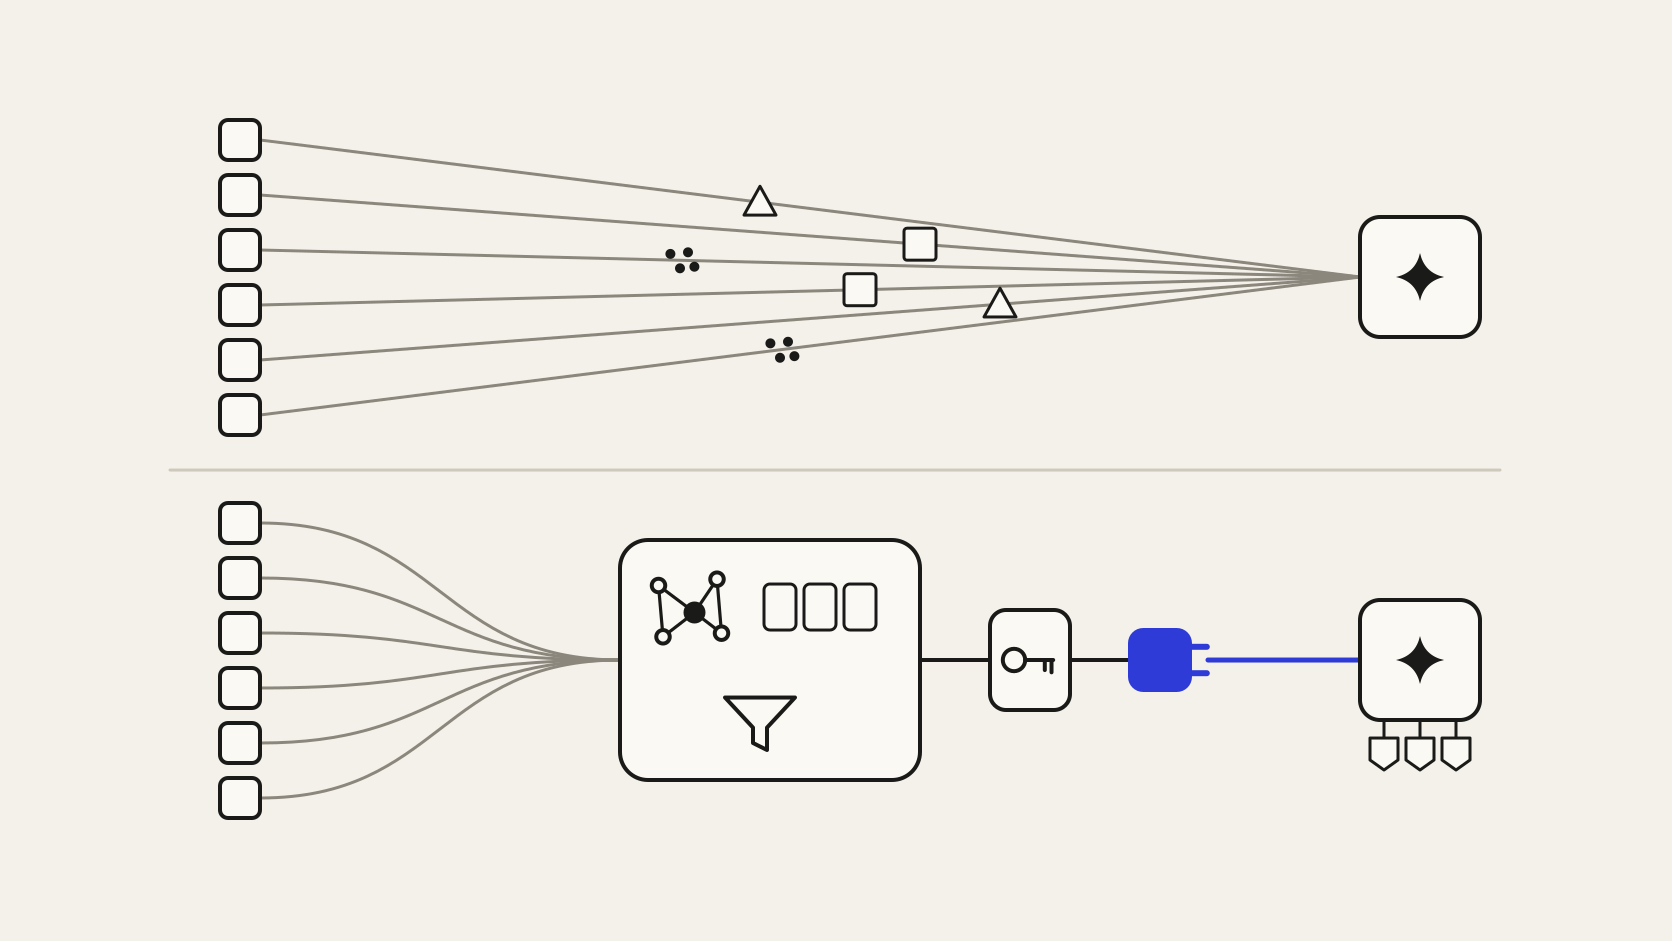
O MCP cuida da autenticação da conexão, e a especificação recomenda OAuth para servidores remotos. A decisão sobre qual registro cada pessoa pode ver acontece no Company Brain. Cada consulta carrega a identidade de quem perguntou, e a permissão é herdada do sistema de origem: a analista de logística recebe as entregas da própria região, e a diretora de operações recebe todas.
Os dados permanecem nos sistemas da empresa, e o modelo recebe a cada chamada apenas o recorte autorizado. Servidores de terceiros instalados sem revisão continuam sendo um ponto de exposição, por isso a área de segurança precisa manter a lista dos servidores aprovados e das credenciais que cada um usa.
O ponto de partida prático é inventariar as integrações de IA que já existem e as que estão no plano. Quando duas ou mais dependem dos mesmos sistemas, o retrabalho já está contratado.
O passo seguinte é escolher uma pergunta recorrente que atravessa dois ou três sistemas, como a situação completa de uma entrega atrasada, e servi-la por um único ponto de contexto. Os agentes seguintes se conectam ao mesmo servidor e reaproveitam as fontes, as entidades e as permissões já resolvidas.