
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma gerente de suprimentos quer saber quais fornecedores que atrasaram entregas no último semestre também abastecem as linhas de produção com mais pedidos em carteira. A resposta depende de seguir uma cadeia de relações: fornecedor, pedido de compra, componente, linha de produção. O RAG tradicional recupera trechos parecidos com a pergunta e para aí. O GraphRAG é a variação que monta o contexto percorrendo um grafo de entidades e relações. Ele conversa diretamente com o Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
No RAG tradicional, a unidade de recuperação é o trecho de texto mais parecido com a pergunta. No GraphRAG, a unidade de recuperação é a entidade e a vizinhança dela no grafo: o fornecedor, os pedidos ligados a ele, os componentes desses pedidos e as linhas que consomem esses componentes.
O processo tem três passos. O sistema identifica as entidades citadas na pergunta, localiza essas entidades no grafo e expande o recorte pelas relações relevantes. O subgrafo resultante, acompanhado dos textos associados a cada nó, entra no prompt.
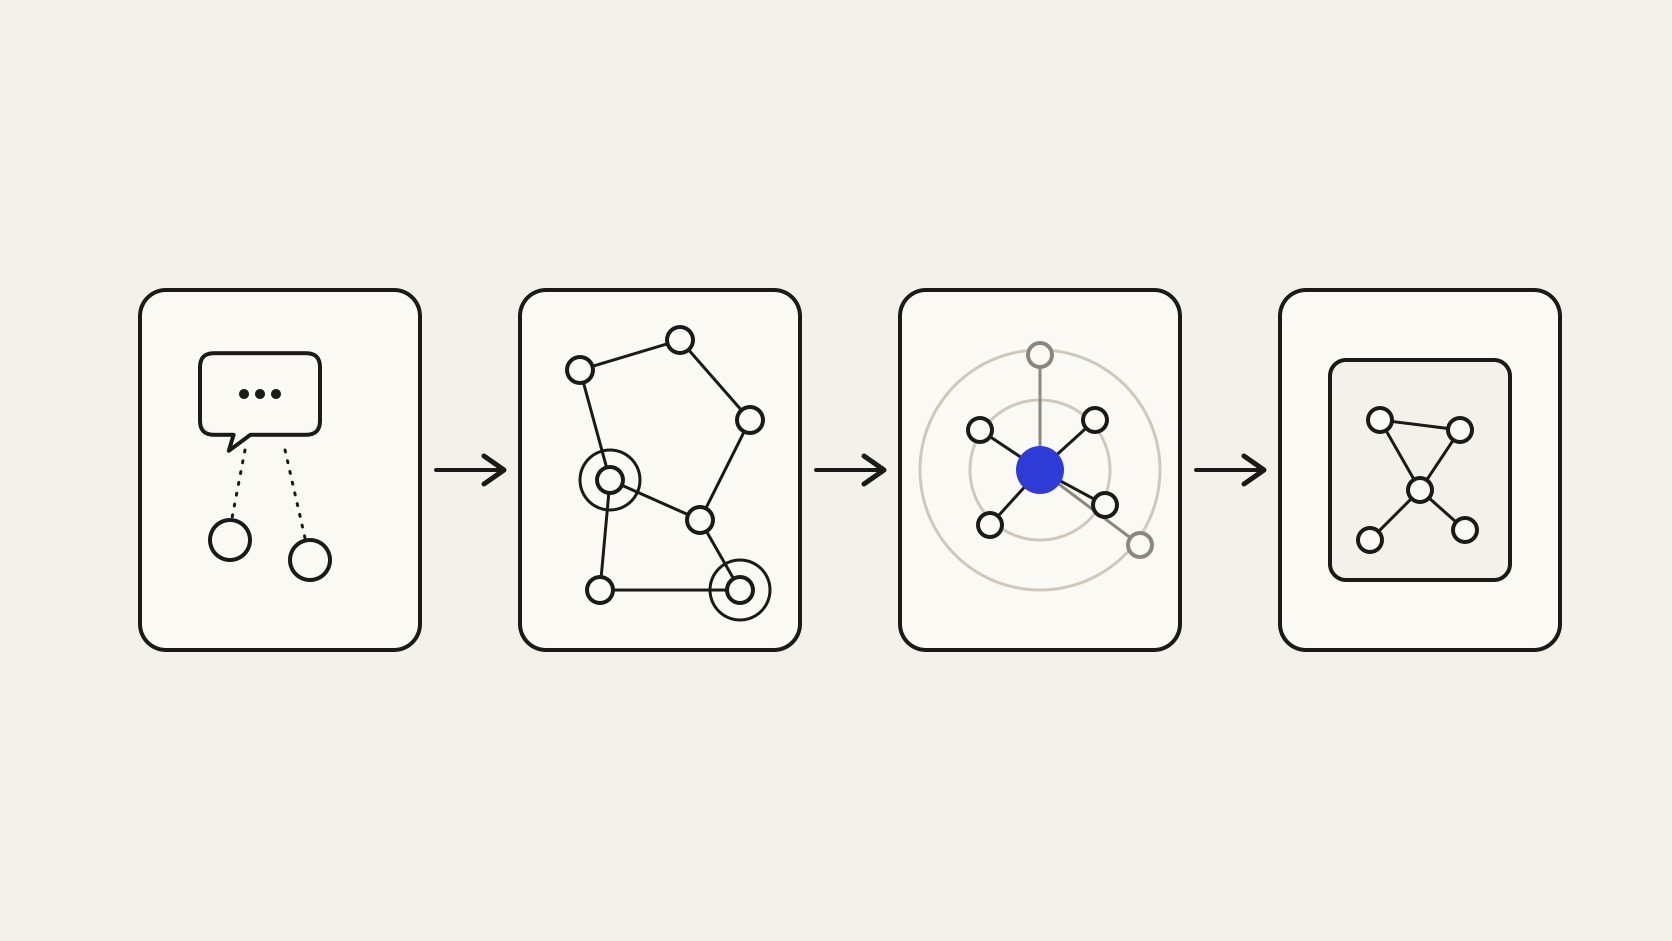
A abordagem ganhou nome quando pesquisadores da Microsoft Research propuseram um índice em forma de grafo para responder perguntas sobre coleções inteiras de documentos e chamaram o método de GraphRAG. O estudo partia de uma limitação conhecida: o RAG tradicional falha em perguntas globais, como quais são os temas principais de um conjunto de textos, porque nenhum trecho isolado contém essa resposta.
A proposta usa um LLM para extrair entidades e relações dos documentos e agrupa as entidades mais ligadas entre si em comunidades. Cada comunidade recebe um resumo gerado previamente. Diante de uma pergunta global, o sistema combina esses resumos em uma resposta única. Nos testes do estudo, essas respostas ficaram mais completas e mais diversas que as do RAG tradicional.
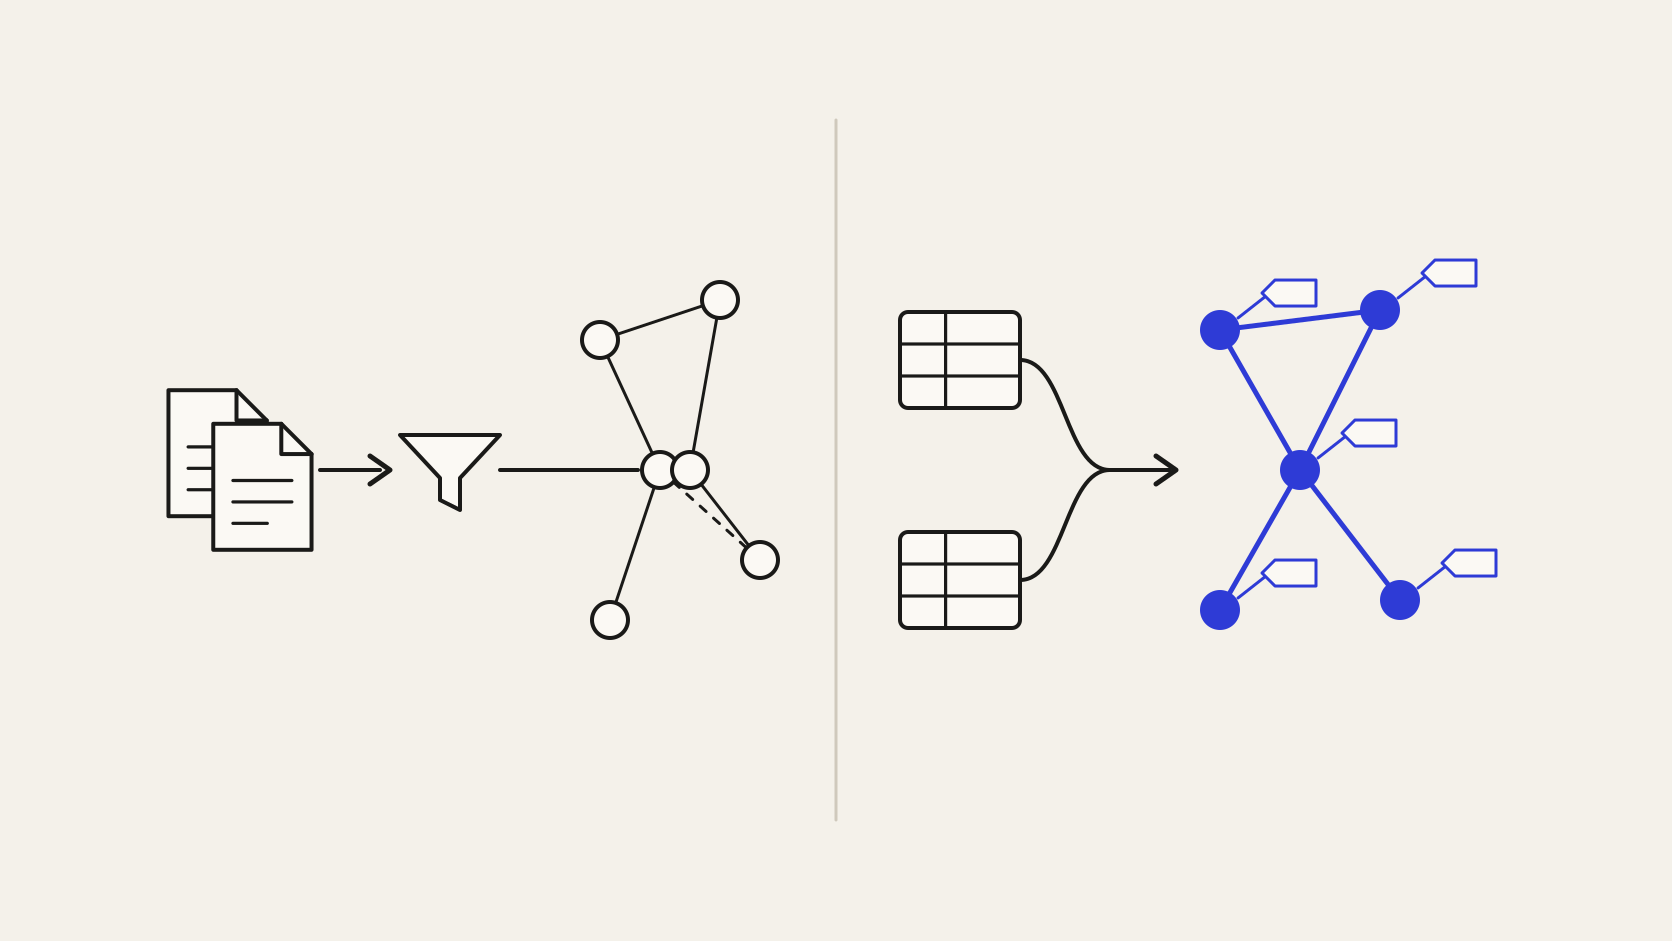
As implementações se dividem pela origem do grafo:
As duas variantes podem coexistir. Na primeira, cada nó é uma inferência do modelo extrator. Na segunda, cada nó corresponde a um registro com dono e origem conhecidos.
A vantagem aparece em três tipos de pergunta:
Em perguntas pontuais, cuja resposta está escrita em um parágrafo, o RAG tradicional costuma bastar e custa menos.
A variante do GraphRAG que extrai o grafo de documentos herda as imprecisões do modelo extrator. O mesmo fornecedor aparece como três nós porque foi escrito com sigla, sem sigla e pelo nome fantasia. Uma relação é criada porque dois nomes apareceram no mesmo parágrafo, sem que o texto afirmasse vínculo entre eles. Cada erro desse tipo se propaga para todas as respostas que passam pelo nó.
Há também o custo de indexação. Cada documento passa por chamadas ao modelo para a extração, e os resumos de comunidade exigem outras chamadas. Quando os documentos mudam, a extração precisa rodar de novo, e o grafo desatualizado continua respondendo com as relações antigas.
Há ainda a governança. Um grafo extraído mistura documentos com níveis de acesso diferentes. Uma relação inferida de um parecer jurídico restrito pode aparecer na resposta de alguém que nunca teve acesso ao parecer, e o grafo raramente registra de qual trecho cada aresta saiu.
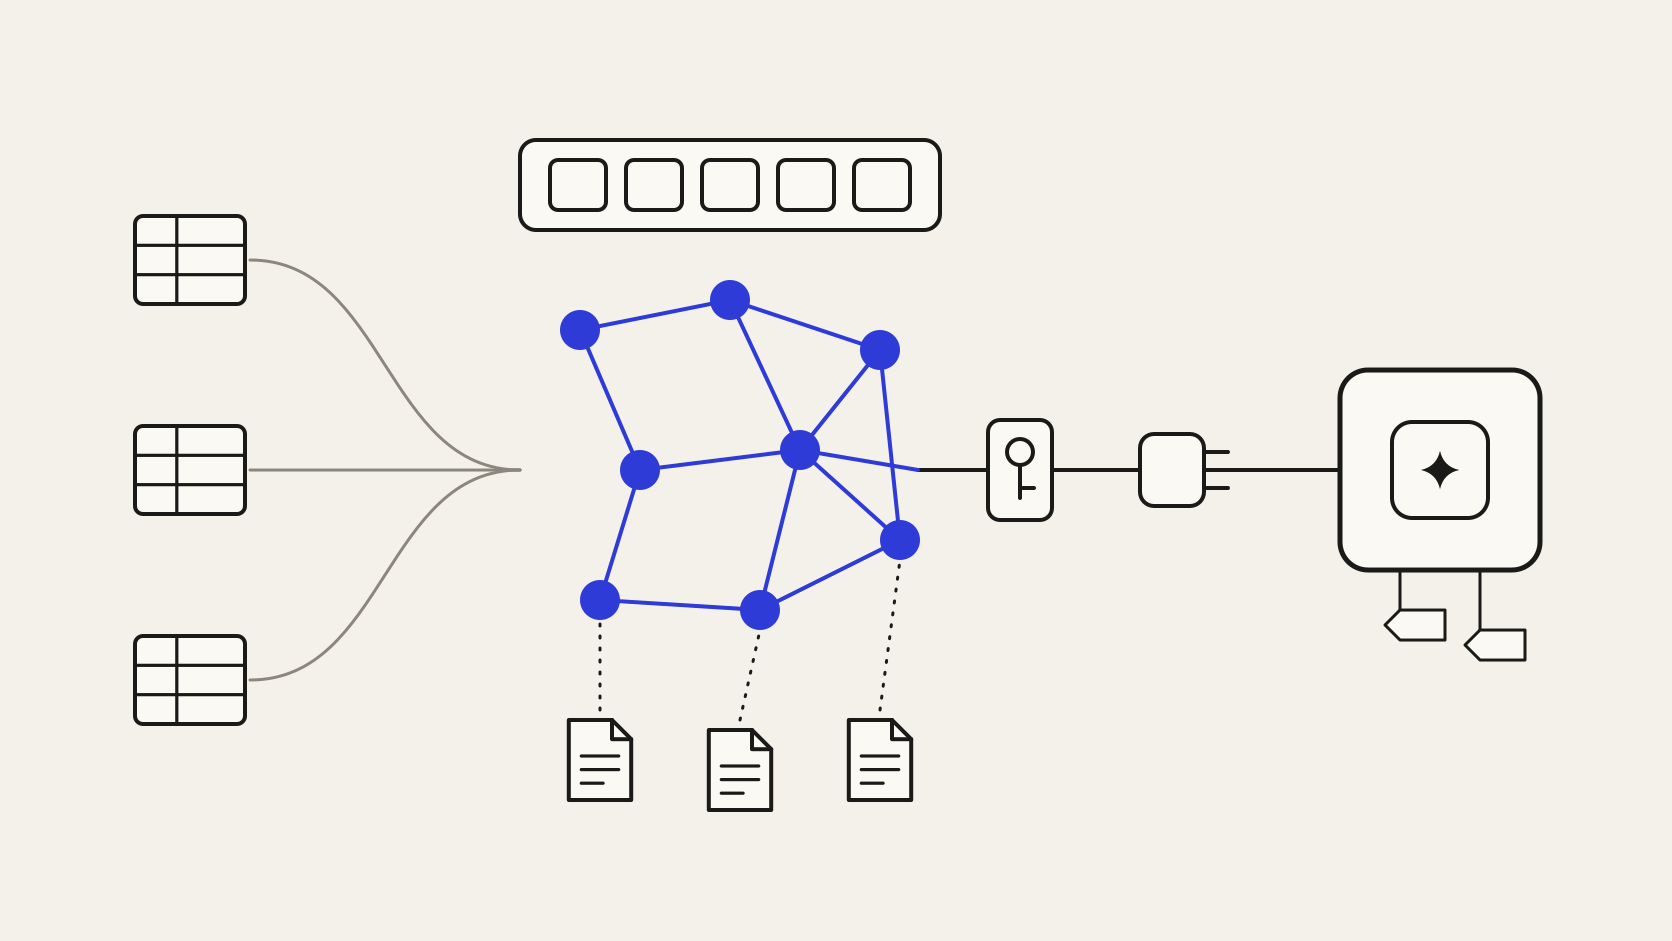
No Company Brain, o grafo de conhecimento nasce dos registros dos sistemas de origem. O fornecedor é o cadastro do ERP, o pedido de compra é o registro com número e data, e a ligação entre eles é a que o próprio sistema já guarda. A ontologia do negócio define o que cada entidade e cada relação significam.
A permissão é herdada da fonte. Cada nó e cada aresta carregam a regra de acesso do sistema de onde vieram, e o recorte servido ao modelo via MCP contém apenas o que quem perguntou já pode ver. Cada relação aponta o registro de origem, o que torna a resposta auditável.
A busca em texto entra como complemento. Atas, contratos e relatórios são indexados e ligados às entidades do grafo, e a camada semântica decide quando a pergunta pede o caminho entre registros, quando pede um trecho escrito e quando pede os dois.
O GraphRAG sobre dados estruturados exige fontes com identificadores minimamente consistentes. Cadastros duplicados no próprio ERP chegam ao grafo e precisam ser tratados na resolução de entidades, com revisão humana nos casos ambíguos. As definições da ontologia também precisam de uma área responsável, porque uma relação mal definida produz respostas coerentes e erradas.
O ponto de partida prático é uma pergunta que hoje exige consultar dois ou três sistemas em sequência e que se repete toda semana. Ela define as entidades, as relações e as fontes do primeiro recorte. Em seguida entram os documentos que ajudam a explicar essas entidades, ligados ao grafo e sujeitos à mesma permissão herdada.