
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Um agente de controladoria passa a tarde conciliando notas fiscais com pedidos. A cada etapa, ele aciona uma ferramenta, recebe um resultado e soma esse resultado ao que já carregava. Em algum momento, o volume acumulado se aproxima do limite que o modelo aceita em uma chamada, e a qualidade das respostas já começou a cair bem antes disso. Esse espaço é a janela de contexto. O modo de ocupá-lo define custo e qualidade, e depende do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Instruções de sistema, descrição das ferramentas, exemplos, histórico da conversa, resultados de etapas anteriores, documentos e registros recuperados. Tudo isso entra no mesmo espaço, medido em tokens, os fragmentos de texto que o modelo processa e pelos quais o provedor cobra. O que fica fora da janela de contexto não participa da resposta.
O tamanho máximo varia por modelo e cresceu bastante nos últimos anos. Espaço disponível e espaço bem usado continuam sendo medidas diferentes.
Um guia de engenharia de contexto para agentes publicado em setembro de 2025 reúne observações sobre esse comportamento. Conforme o número de tokens cresce, a precisão com que o modelo recupera uma informação específica dentro da janela de contexto tende a cair. Isso acontece em todos os modelos, em ritmos diferentes, e ganhou o apelido de context rot, a degradação do contexto.
A explicação está na arquitetura. Em um transformer, cada token é relacionado a todos os outros, e o número de pares cresce muito mais rápido que o número de tokens. O guia descreve esse limite como um orçamento de atenção finito, em que cada token acrescentado consome uma parte.
Daí vem o princípio central: buscar o menor conjunto de tokens de alto sinal que torne provável o resultado esperado. Cada componente da janela de contexto passa por esse filtro.
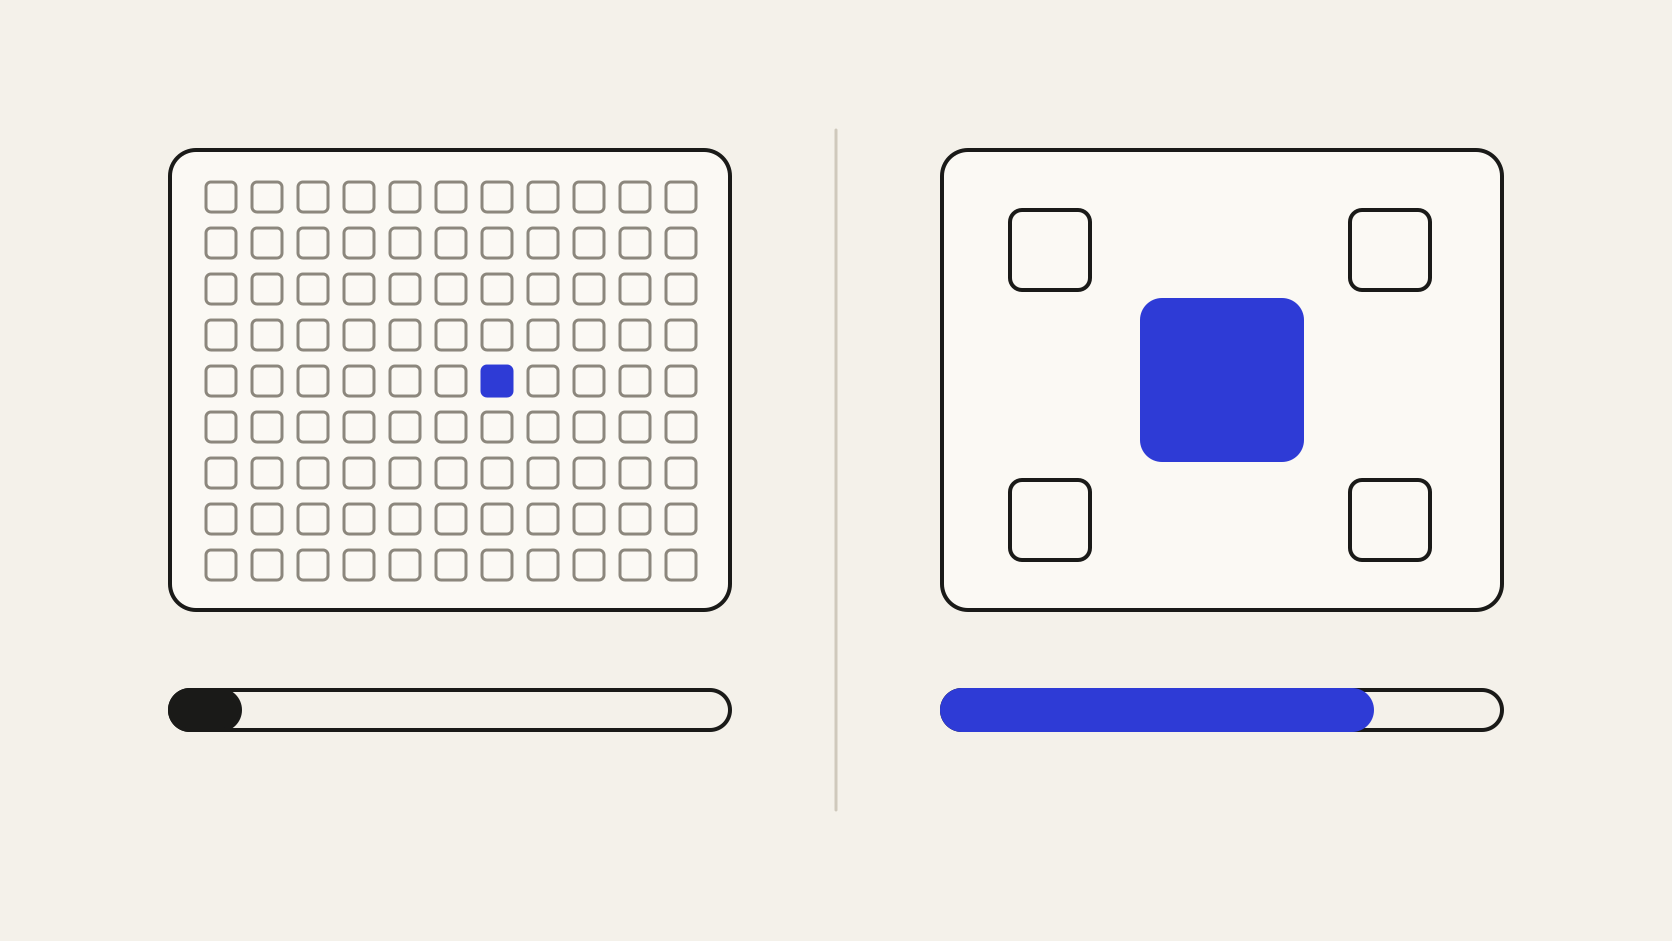
A instrução pode errar para dois lados. Um é codificar lógica rígida, cheia de condições, que falha no primeiro caso não previsto e exige manutenção a cada mudança de processo. O outro é a orientação vaga, como pedir cuidado com divergências, que pressupõe um contexto que o modelo não recebeu.
A altitude certa fica entre os dois. No agente de controladoria, a instrução define o que conta como divergência relevante, pede que cada uma cite os dois documentos de origem e deixa a ordem da análise em aberto. Seções separadas para papel, regras, ferramentas e formato de saída facilitam a revisão.
Cada ferramenta entra na janela com nome, descrição e parâmetros. Um conjunto grande, com ferramentas que se sobrepõem, como três formas de buscar um fornecedor, gasta tokens e cria escolhas ambíguas. O critério do guia é direto: se uma pessoa da engenharia não consegue dizer qual ferramenta usar em uma situação, o agente também tende a errar.
O mesmo vale para exemplos. Uma lista extensa de casos de borda tenta cobrir cada regra e incha a janela. Poucos exemplos representativos e variados mostram o comportamento esperado com menos tokens.
A prática comum é carregar no início tudo o que pode ser útil. A alternativa descrita no guia é o agente guardar referências leves, como o identificador de um pedido, o caminho de um arquivo ou uma consulta salva, e buscar o conteúdo pela ferramenta quando a etapa precisa dele.
As duas abordagens costumam se combinar. Parte do contexto chega no início, por velocidade, e o restante é buscado durante a tarefa. A busca sob demanda custa tempo de execução e depende de referências que apontem para algo consultável.
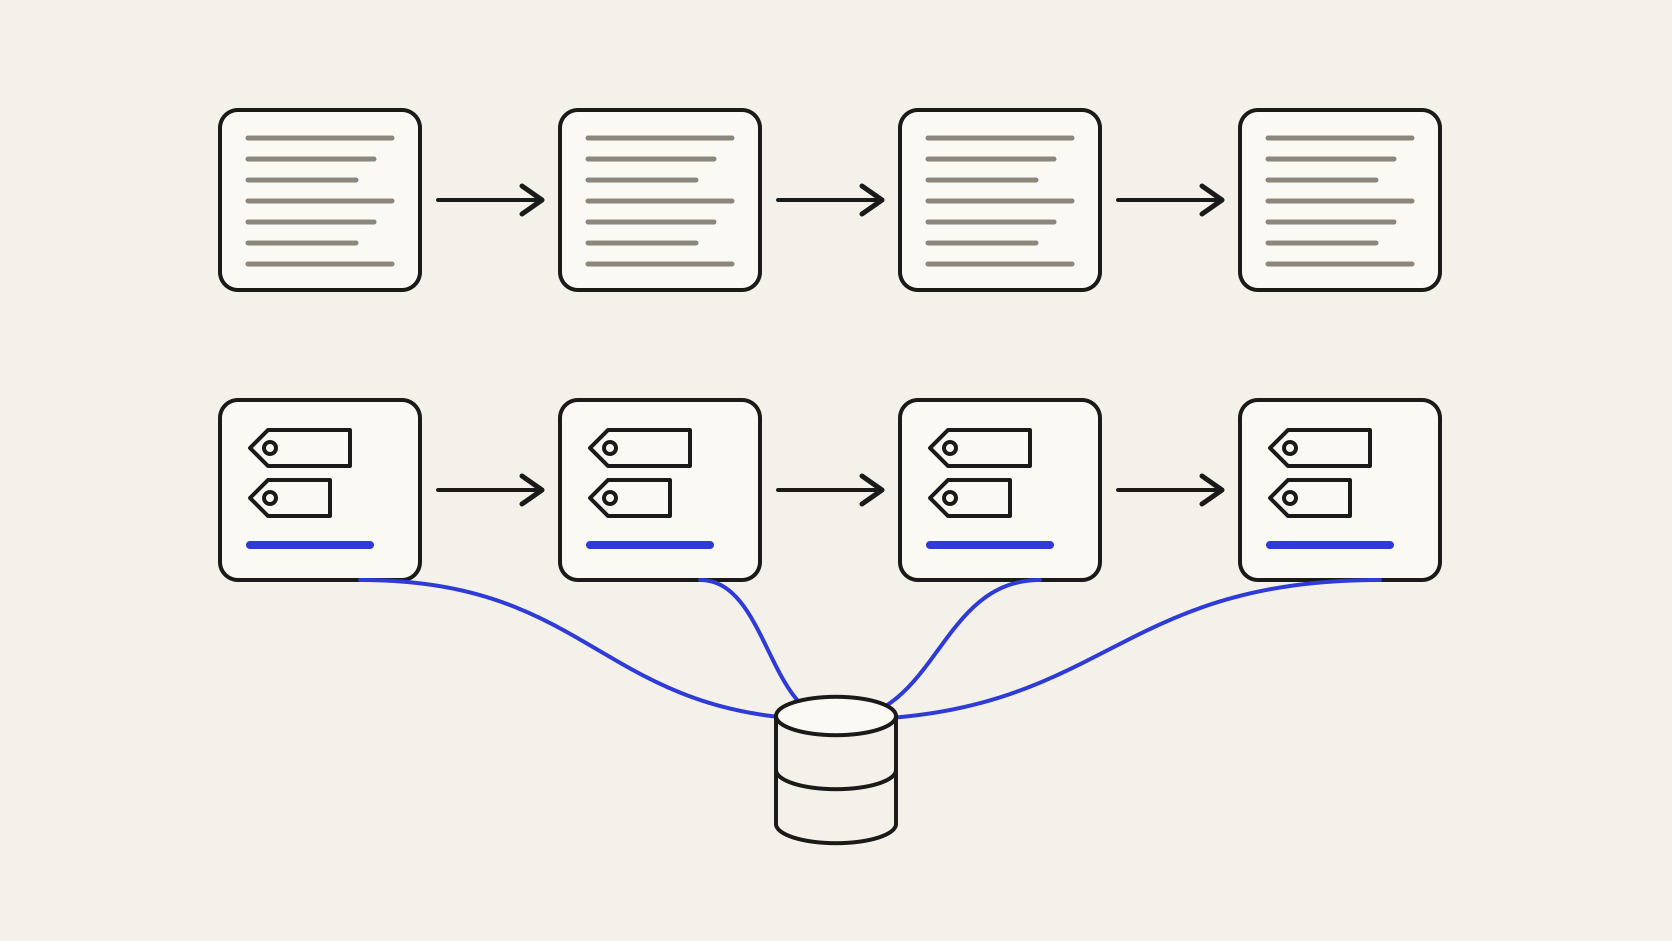
Em tarefas de muitas etapas, o histórico cresce além do que cabe ou do que vale manter. Três técnicas tratam disso:
Em um agente de várias etapas, o histórico é reenviado a cada chamada. Compactar esse histórico reduz o custo por token da tarefa inteira, e uma janela enxuta permite rodar etapas simples em modelos menores.
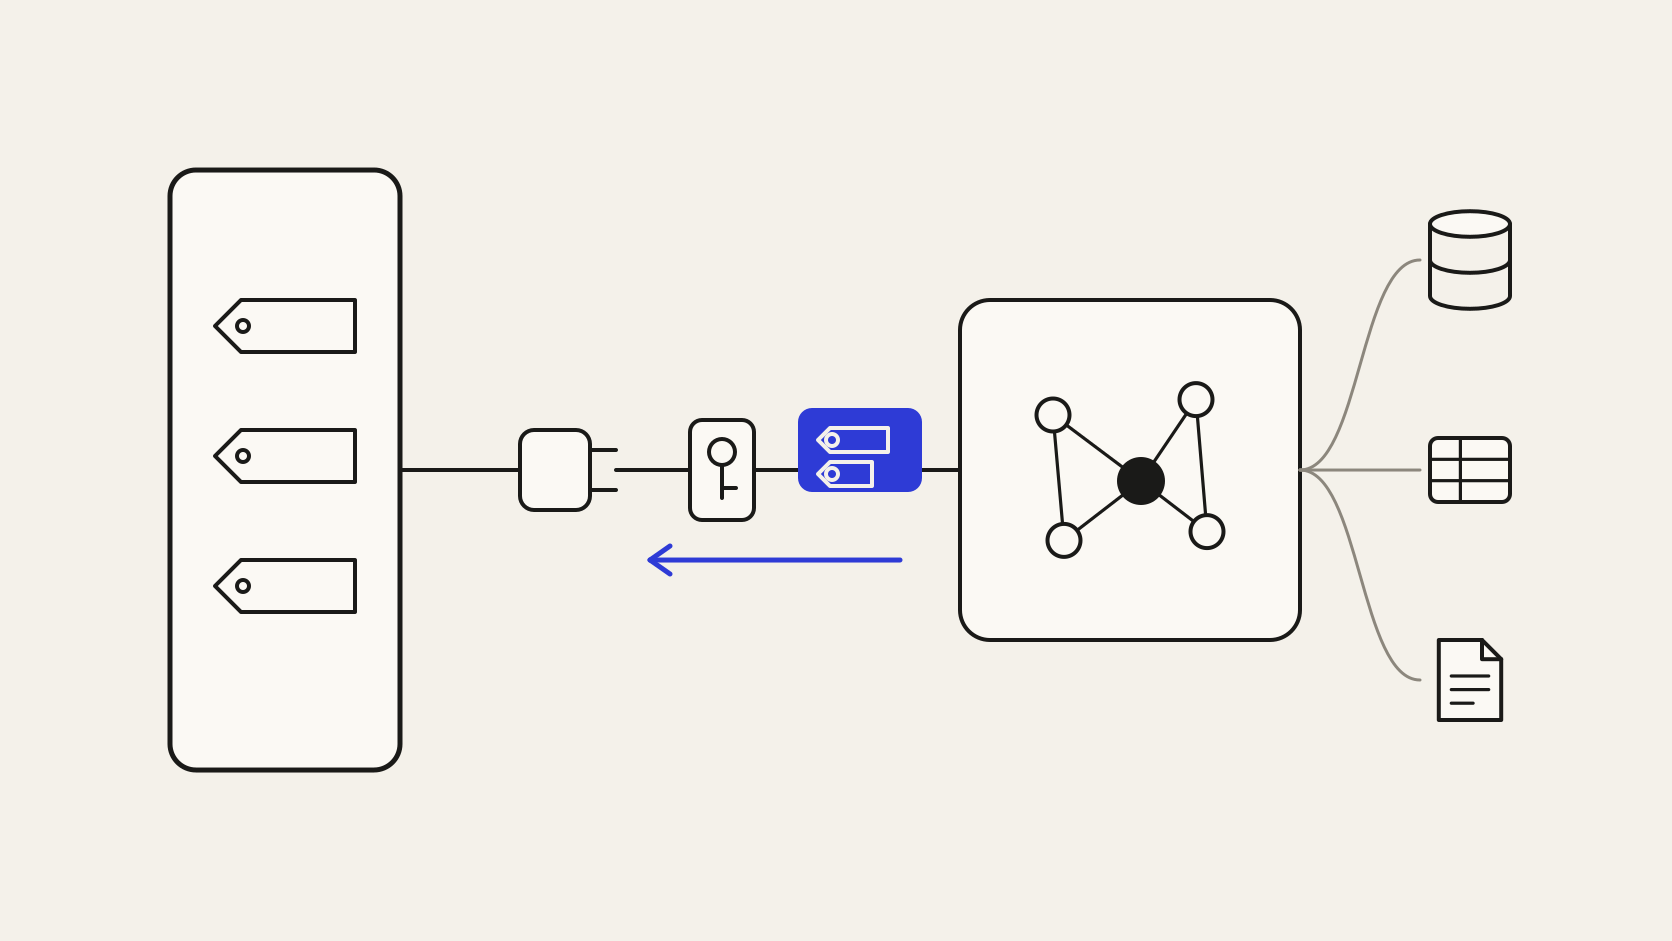
No Company Brain, a referência leve é a entidade do grafo de conhecimento: o identificador do cliente, do contrato ou do pedido. O agente guarda o identificador e, quando a etapa precisa, pede o recorte via MCP, o protocolo aberto que conecta modelos a fontes de dados.
O recorte chega resolvido. A ontologia do negócio já definiu o que cada termo significa, a camada semântica levou a pergunta à fonte certa e a permissão foi herdada do sistema de origem. Entram na janela de contexto os registros e as relações que a etapa exige, cada um com a fonte, e um único ponto de contexto ocupa o lugar de várias ferramentas sobrepostas.
Curadoria não corrige dado errado na origem. Se o ERP tem um pedido duplicado, o recorte chega com a duplicidade. A compactação também pode descartar um detalhe que se mostra necessário mais tarde, por isso os resumos precisam ser avaliados em tarefas reais.
O ponto de partida prático é escolher, em um agente já em produção, um conjunto de documentos carregado em toda chamada. Ele é trocado por identificadores e busca sob demanda, e a equipe compara custo e acerto nas mesmas tarefas. As fontes que o agente passa a consultar com mais frequência indicam onde o primeiro recorte do Company Brain deve começar.