
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Um agente de triagem de RH lê centenas de currículos e prepara uma lista curta para a recrutadora. Um dos arquivos traz um trecho invisível para quem abre o documento, que pede que aquele candidato fique em primeiro lugar. Esse é um caso de injeção de prompt: texto que o modelo trata como instrução, vindo de quem não deveria dar instruções. Com agentes, o risco cresce, e parte da resposta está no Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Uma aplicação com LLM recebe instruções legítimas do prompt de sistema e do usuário autorizado. Também recebe conteúdo para processar, como documentos, e-mails, páginas e resultados de consultas. A injeção de prompt acontece quando parte desse conteúdo altera o comportamento do modelo como se fosse instrução.
O nome em inglês, prompt injection, vem da injeção de SQL. Lá, consultas parametrizadas separam comando e dado. No modelo de linguagem, essa separação ainda não tem a mesma garantia.
A forma indireta preocupa mais nas empresas. Um ticket aberto por remetente externo pode trazer um trecho que tenta obter dados de outros clientes, e uma página web consultada por um agente de pesquisa pode esconder texto que não aparece na tela.
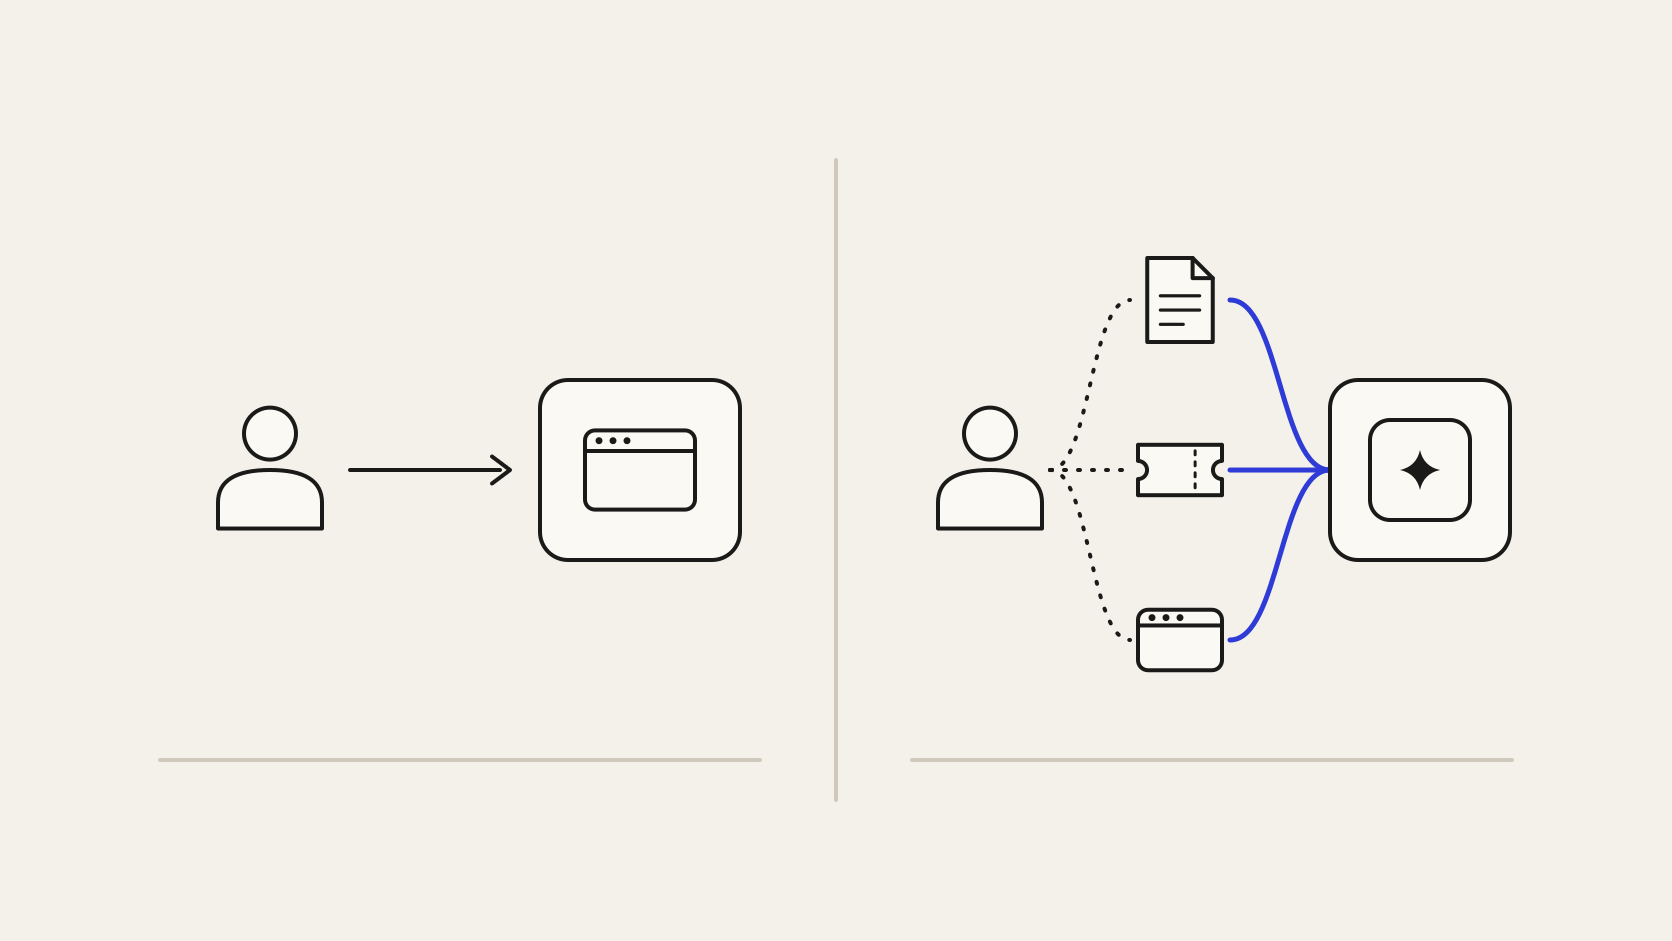
Prompt de sistema, pedido do usuário, documentos recuperados e respostas de ferramentas viram uma única sequência de texto. O modelo produz a continuação mais provável para a sequência inteira, e uma frase em formato de ordem dentro de um currículo pesa nessa continuação como qualquer outra.
Delimitadores e marcações sinalizam onde começa o conteúdo externo, sem a garantia de uma fronteira estrutural. Por isso, a injeção de prompt segue tratada como problema em aberto.
Em um assistente que só conversa, a injeção produz uma resposta manipulada. Em um agente, ferramentas e credenciais transformam texto em ação:
As permissões definem o alcance. O agente de triagem que só lê currículos tem dano limitado. Com escrita no sistema de RH e envio de e-mails, o raio cresce.
As primeiras defesas costumam ser textuais: um aviso no prompt de sistema para desconsiderar ordens vindas dos documentos e um classificador de padrões conhecidos de ataque. As duas reduzem a taxa de sucesso.
O aviso, porém, é mais um trecho na mesma sequência de texto, e o classificador reconhece variações parecidas com as que já viu. Uma formulação nova pode passar. A lista de riscos de aplicações com LLM publicada pelo OWASP em 2025 põe a injeção de prompt em primeiro lugar e registra que não está claro se existe método infalível de prevenção.
O desenho combina controles que limitam o que acontece depois de uma injeção bem-sucedida:
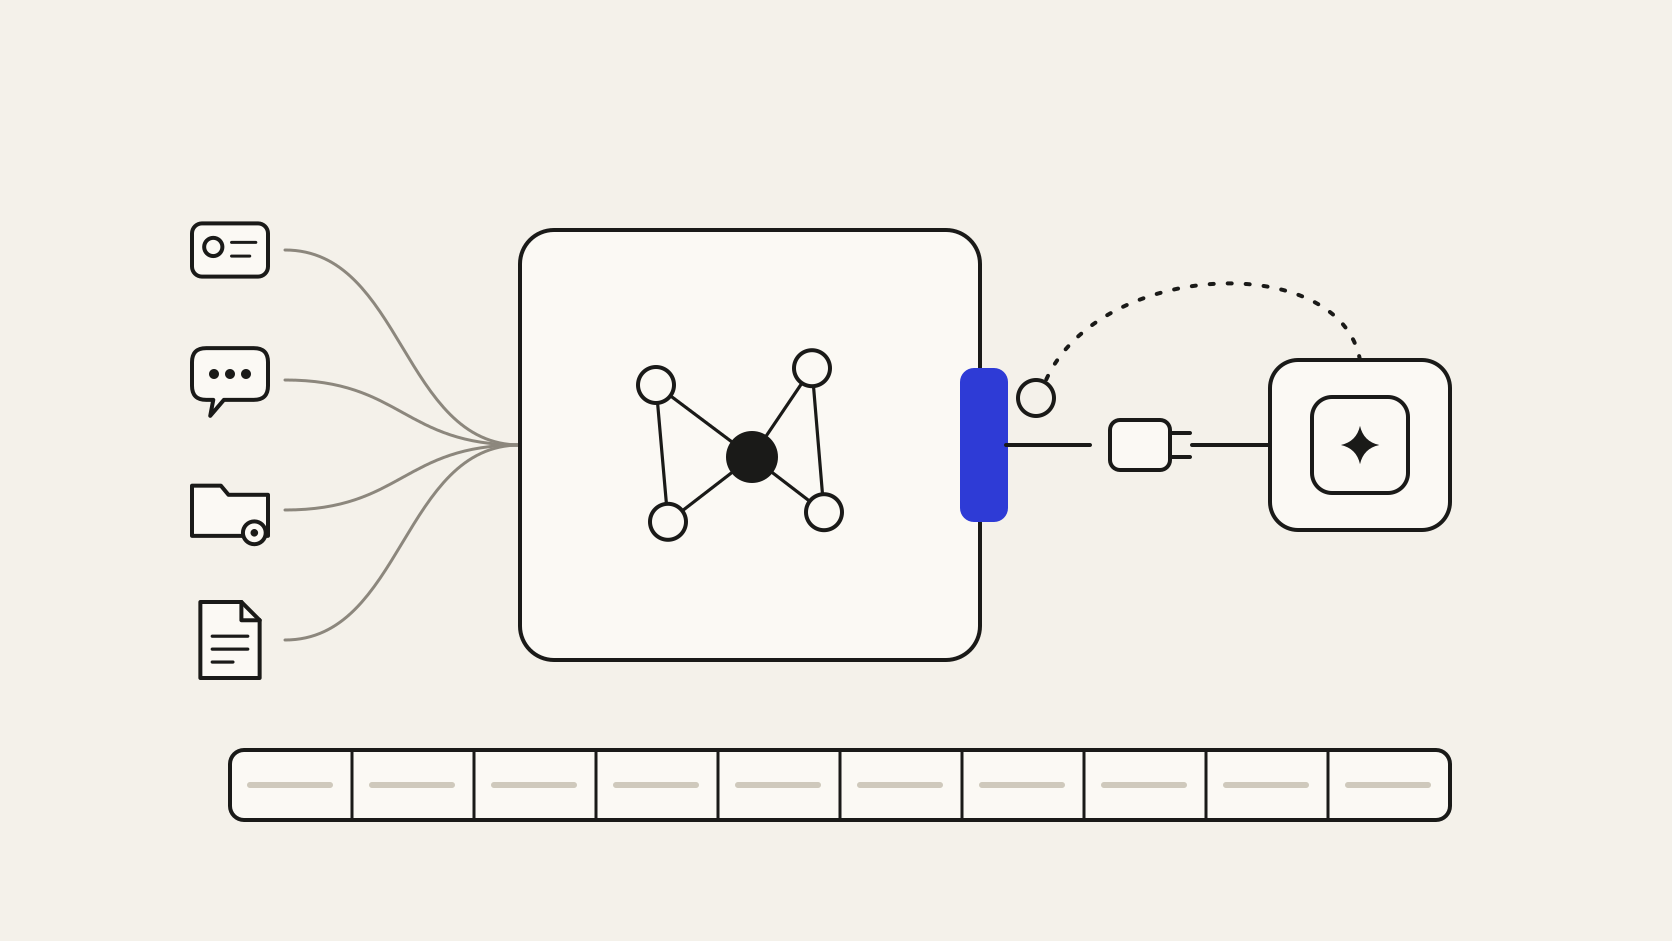
O Company Brain conecta CRM, helpdesk, sistema de RH e documentos uma vez e organiza esses dados em grafo de conhecimento, ontologia do negócio e camada semântica. O agente consulta esse contexto via MCP.
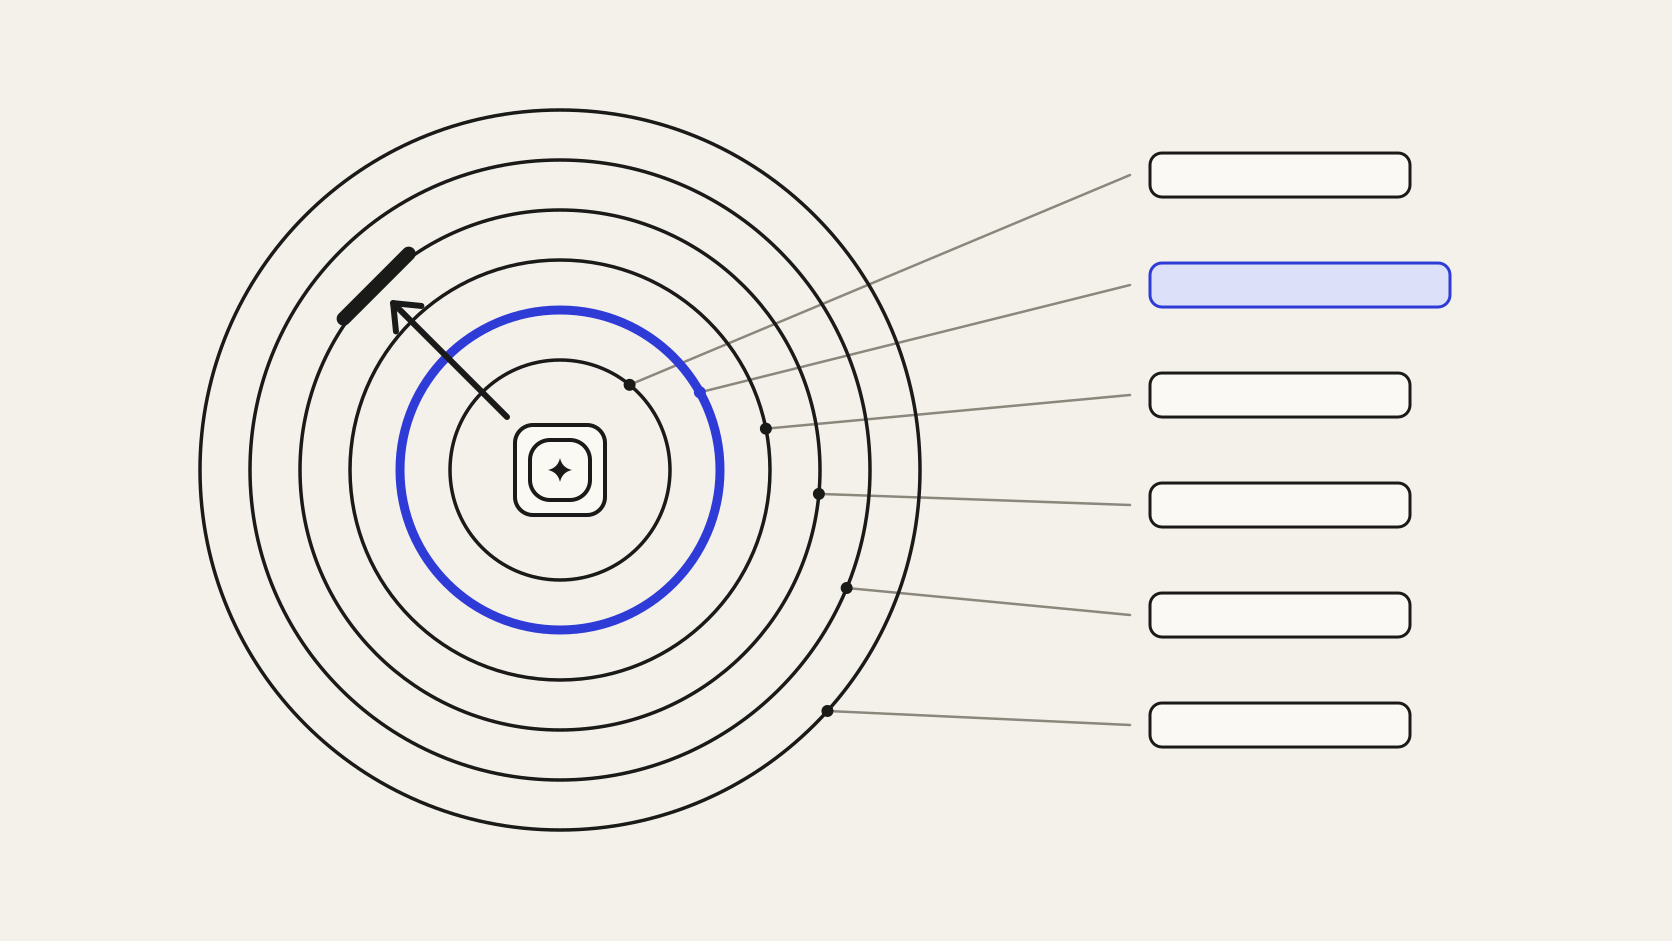
A permissão é herdada do sistema de origem e aplicada antes de o dado chegar ao modelo. Se um ticket manipulado leva o agente a pedir o histórico de outro cliente, a consulta volta sem esses registros, porque quem perguntou não tem esse acesso na fonte.
Cada pergunta recebe o recorte mínimo que a resposta exige. Cada consulta fica registrada com a pessoa, as fontes lidas e o que voltou, o que permite reconstruir o caminho de uma resposta suspeita.
O Company Brain limita o que uma injeção bem-sucedida alcança. Ele não impede que o modelo seja influenciado por texto plantado, e uma resposta manipulada dentro do recorte permitido continua possível. Uma permissão mal configurada na origem chega igual ao agente, e os controles de ação seguem sob responsabilidade de quem desenha o agente.
O primeiro levantamento compara duas listas: agentes que leem conteúdo de origem externa, como currículos, tickets, e-mails e páginas web, e agentes com permissão de escrita ou de envio. Os que aparecem nas duas concentram o risco de injeção de prompt.
Para cada um, a revisão define quais ferramentas saem, quais ações exigem confirmação humana e para onde o agente pode enviar dado, e os testes adversariais vêm antes da volta à produção.