
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma gerente de compras vai renegociar o contrato de um fornecedor de embalagens e quer saber quem na empresa já negociou com ele e qual foi a última condição fechada. A condição está em um aditivo, a negociação ficou em uma troca de e-mails, o comprador que conduziu o processo mudou de área e o histórico de entregas está no ERP. Um assistente de IA que só lê documentos encontra o contrato original e para ali. O enterprise knowledge graph, ou grafo de conhecimento corporativo, é o modelo que liga esses pedaços: conteúdo, pessoas, sistemas, registros e atividade da empresa inteira. Ele é a estrutura central do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Um enterprise knowledge graph é um grafo de conhecimento construído sobre os dados privados de uma organização, com um objetivo prático: permitir que modelos e agentes de IA encontrem e usem o contexto certo para cada pergunta. Ele representa o conteúdo produzido pela empresa, as pessoas que trabalham nela, os sistemas onde os dados vivem, os registros transacionais desses sistemas, a atividade em torno de tudo isso e as relações entre esses elementos.
A mecânica de nós e arestas está no artigo sobre grafo de conhecimento desta série. Aqui o foco é o que entra no grafo, como ele é construído e mantido e que regras obedece para servir a IA em produção.
A literatura acadêmica usa o termo com o mesmo sentido. O levantamento sobre grafos de conhecimento publicado por Hogan e coautores na ACM Computing Surveys em 2021 descreve os grafos corporativos como estruturas internas à empresa, aplicadas a casos de uso comerciais como busca, recomendação, análise de negócio, avaliação de risco e automação.
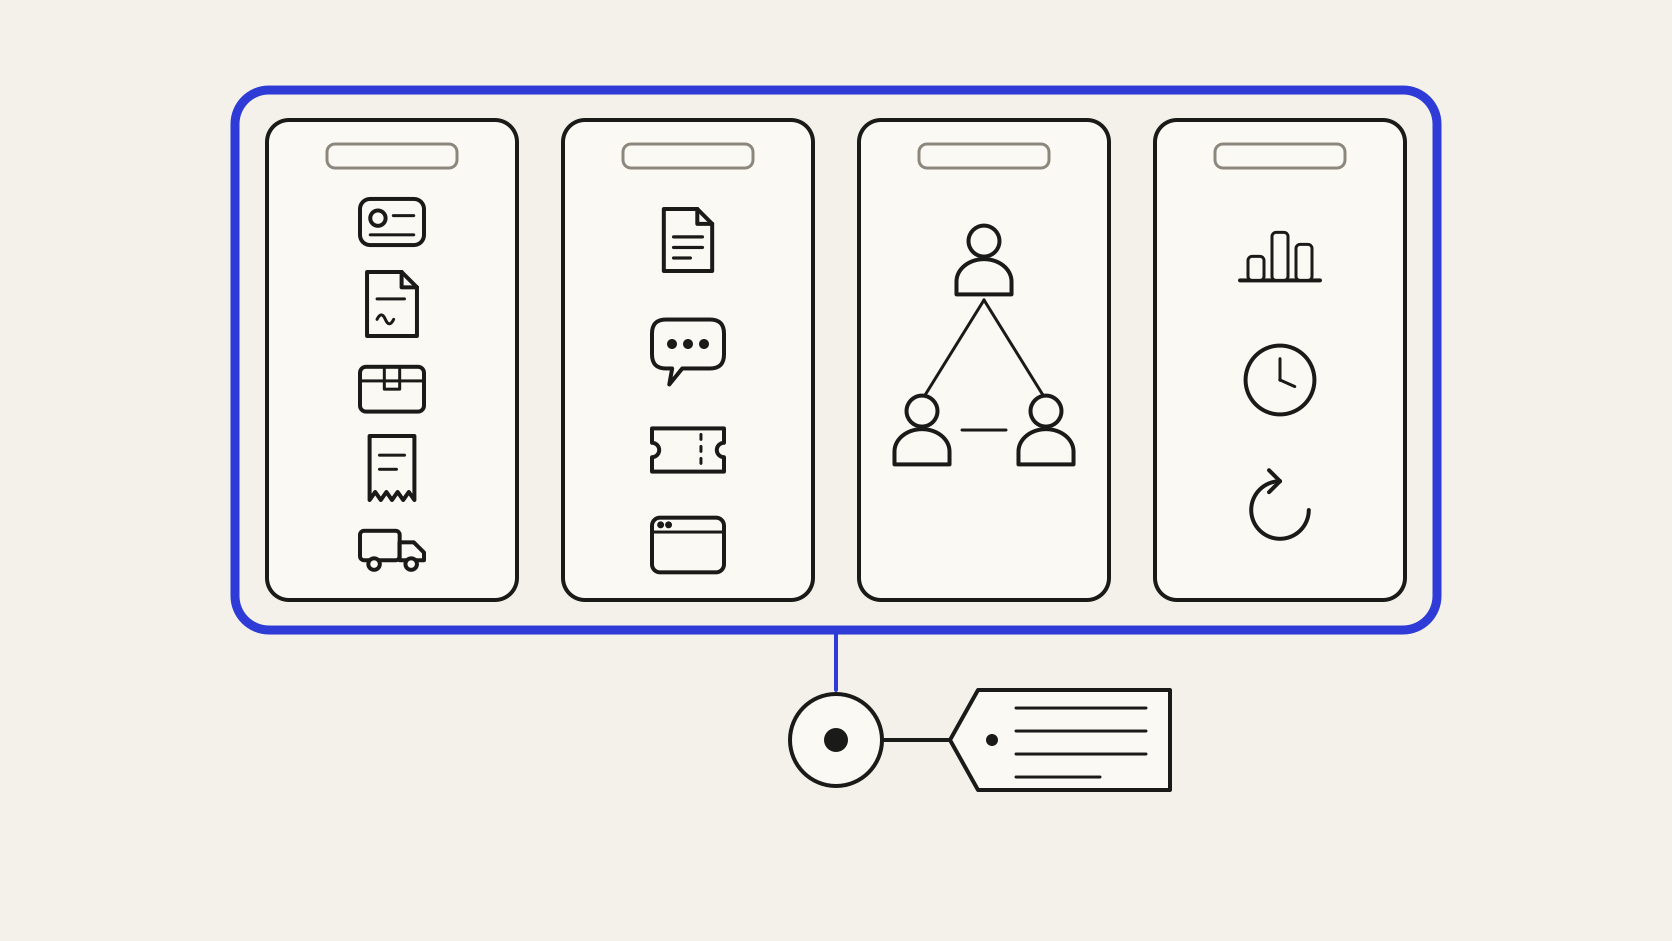
As camadas convivem no mesmo grafo. Uma consulta parte de um fornecedor, passa por um documento, chega a uma pessoa e é filtrada pela permissão de quem perguntou.
Cliente, contrato, produto, pedido, fornecedor e projeto são as entidades que os sistemas transacionais já registram, com identificador, atributos e estado. Elas formam o esqueleto do grafo, porque quase toda pergunta de negócio parte de uma delas.
Documentos, e-mails, conversas, tickets e transcrições de reunião entram como nós ligados às entidades que mencionam. A proposta se liga ao cliente, a ata se liga ao projeto, o ticket se liga ao produto.
Essa camada registra quem é dono de cada conta, quem aprovou cada contrato e quem trabalha com quem. Ela também revela especialistas por tema, como a pessoa que mais resolveu casos sobre determinado fornecedor. É aqui que está a resposta sobre quem já negociou com o fornecedor de embalagens.
O que é consultado, por quem, com que frequência e quando foi alterado pela última vez. Esses sinais separam o documento em uso do documento abandonado. Uma política lida toda semana pela área jurídica e revisada no mês passado tem mais autoridade que uma cópia antiga guardada em uma pasta pessoal.
A última camada registra quem pode ver cada nó e cada relação, e ela acompanha todas as outras. Um contrato visível para a controladoria pode estar fechado para o time de marketing. A relação entre um cliente e a margem negociada pode ser mais restrita que o próprio cadastro do cliente.
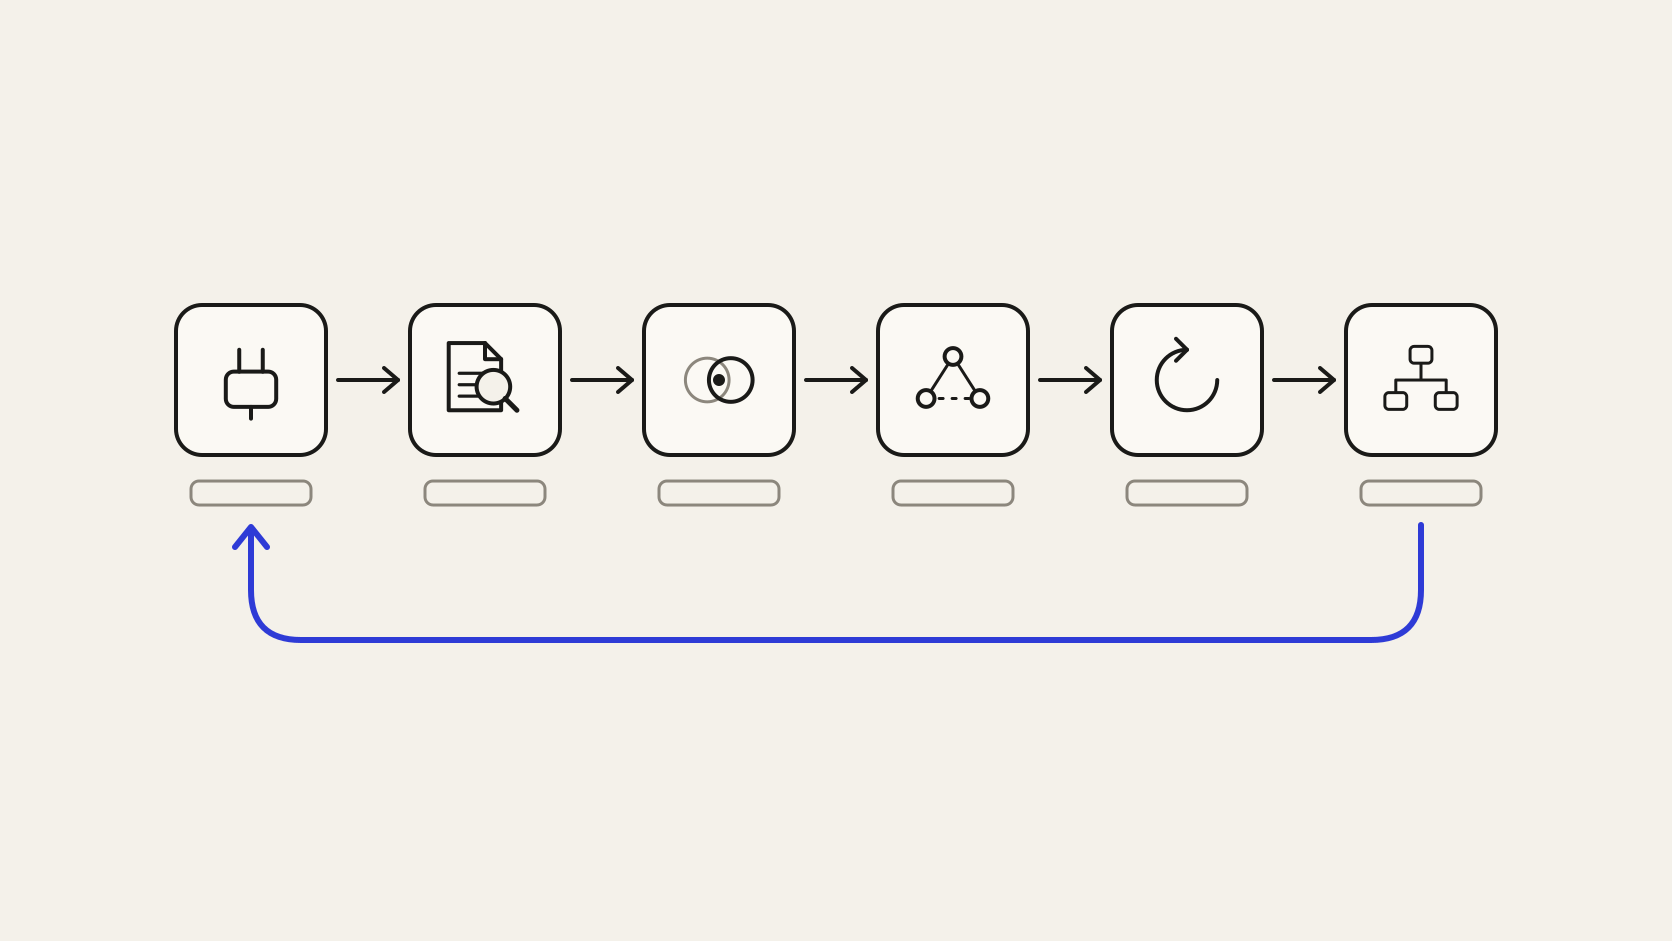
A construção é contínua. As etapas rodam de novo sempre que as fontes mudam:
Com a ontologia, a relação aprovou e a relação comentou chegam ao modelo com significados diferentes, e o contexto informa quem decidiu e quem apenas participou.
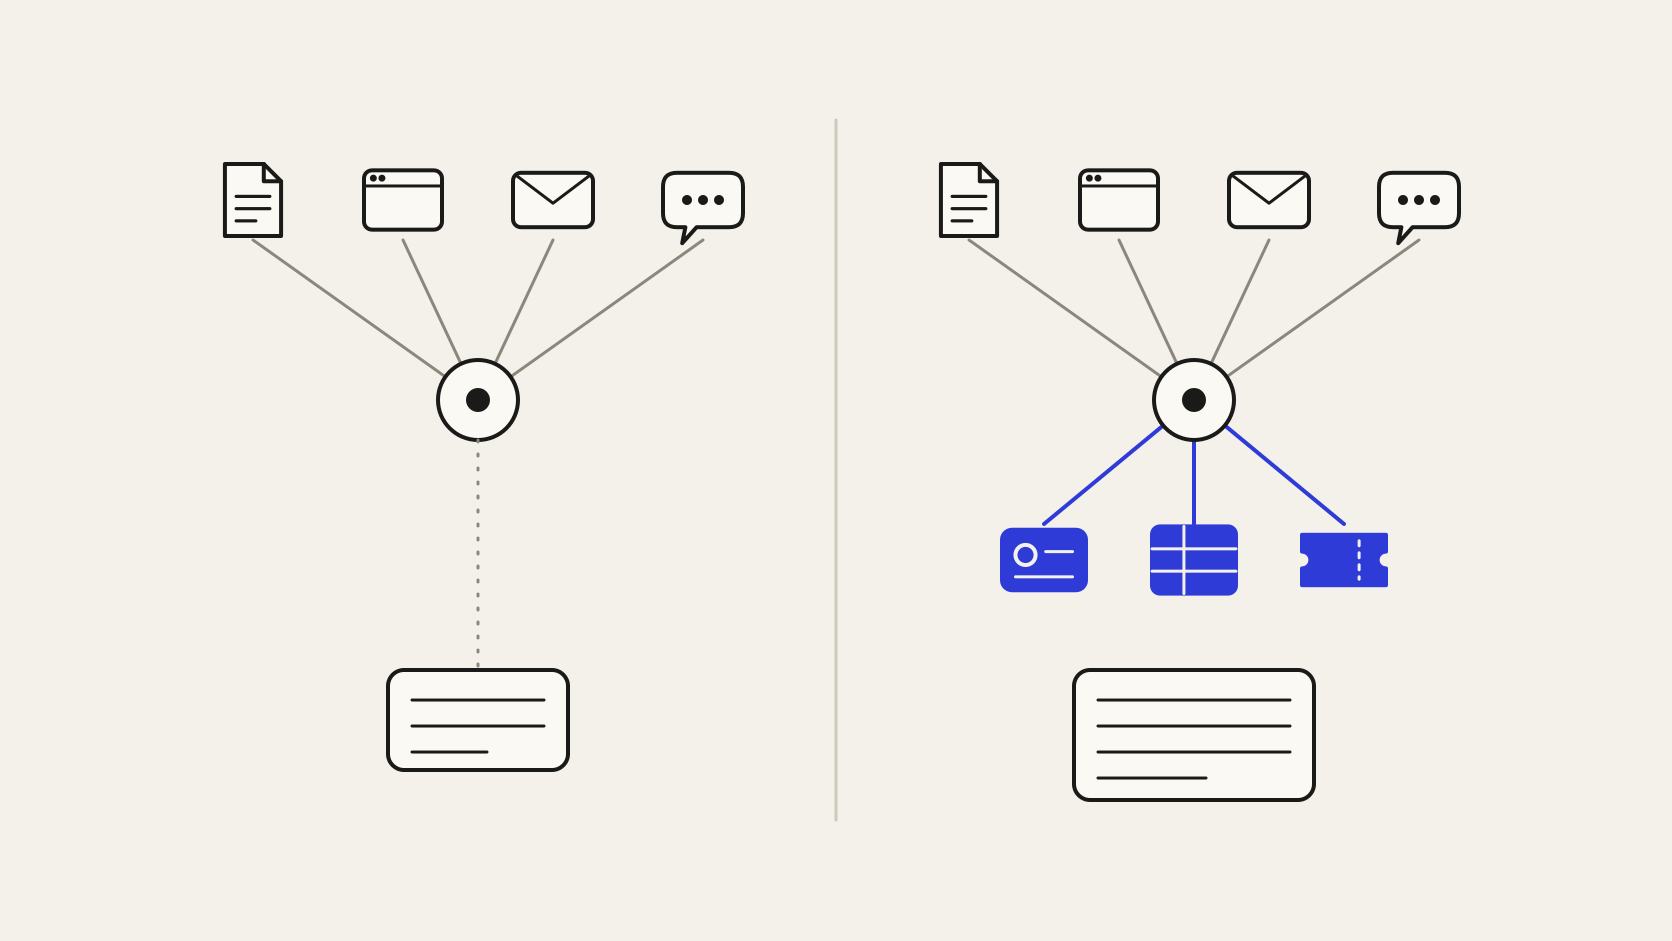
Um modelo de linguagem responde com base no que recebe no contexto. O grafo melhora a escolha desse contexto de cinco formas.
Uma busca corporativa por política de reembolso de viagens devolve seis versões do mesmo documento. O grafo sabe qual foi publicada pela área financeira, qual está vigente, qual é a mais acessada e quais foram substituídas. O modelo recebe a versão vigente, com a fonte indicada.
Dois analistas com o mesmo nome, um produto com nome comercial e código interno, uma sigla com sentidos diferentes em vendas e em engenharia. O grafo resolve a referência pelo entorno, como o projeto e a equipe citados na pergunta.
Montar o contexto de um projeto de implantação exige seguir uma cadeia. O contrato define o escopo, os e-mails registram mudanças combinadas, os tickets mostram os problemas abertos e as pessoas ligadas a cada item indicam a quem perguntar. Cada passo é uma relação do grafo, e percorrer a cadeia em uma consulta poupa o agente de dezenas de buscas por tentativa.
A mesma pergunta sobre um cliente pede oportunidades e contatos para a executiva de contas e SLA e incidentes para o analista de suporte. O grafo conhece a área e a carteira de quem pergunta e prioriza as relações próximas desse papel.
Um agente que abre um pedido de compra, atualiza um registro ou responde um cliente precisa saber sobre qual entidade está agindo. O grafo entrega o identificador correto, o dono do registro e as restrições aplicáveis antes da ação, o que reduz o risco de o agente escrever no registro errado.
Busca corporativa e RAG atendem bem perguntas de localização, como onde está a política de viagens ou quais documentos mencionam um projeto. Agentes recebem outras perguntas: por que a liberação de crédito de um cliente está parada, quem precisa aprovar o próximo passo e se o agente pode executá-lo sem essa aprovação. São perguntas sobre relação e estado.
A camada de conhecimento de que agentes corporativos precisam além do RAG é a peça entre os sistemas e os agentes que transforma artefatos espalhados em conceitos canônicos, rastreáveis e sujeitos a permissão. Um projeto aparece como épico no gerenciador de tarefas, repositório de código, canal de conversa e registro de incidente. A busca devolve cada artefato separado, e a camada de conhecimento reconhece que todos descrevem o mesmo projeto.
No caso do crédito parado, o cliente tem uma solicitação, que segue uma política, que exige uma aprovação, que aguarda um papel específico. Com RAG, o modelo recebe trechos parecidos com a pergunta e precisa deduzir essas ligações. Com o enterprise knowledge graph, o sistema percorre o caminho e entrega a cadeia montada, e o modelo apenas explica e redige sobre ela.
Para o agente saber se pode usar ou expor uma informação, cada nó e cada relação carregam metadados:
Sem esses metadados, uma relação extraída de um e-mail antigo chega ao agente com o mesmo peso de um registro atual do ERP.
Cada fonte tem regras próprias: o CRM restringe contas por carteira, o drive compartilha pastas por grupo e o ERP limita dados financeiros por perfil. O grafo precisa aplicar essas regras no momento da consulta, com o estado atual da permissão de cada pessoa.
O risco mais sério de um grafo corporativo é achatar permissões. Quando a ingestão lê as fontes com uma conta de serviço de acesso amplo e o grafo responde a todos com o mesmo recorte, qualquer pessoa passa a ver pela IA o que não veria no sistema de origem. Relações também expõem informação: saber que existe contrato com um fornecedor em negociação sigilosa já é dado sensível.
O tratamento adequado é a permissão herdada. Cada nó e cada relação carregam a regra de acesso da fonte, e a consulta filtra o resultado pela identidade de quem pergunta. Quando a permissão muda no sistema de origem, o grafo acompanha na sincronização seguinte.
A permissão herdada define o que cada pessoa pode ler. Quando um agente prepara ou executa ações, a autorização se estende por quatro pontos:
O controle de saída trata o vazamento por inferência. Um agente pode combinar fatos permitidos, como a troca do responsável por uma conta, a suspensão de pedidos e uma reunião com o jurídico, e chegar a uma conclusão sensível que nenhuma fonte registra.
Com agentes nos processos, o grafo guarda a cadeia operacional: caso, decisão, evidência, aprovação, execução e resultado. Esse histórico permite reconstruir uma decisão anterior.
Entram no grafo fatos validados, decisões aprovadas e resultados confirmados. O raciocínio intermediário do agente e as chamadas de ferramenta ficam no log de auditoria, para que uma saída sem verificação não vire fato nas consultas seguintes.
Os grafos de busca pública descrevem cidades, empresas e obras, com fatos estáveis e visíveis para qualquer pessoa. O enterprise knowledge graph descreve uma única organização, com dados privados e acesso definido pessoa a pessoa.
Siglas, nomes de projeto e códigos de produto só existem dentro da empresa, e a ontologia precisa registrá-los. A mudança é diária: contratos recebem aditivos, pessoas mudam de área, tickets abrem e fecham. Por isso o grafo corporativo trabalha com atualização contínua e data em cada fato.
Há duas formas comuns de construir o grafo. A primeira parte de documentos e ferramentas de colaboração (drive, wiki, e-mail, chat) e organiza bem o conhecimento escrito.
A segunda inclui os dados vivos dos sistemas transacionais, como CRM, ERP, helpdesk e gestão de contratos. É nesses sistemas que estão o valor faturado, o status do pedido, o SLA contratado e o saldo em aberto. Um grafo feito de documentos responde o que a empresa escreveu sobre um cliente. Com os sistemas transacionais, ele responde também em que situação o cliente está hoje.
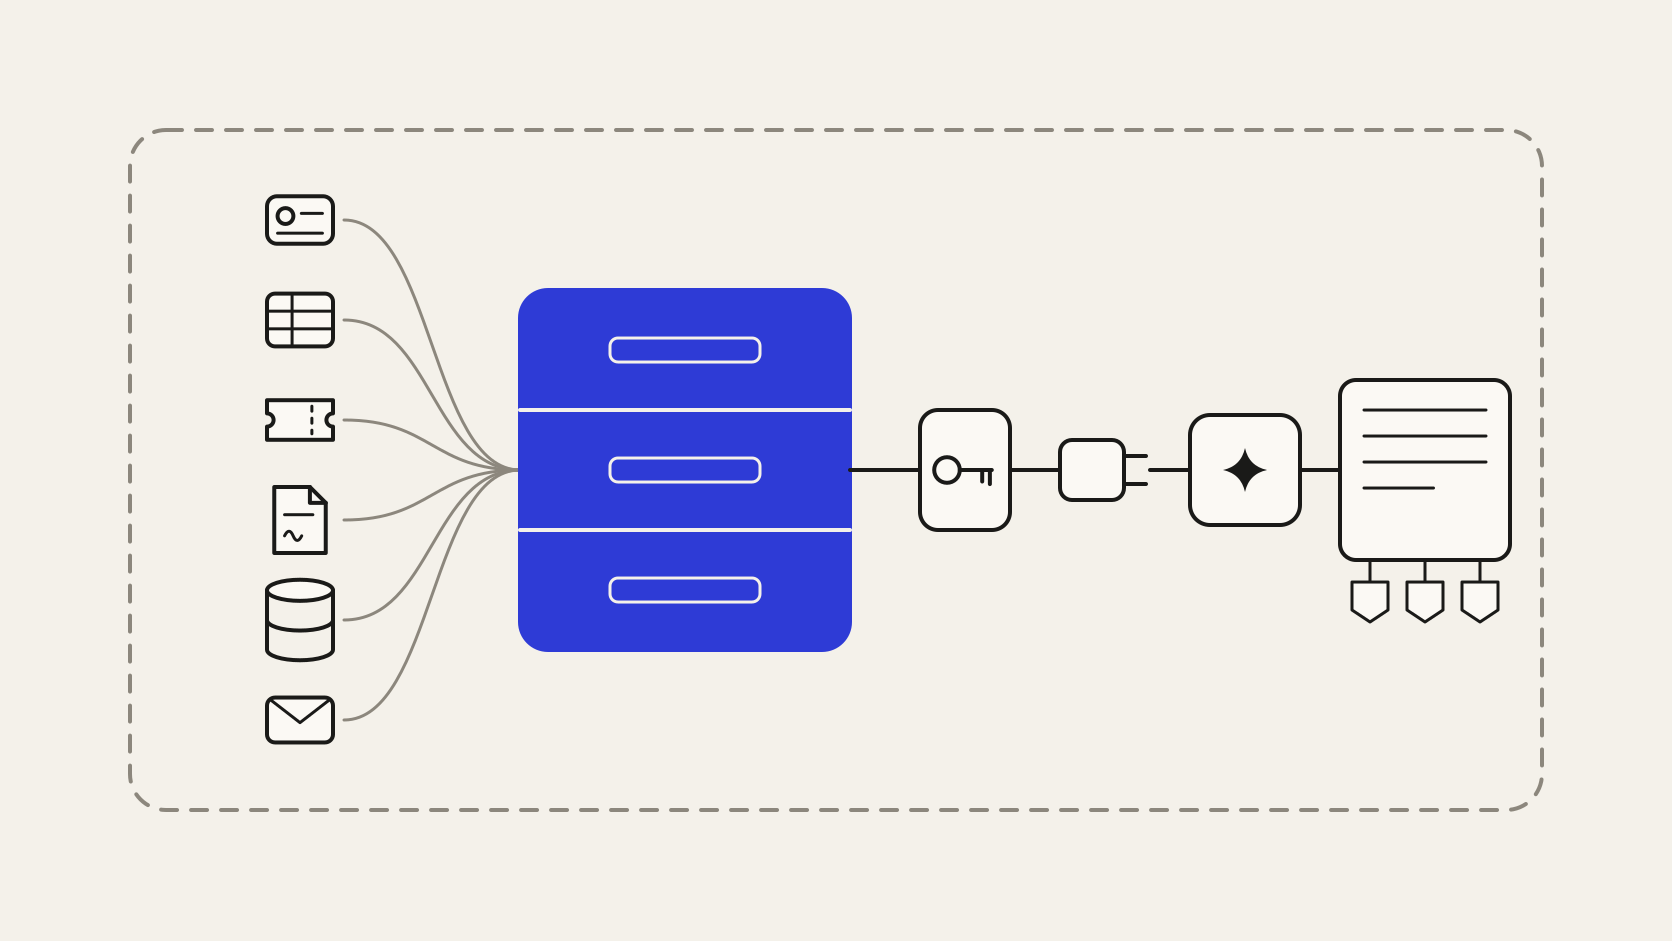
O Company Brain modela os dois. O contrato em PDF e o registro do contrato no sistema de gestão viram nós ligados, a conversa sobre um reajuste se liga à fatura que ele gerou, e o modelo recebe via MCP o recorte que a pergunta exige, com documentos e registros no mesmo contexto.
No Company Brain, o enterprise knowledge graph aparece em três componentes que trabalham juntos. O grafo de conhecimento guarda entidades, conteúdo, pessoas e relações. A ontologia do negócio define o que cada tipo significa naquela empresa. A camada semântica traduz a pergunta em linguagem natural para o percurso certo no grafo e nas fontes.
Quatro propriedades acompanham esse desenho:
No caso de compras, a consulta parte do fornecedor, segue até o contrato e o aditivo, chega a quem negociou, encontra o último e-mail sobre preço e devolve a condição atual com a fonte de cada item. A decisão sobre a proposta continua com a gerente.
O grafo herda a qualidade das fontes. Os limites mais frequentes:
Modelar todas as camadas antes do primeiro uso costuma travar o projeto. O caminho mais curto é escolher uma pergunta que hoje exige abrir vários sistemas e procurar pessoas, como quem já negociou com determinado fornecedor ou qual é a versão vigente de uma política.
Essa pergunta define as primeiras entidades, fontes, sinais de atividade e regras de permissão a herdar. A ontologia também nasce desse fluxo. Responsável pode ser quem alterou o registro, quem responde pelo resultado ou quem tem alçada para aprovar, e o sentido certo fica fixado antes da expansão para outras áreas.
Um conjunto de perguntas de teste avalia esse caso: o sistema identifica o mesmo objeto em fontes diferentes, mostra o caminho de evidências, respeita permissões em relações inferidas e detecta a aprovação que falta antes de agir. Rodar as mesmas perguntas com RAG e com consulta ao grafo mostra onde cada abordagem falha.
Com a resposta funcionando e rastreável, o caso de uso seguinte reaproveita conectores, entidades e ontologia, e o grafo cresce na direção das perguntas que a empresa faz no dia a dia.