
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Um agente que analisa um pedido de reembolso faz várias chamadas ao modelo antes de concluir a tarefa. Em cada uma, alguma parte do sistema decide o que o modelo recebe: a instrução, a política vigente, o histórico do cliente, o resultado da ferramenta anterior, a lista de ações disponíveis. A engenharia de contexto é a disciplina que faz essa escolha a cada chamada. Dela dependem a qualidade da resposta e o custo de cada execução, e ela se apoia no Company Brain, a camada que conhece a empresa (quais dados existem, onde vivem, como se relacionam e quem pode ver o quê).
Um modelo de linguagem trabalha apenas com o que está na janela de contexto no momento da chamada. O que fica fora da janela não participa da resposta. A engenharia de contexto trata essa janela como um recurso limitado e projeta, para cada etapa, o conjunto de informações que a tarefa exige.
O trabalho tem quatro operações. Selecionar qual trecho da política entra. Ordenar, para que a instrução e o dado principal fiquem em posição de destaque. Resumir o histórico de uma tarefa longa. Descartar o resultado de uma ferramenta que já cumpriu o papel.
A engenharia de prompt trata da redação da instrução: como formular a tarefa, quais exemplos incluir, qual formato pedir na saída. Ela resolve bem os casos em que a tarefa cabe em uma pergunta e uma resposta e o conhecimento necessário já está no texto enviado.
A engenharia de contexto inclui essa instrução e cuida de tudo o que chega ao modelo junto com ela: dados recuperados de sistemas e documentos, histórico, descrição das ferramentas, resultados de chamadas anteriores e memória de interações passadas. Em um agente corporativo, a instrução costuma ocupar a menor parte da janela.
O termo ganhou espaço quando os projetos passaram de perguntas isoladas para agentes que executam sequências de passos. Cada passo acrescenta um resultado de ferramenta ao histórico, e a janela cresce a cada etapa. Sem critério, a última chamada carrega o resíduo de todas as anteriores.
Janelas maiores aliviam o limite de espaço e trazem dois efeitos colaterais. O primeiro é o custo, porque cada token enviado é cobrado em cada chamada. O segundo é a qualidade. Em 2023, Liu e colegas mostraram que o desempenho dos modelos cai quando a informação relevante está no meio de contextos longos, inclusive em modelos desenhados para janelas extensas. Mais texto na janela pode diluir justamente o trecho que decide a resposta.
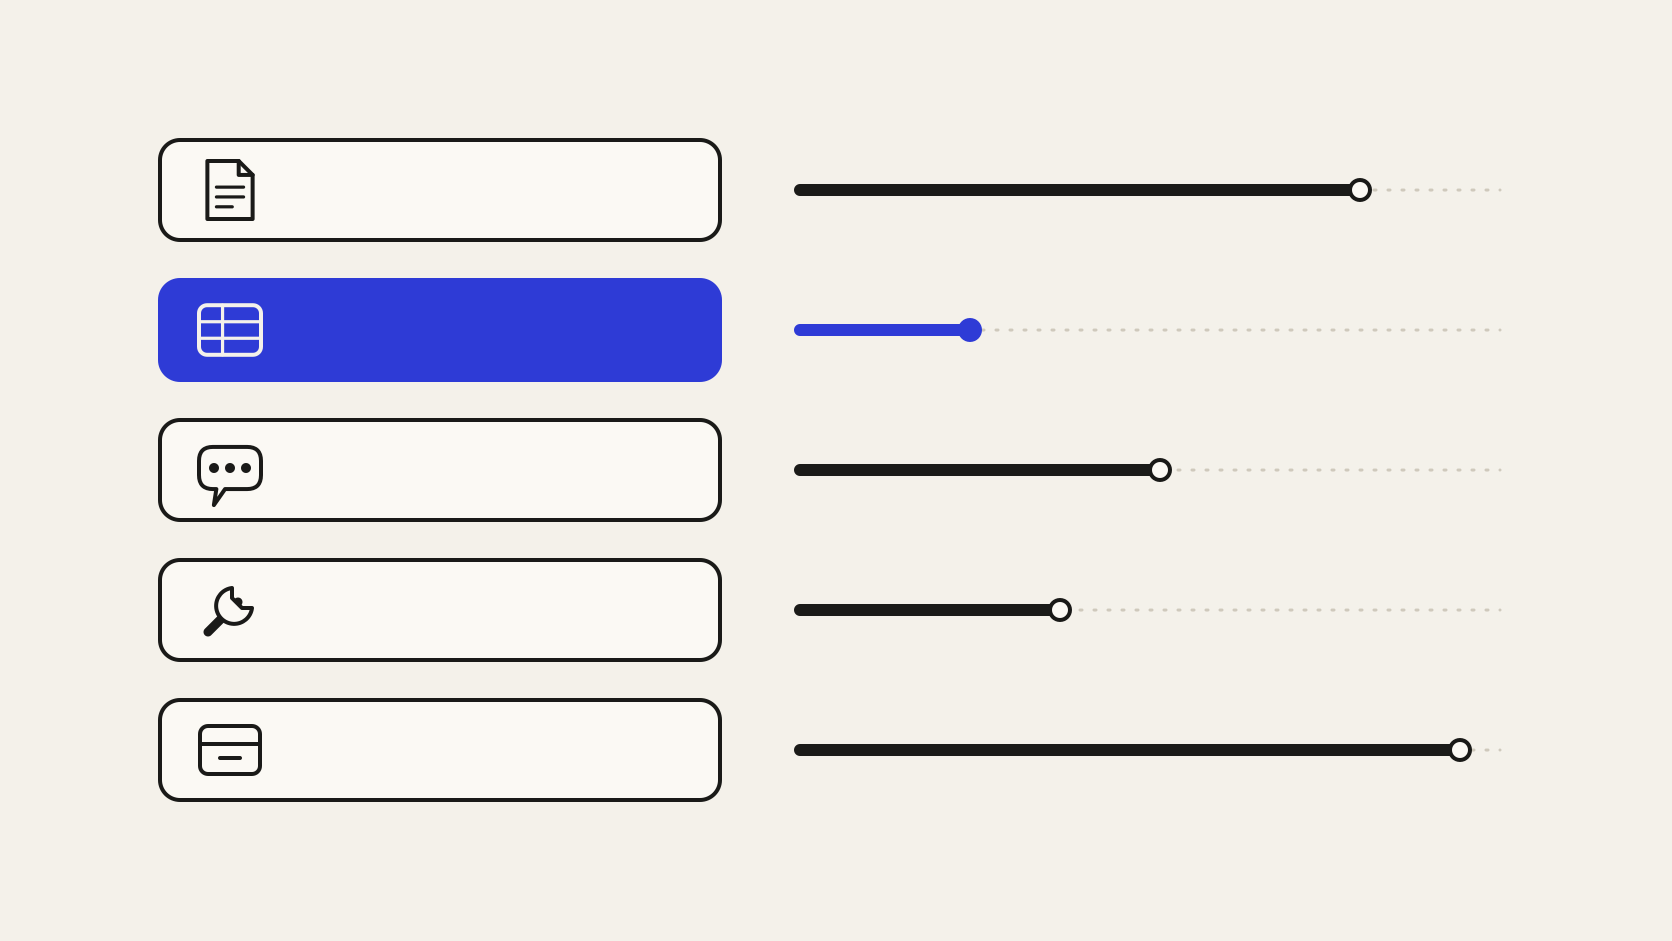
Uma chamada de agente corporativo combina cinco componentes:
Cada componente envelhece em ritmo próprio. A instrução muda a cada versão do agente, o histórico vale para a tarefa em curso, e o dado de um sistema pode mudar entre uma chamada e a seguinte.
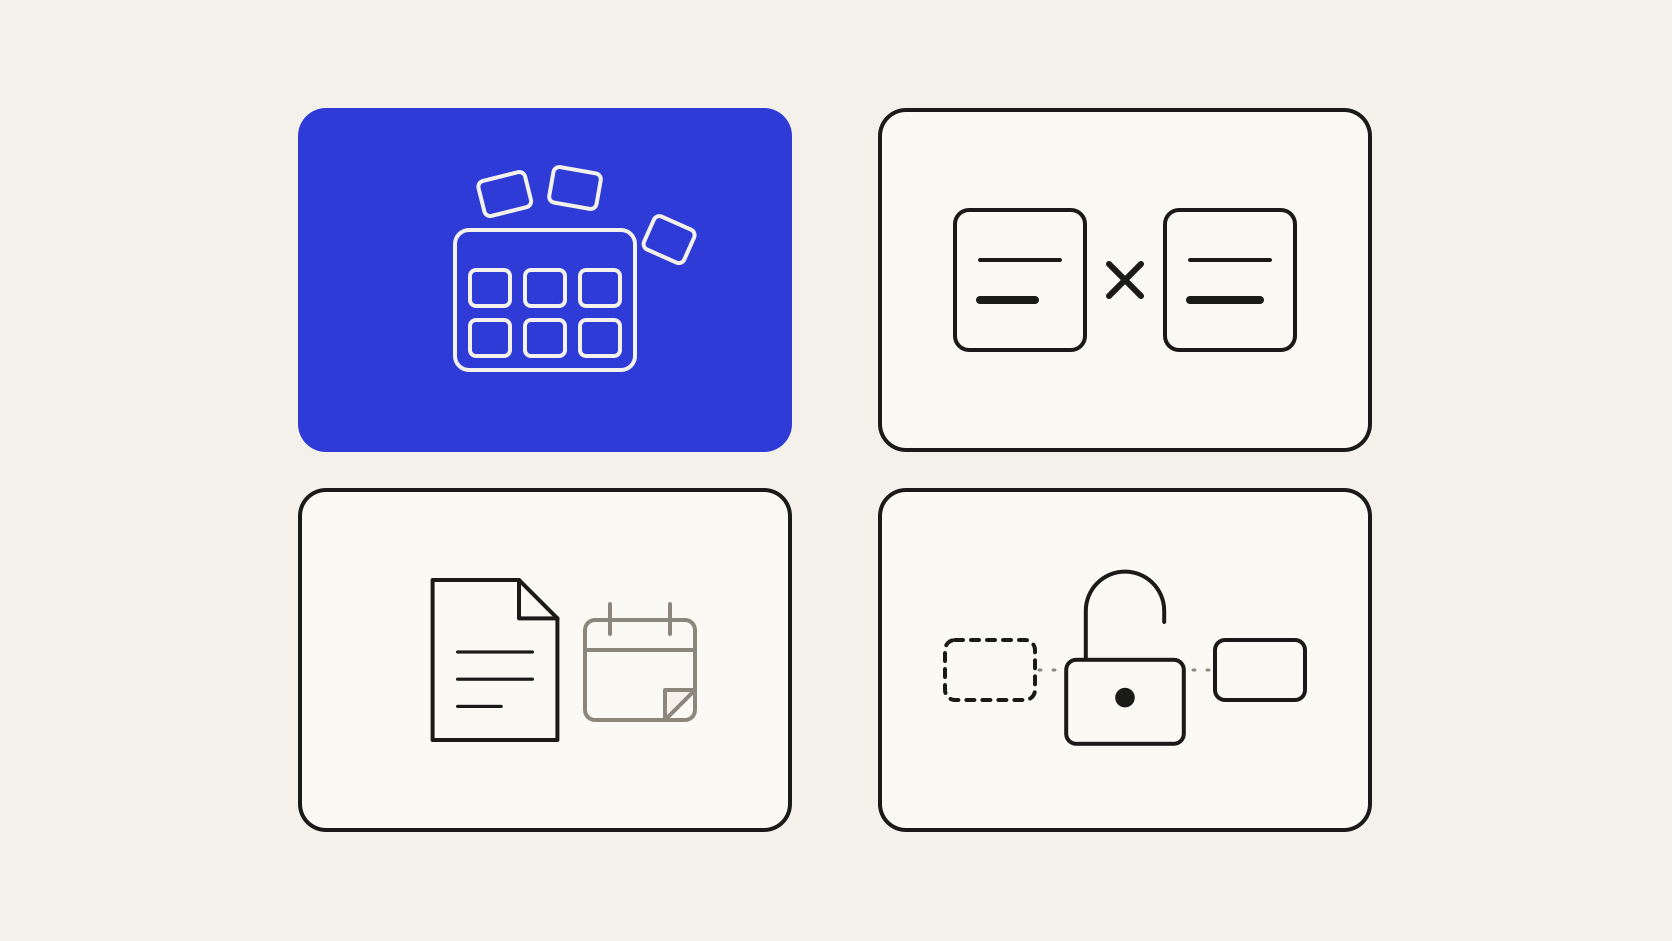
Os erros costumam nascer em um destes quatro pontos:
Em agentes corporativos, a maior parte dos tokens de entrada vem do contexto, porque a instrução é curta e os dados recuperados, o histórico e as descrições de ferramentas são longos. Cada trecho desnecessário é pago em cada chamada e em cada etapa do agente.
O contexto enxuto tem um segundo efeito. Quando a informação chega resolvida e sem conflito, a tarefa exige menos do modelo, e muitas etapas passam a rodar em modelos menores e mais baratos.
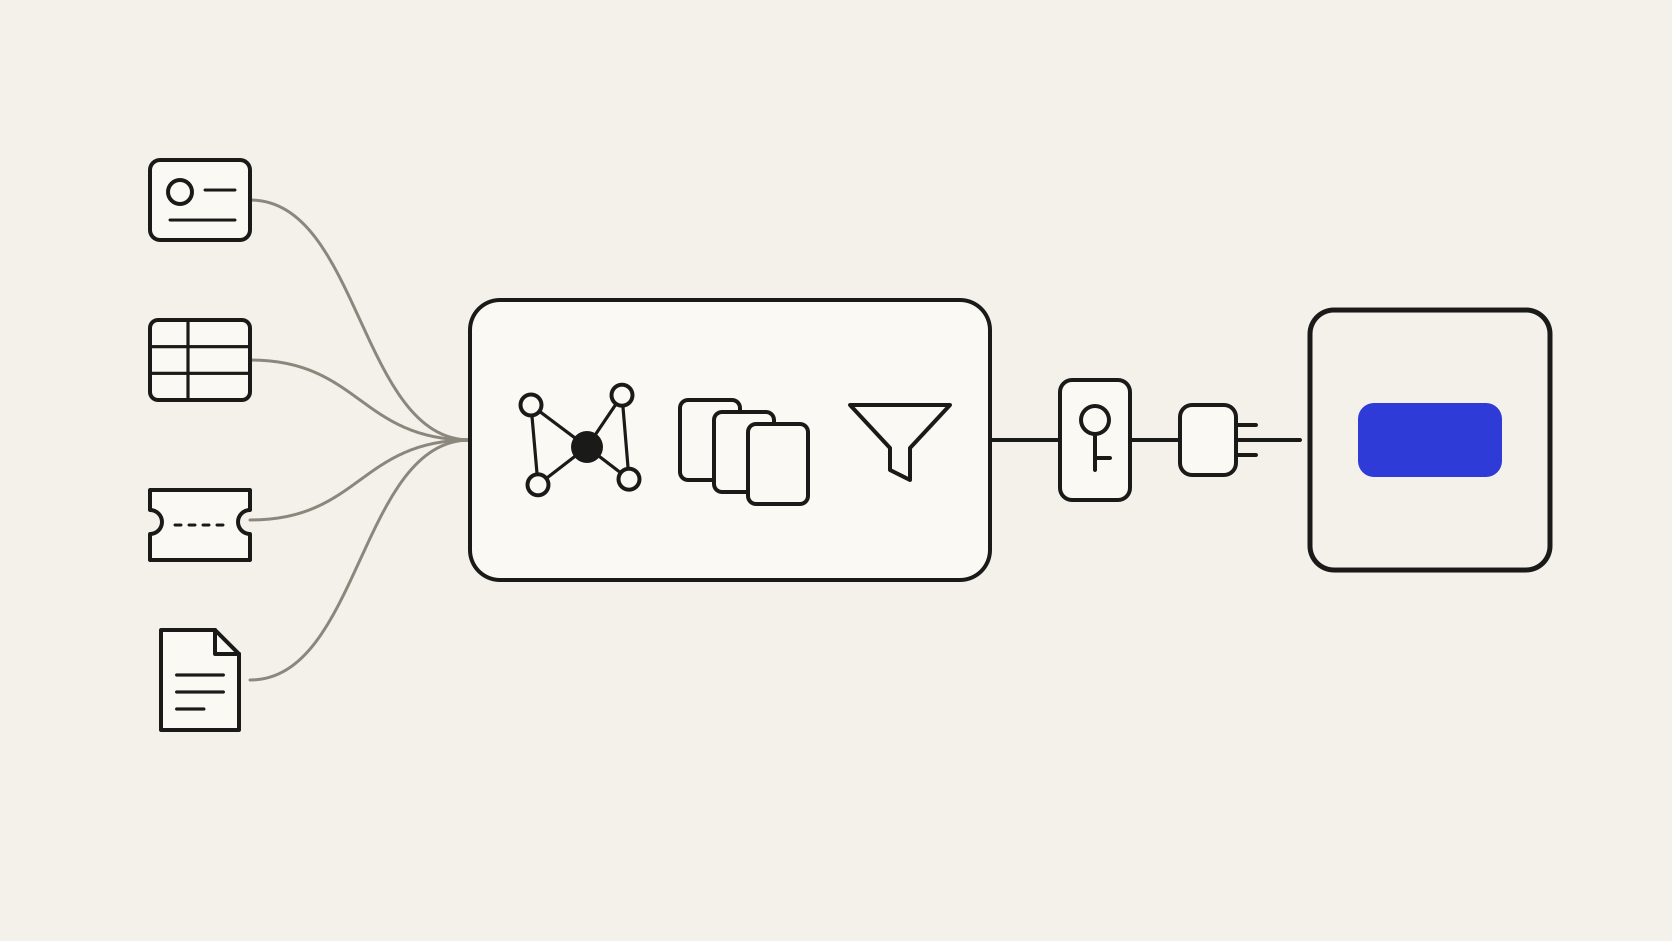
A engenharia de contexto depende de saber, a cada pergunta, quais dados existem, onde estão, qual versão vale e quem pode vê-los. Quando essa resposta é montada dentro de cada agente, cada projeto refaz a mesma integração.
No Company Brain, esse trabalho fica em uma camada comum. O grafo de conhecimento liga o pedido de reembolso ao cliente, à compra original e aos chamados anteriores. A ontologia do negócio define qual política vale para aquele tipo de compra. A camada semântica traduz a pergunta para a consulta certa e devolve só o recorte necessário, com a permissão herdada do sistema de origem e a fonte de cada informação.
Esse recorte é servido ao agente via MCP, o protocolo aberto que conecta modelos a fontes de dados. A janela recebe menos texto, sem valores conflitantes e na versão vigente, e o próximo caso de uso reaproveita o mesmo contexto.
O primeiro passo prático é registrar, para um agente em produção, o que entra em cada chamada: quanto vem da instrução, dos dados recuperados, do histórico e das ferramentas, e quais trechos de fato aparecem na resposta final.
Os trechos que entram e nunca são usados apontam o excesso. As respostas erradas por fonte conflitante ou desatualizada apontam onde o primeiro recorte do Company Brain deve começar. Com esse recorte pronto, a engenharia de contexto de cada agente novo parte de uma camada que já resolve fontes, versões e permissões.