
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma diretora comercial pergunta a um agente qual foi a margem do canal de distribuidores no último trimestre. O agente encontra três tabelas de vendas, escolhe uma e devolve um número. A consulta roda sem erro, e o número está errado: a tabela escolhida não desconta devoluções. Agentes de IA que respondem perguntas sobre os dados da empresa erram assim quando não recebem dados estruturados, isto é, dados com definição, fonte oficial, entidades resolvidas e regras registradas, servidos ao agente de forma organizada. Fornecê-los é o papel do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Um agente desse tipo recebe a pergunta em linguagem natural, identifica as tabelas envolvidas, escreve e executa as consultas e devolve a resposta, às vezes com um gráfico.
A proposta é tirar da fila do time de dados as perguntas recorrentes da diretoria. Os modelos escrevem SQL sintaticamente correto na maior parte das vezes, e as respostas erram mesmo assim.
A pergunta sobre a margem do canal de distribuidores exige, antes de qualquer SQL, quatro decisões que um analista experiente toma sem perceber:
O esquema do banco informa colunas e tipos. Sem dados estruturados que digam qual tabela vale e qual exceção se aplica, o modelo escolhe a opção mais provável: a tabela com o nome mais parecido com a pergunta.
Em uma análise publicada pela a16z em março de 2026, Jason Cui e Jennifer Li observam que, mesmo com modelos muito melhores em gerar código, esses agentes continuam errando, porque o problema vai além do text-to-SQL: a definição das métricas e a fonte correta de cada número estão fora do esquema.
Uma consulta que roda e devolve um número plausível não dispara alerta. A resposta chega formatada e entra na apresentação sem que ninguém refaça a conta. Técnicas melhores de text-to-SQL continuam dependendo dos dados estruturados que recebem.
A camada semântica das ferramentas de BI define métricas como receita, churn e ticket médio com um único cálculo. Ela foi desenhada para painéis, cobre o que o time de dados modelou à mão e envelhece quando quem a mantinha sai da empresa.
A análise da a16z trata a camada de contexto como um conjunto maior, que contém a camada semântica e acrescenta o que os agentes de IA precisam para operar com autonomia:
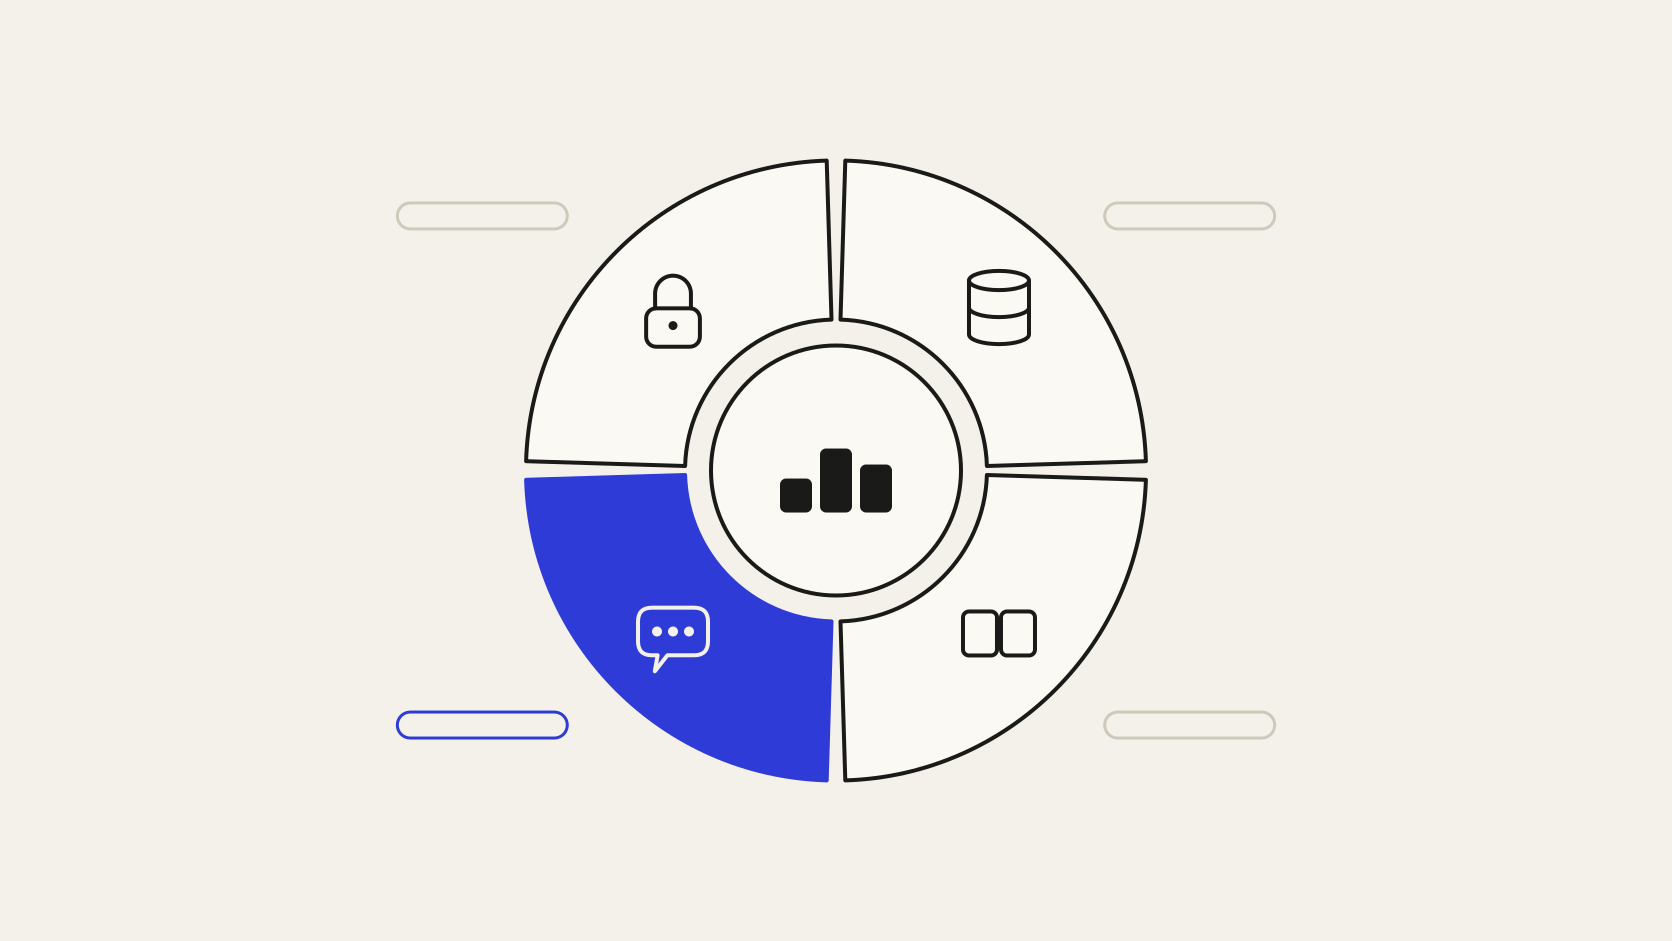
A mesma análise organiza a construção dessa camada em cinco etapas:
A terceira etapa é a que mais pesa. O histórico mostra quais tabelas os analistas usam. O motivo de a consulta de fechamento excluir um grupo de pedidos está na memória de quem a escreveu.
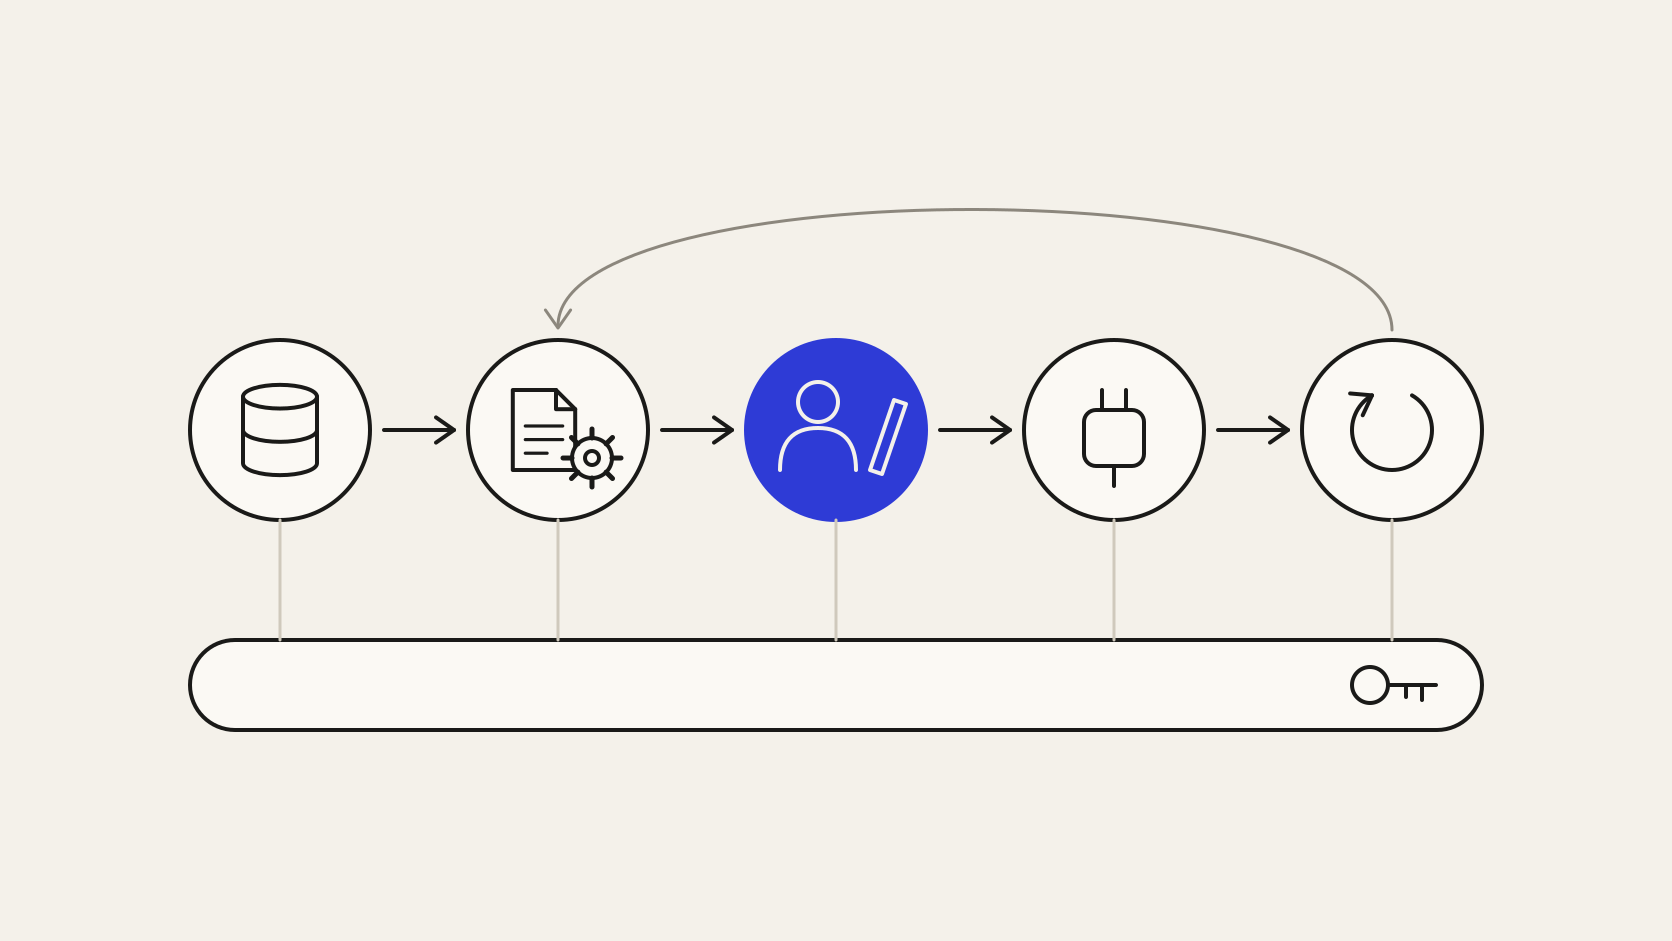
O Company Brain conecta ERP, CRM, data warehouse e documentos uma única vez. O grafo de conhecimento registra as entidades canônicas e liga as filiais ao mesmo distribuidor. A ontologia do negócio guarda o que margem e canal significam na empresa, com a fonte autoritativa de cada atributo. A camada semântica traduz a pergunta para a consulta certa sobre essas definições.
O conhecimento tácito entra pela revisão humana. A controller que conhece a regra das devoluções a registra uma vez, com data de início e responsável, e todos os agentes de IA passam a aplicá-la. Quando a regra muda, ela atualiza o registro.
Os dados estruturados são servidos aos agentes via MCP, com a permissão herdada do sistema de origem: quem não vê margem por cliente no ERP também não a recebe pelo agente. Cada resposta aponta a tabela, a definição e a regra aplicadas.
Uma reclassificação de canais, uma migração de sistema ou uma nova política comercial invalidam regras registradas. Sem um responsável por domínio, os dados estruturados descrevem a empresa de um ano atrás, e os agentes repetem a versão antiga.
Fontes que existem apenas em planilhas pessoais precisam ir para um local consultável antes de entrar no contexto. E uma resposta marcada como errada por quem usa o agente precisa voltar para quem mantém a regra.
As perguntas que a controladoria e a área comercial respondem todo mês, como margem por canal, giro de estoque e taxa de renovação por segmento, são um bom ponto de partida. Elas têm resposta conhecida para comparação.
O trabalho inicial é registrar, com quem as calcula hoje, a fonte autoritativa e as exceções de cada uma e conectar um agente de IA a esse recorte. Cada pergunta nova reaproveita as entidades e as regras já registradas no Company Brain.