
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Um agente de IA conectado ao drive da empresa precisa reunir as decisões do trimestre para o time comercial. Entre os arquivos que ele alcança está a ata de diretoria sobre a compra de outra empresa, com a palavra CONFIDENCIAL no rodapé. O agente processa o rodapé como mais uma linha de texto, e o resumo menciona a negociação. A classificação de dados estava no documento, e nenhum sistema a lia. Fazer essa marcação valer na consulta é uma das funções do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Classificação de dados é a atribuição, a cada conjunto de dados, de um nível de sensibilidade que determina quem pode acessá-lo, por onde pode circular e quais controles o protegem. Um dado restrito exige acesso nominal, criptografia e registro de cada leitura. Um dado público pode ir para o site.
A ideia vem da segurança da informação. O NIST, instituto de padrões dos Estados Unidos, publicou em 2004 o padrão FIPS 199, que categoriza a informação pelo impacto da perda de confidencialidade, integridade ou disponibilidade, em três níveis: baixo, moderado e alto. As escalas corporativas seguem a mesma lógica.
A escala mais usada nas empresas tem quatro níveis:
Sobre a escala correm categorias transversais, que indicam quais obrigações acompanham o dado:
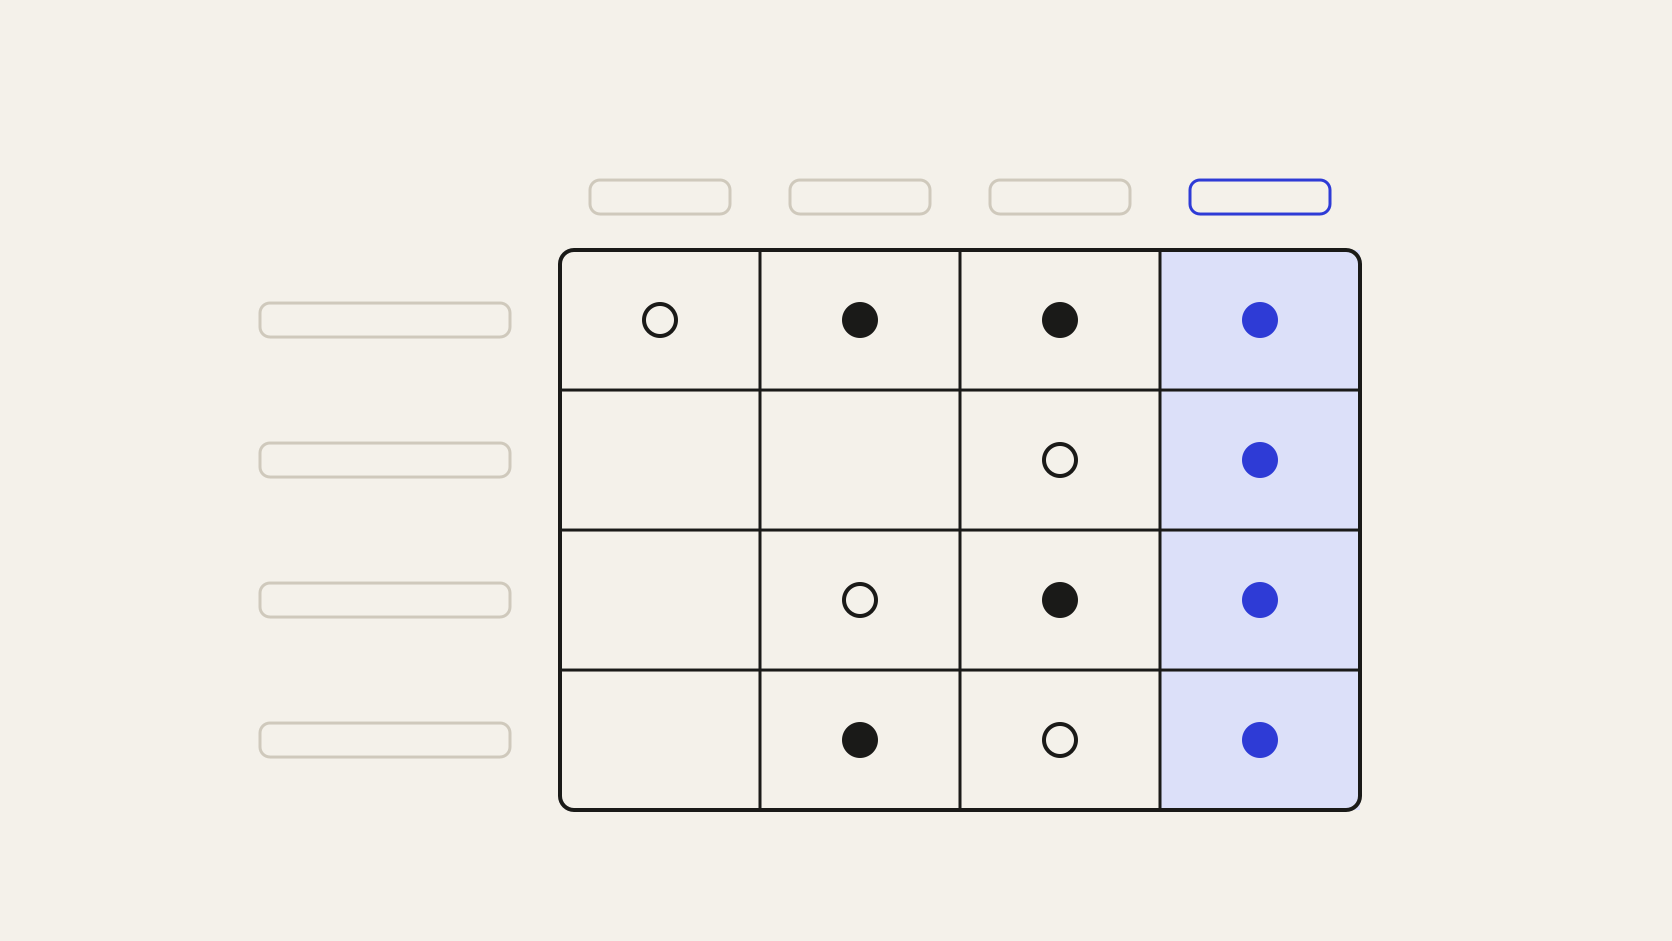
Quem classifica é o dono do dado, a pessoa de negócio que responde por ele. A gerente de RH classifica a base de colaboradores, e o diretor financeiro classifica as projeções de caixa.
A classificação de dados acontece em três granularidades: por fonte, quando o sistema de folha inteiro recebe nível restrito; por campo, quando CPF e telefone ganham nível próprio no CRM; e por documento, quando cada contrato recebe o nível do seu conteúdo.
No volume de uma empresa, regras automáticas reconhecem padrões, como números de CPF, termos de diagnóstico ou cabeçalhos de contrato, e sugerem um nível. O dono revisa os casos ambíguos, porque um falso público expõe o dado e um falso restrito trava o trabalho.
Muitos programas terminam em uma política aprovada e em um carimbo no rodapé dos documentos. O carimbo orienta quem lê com atenção. Os sistemas tratam o rodapé como texto comum.
Outra versão vive em planilha. A área de segurança mantém a lista de sistemas com seus níveis, e nenhuma ferramenta consulta essa lista antes de entregar um dado.
Antes da IA, boa parte do dado sensível ficava protegida pelo esforço de encontrá-lo, em subpastas e anexos que ninguém abria. Um agente lê esse material em segundos, e o resultado chega a quem fez a pergunta.
Por isso a classificação vem antes da conexão das fontes. Ela permite decidir o que pode entrar em cada ferramenta, em cada contexto e para cada pessoa. Um laudo de afastamento pode compor a resposta para a analista de RH responsável pelo caso e fica fora da resposta para o gestor da área.
Um resumo da ata de aquisição carrega a informação da ata e, por isso, herda a classificação dela. Uma tabela que combina dados internos com uma coluna restrita assume o nível mais alto entre as entradas.
Sem essa herança, a IA abre um caminho de reclassificação silenciosa: o documento restrito continua protegido, e o resumo dele circula no canal do time.
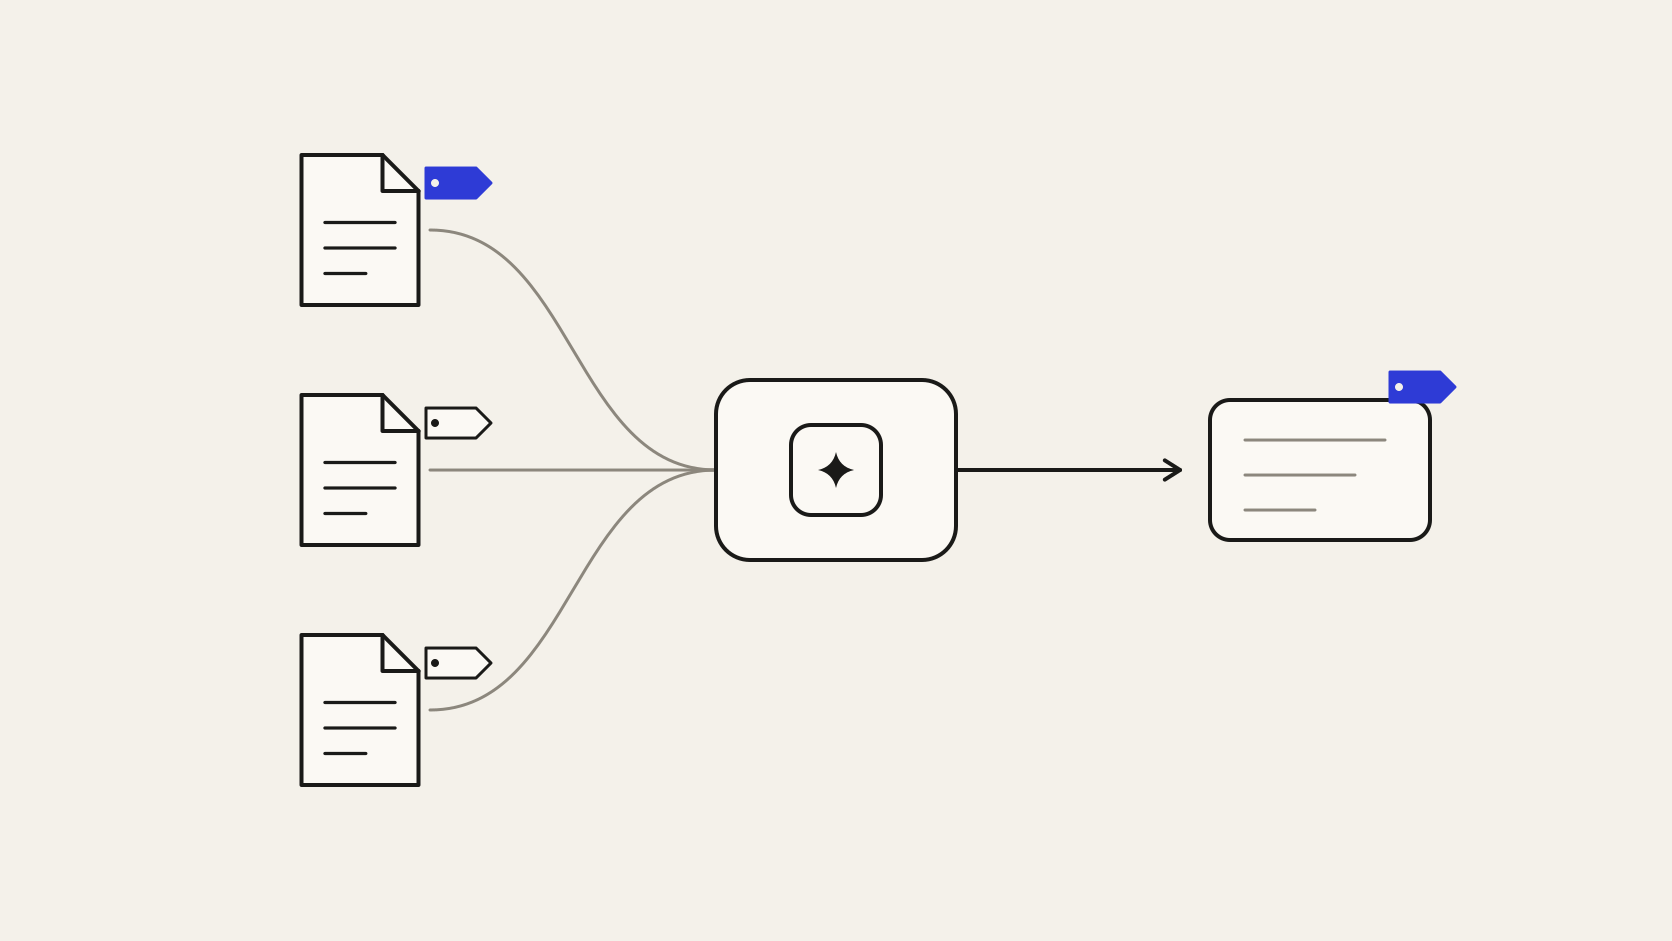
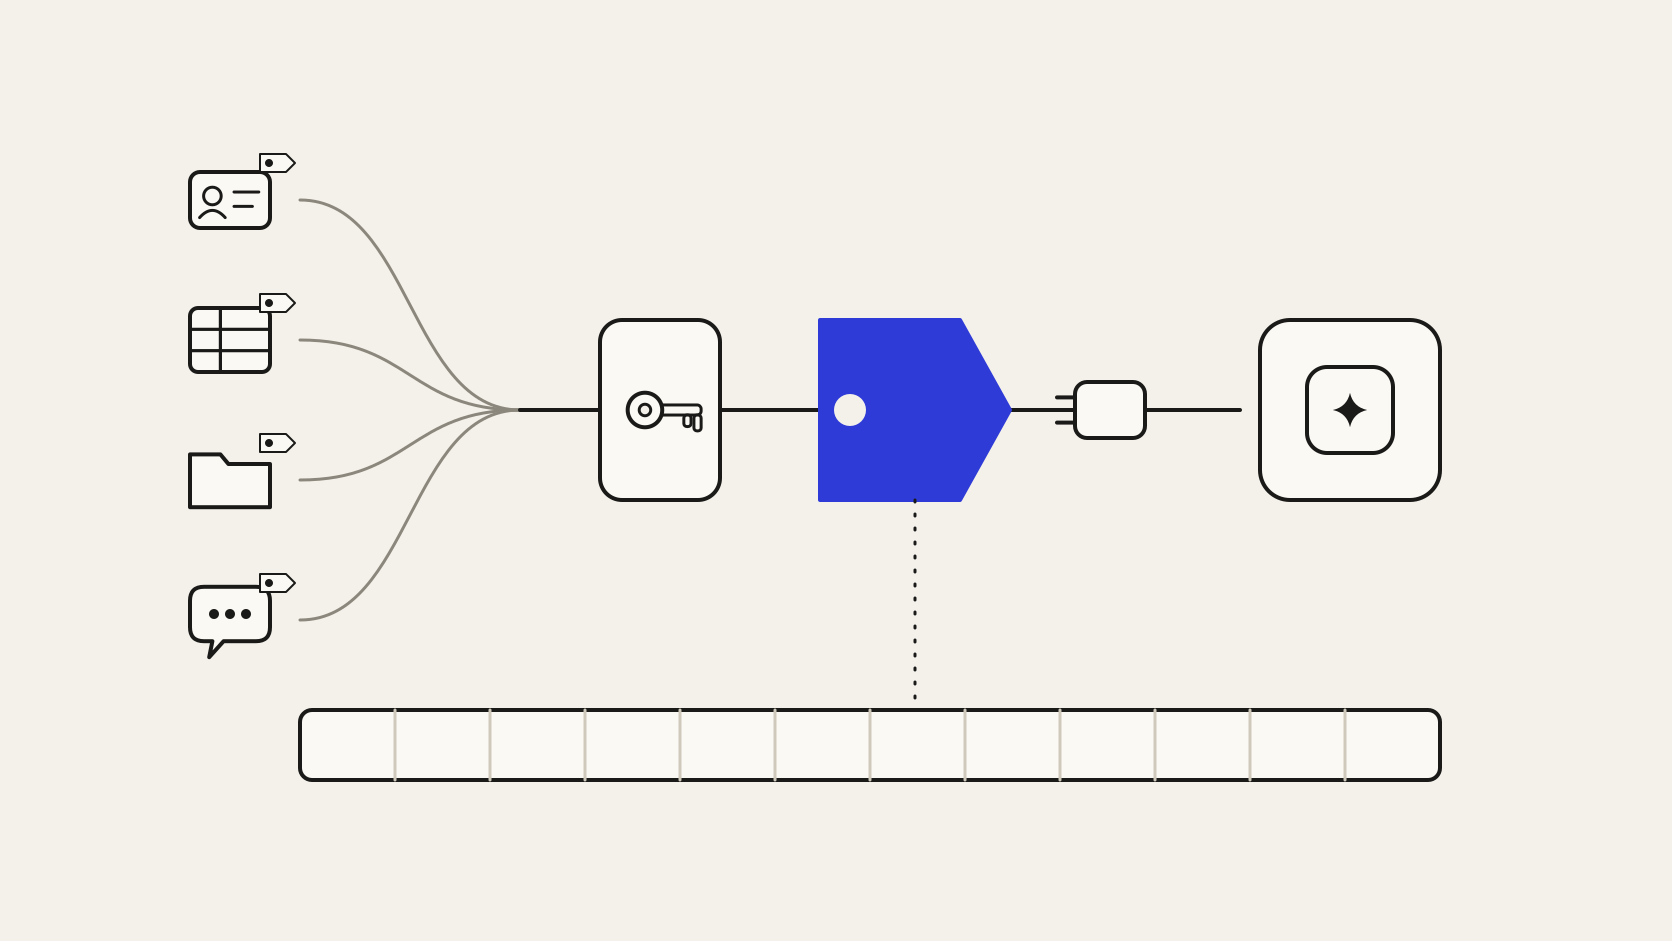
O Company Brain conecta CRM, ERP, helpdesk, drive e demais fontes uma vez e organiza esses dados em grafo de conhecimento, ontologia do negócio e camada semântica. A classificação de dados entra como atributo das entidades e dos campos, ao lado da permissão herdada do sistema de origem.
A cada pergunta, o recorte passa por duas checagens. A permissão herdada confirma se a pessoa já vê aquele registro na fonte. A classificação confirma se aquele nível e aquela categoria podem compor a resposta naquele contexto e naquele modelo. Só então o recorte é servido via MCP, o protocolo aberto que conecta modelos a fontes de dados.
A ontologia guarda a regra de herança, e um resumo gerado a partir de entidades restritas é registrado com o nível mais alto entre as fontes. Cada resposta aponta a origem e a classificação de cada dado.
A arquitetura aplica a classificação que existe. Uma pasta interna pode passar a receber laudos. Sem revisão periódica pelo dono, o nível registrado descreve uma situação antiga.
E-mails, transcrições e documentos longos misturam trechos de níveis diferentes no mesmo arquivo. As regras automáticas erram nos casos ambíguos, e parte da classificação de dados continua dependendo de revisão humana.
Classificar todo o acervo antes do primeiro caso de uso tende a paralisar o projeto. O ponto de partida prático é listar as fontes que o primeiro agente vai consultar, nomear o dono de cada uma e definir o nível mínimo por fonte.
Na mesma rodada, cada dono marca os campos e as pastas que fogem desse nível, como a coluna de diagnóstico em um sistema de RH classificado como interno. Essas marcações entram no Company Brain antes da conexão, e cada caso de uso seguinte acrescenta apenas as fontes ainda não classificadas.