
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma engenheira de dados precisa montar um relatório de devoluções e encontra no data warehouse quatro tabelas com nomes parecidos: pedidos, pedidos_final, pedidos_novo e pedidos_bkp. Ela não sabe qual é atualizada, quem mantém cada uma nem se alguma contém dado pessoal. O catálogo de dados existe para responder essas perguntas. Ele também é uma fonte valiosa para projetos de IA e um dos pontos de partida do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Um catálogo de dados lista tabelas, visões, relatórios, arquivos e pipelines da empresa e registra, para cada ativo, as informações que permitem usá-lo com segurança:
A estrutura tem padrão aberto. O W3C mantém o DCAT, vocabulário para descrever conjuntos de dados e serviços em catálogos publicados na web, cuja versão 3 virou recomendação em 2024. Catálogos corporativos aplicam a mesma lógica dentro da empresa.
O catálogo foi desenhado para pessoas que procuram a tabela confiável. Uma analista pesquisa por um termo, lê a descrição, confere a data da última atualização e, na dúvida, escreve para o dono. O julgamento sobre usar ou não aquele ativo continua com ela.
Essa origem explica o formato. O catálogo descreve conjuntos de dados em texto e em campos estruturados, para leitura humana e para busca. Parte do conteúdo é coletada automaticamente por conectores que leem esquemas, consultas e logs de execução. A outra parte, como descrições e definições de negócio, é escrita por pessoas, e é ela que mais envelhece.
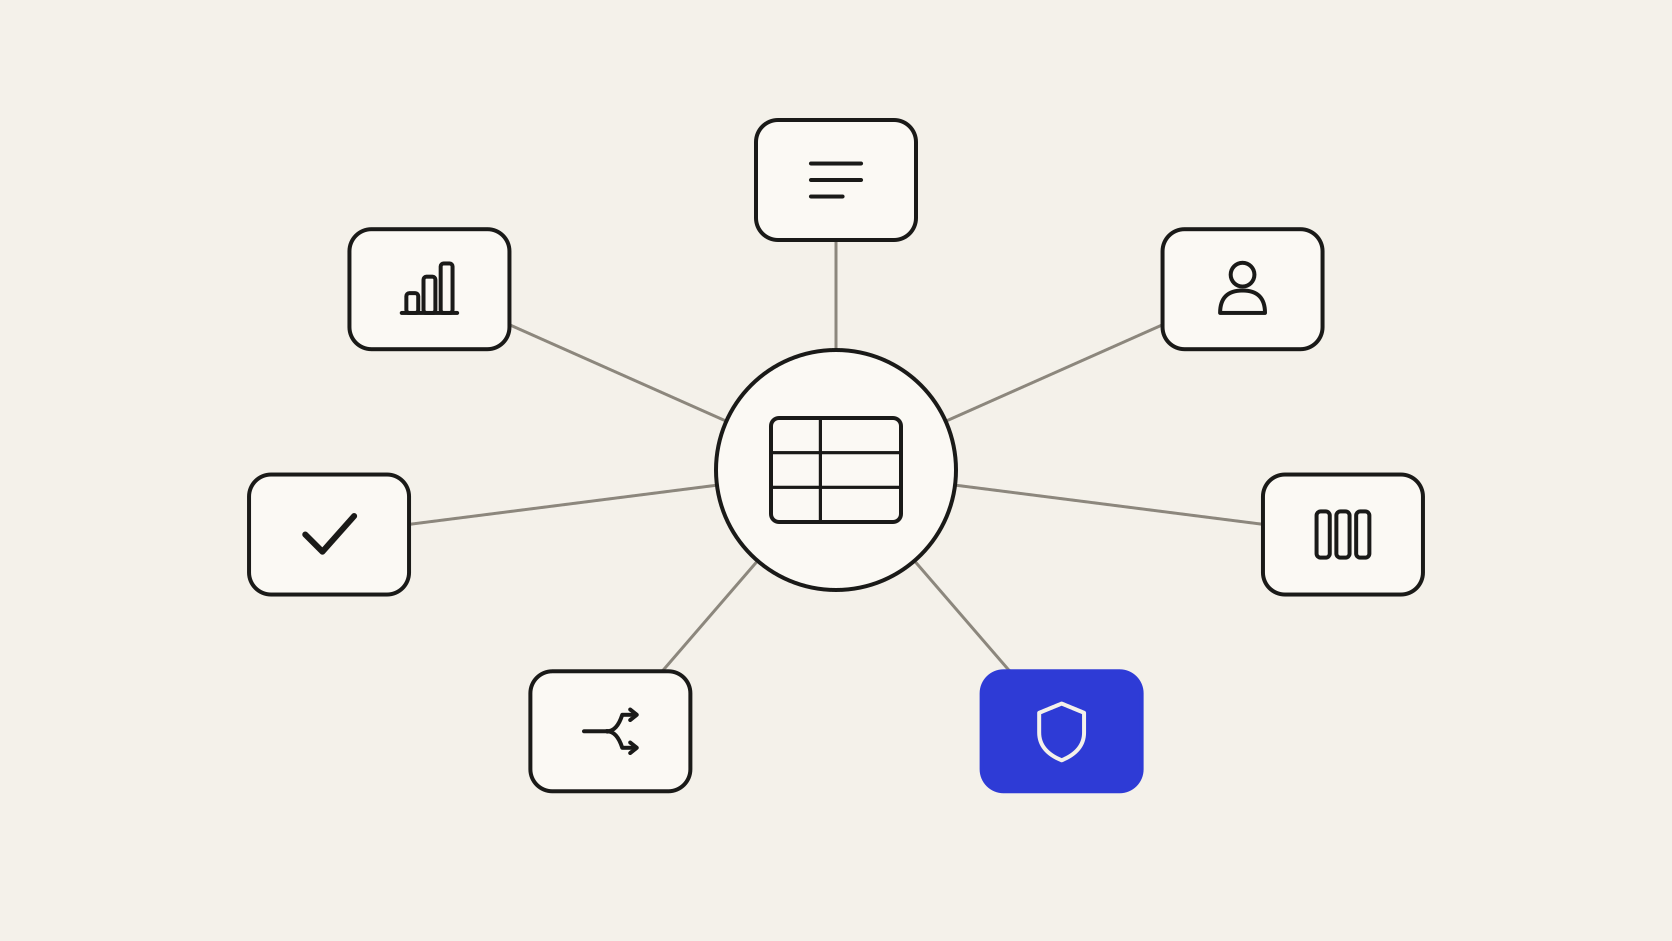
Parte do que o catálogo registra é útil para agentes de IA sem nenhuma adaptação. O dono indica a quem recorrer quando uma resposta parece errada. A classificação de sensibilidade sinaliza quais colunas exigem cuidado antes de chegar a um modelo. As definições do glossário orientam a interpretação de termos de negócio, e a certificação indica qual das quatro tabelas de pedidos usar.
O catálogo descreve tabelas. Um agente que responde se o pedido de um cliente foi entregue precisa trabalhar no nível do registro. Para servir agentes, o catálogo de dados precisa ser complementado com quatro elementos:
As políticas de acesso do catálogo costumam operar no nível da tabela, e definem quem pode solicitar acesso a um conjunto de dados. O agente precisa de um filtro aplicado a cada consulta, em nome de quem perguntou, com o mesmo recorte que essa pessoa tem no sistema de origem.
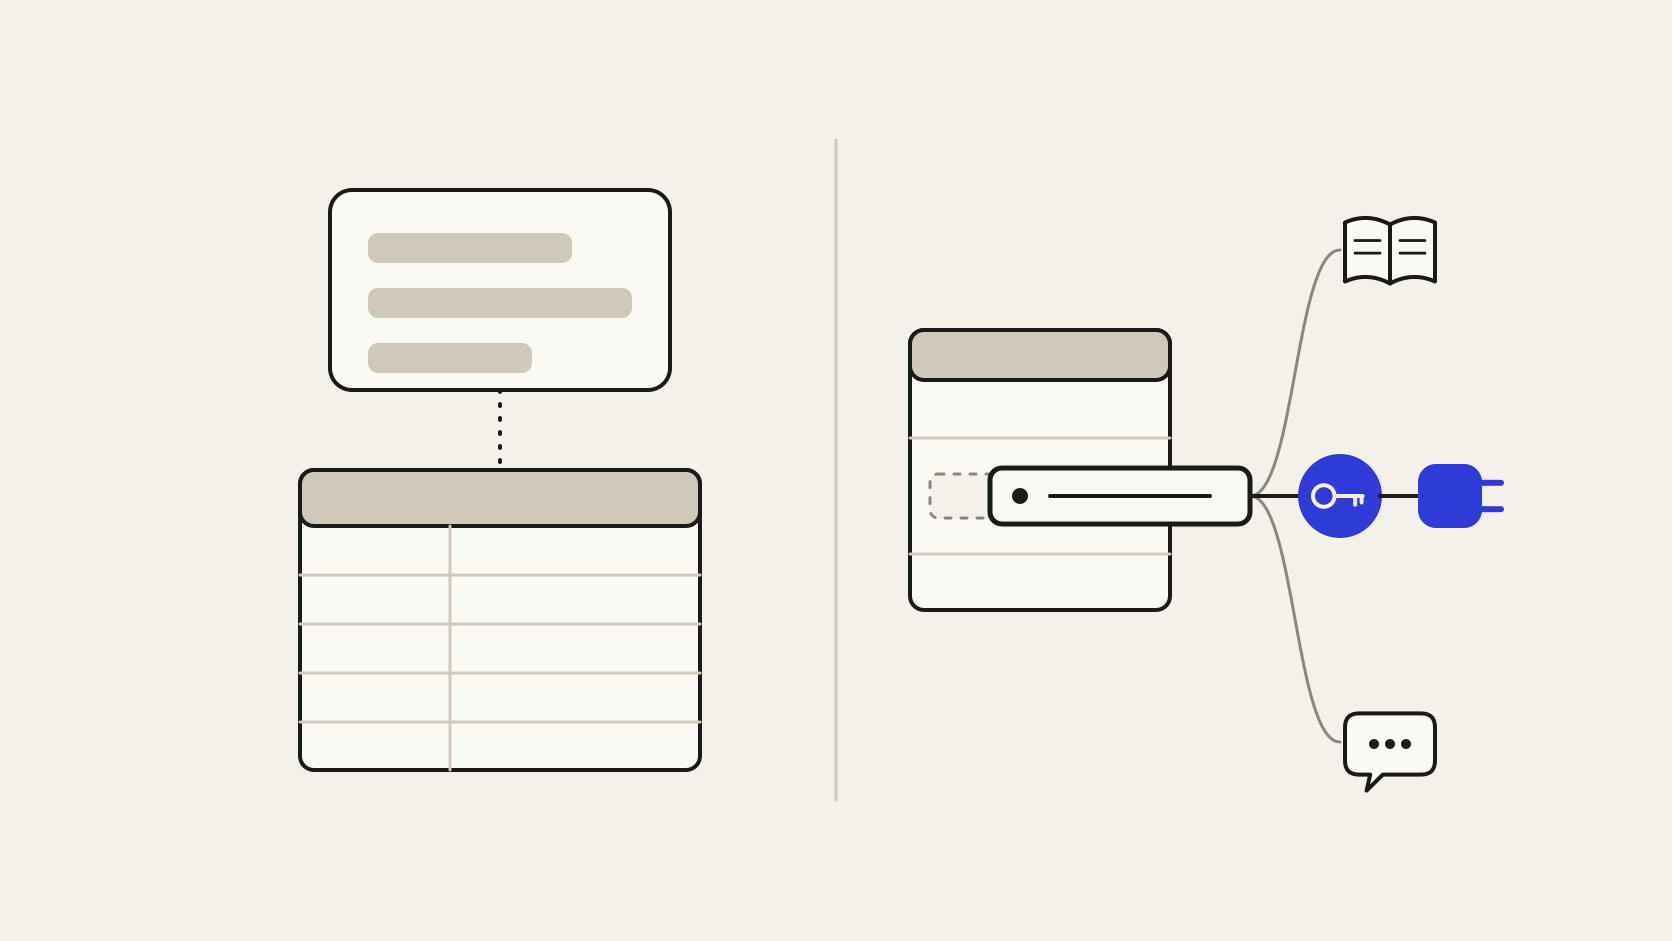
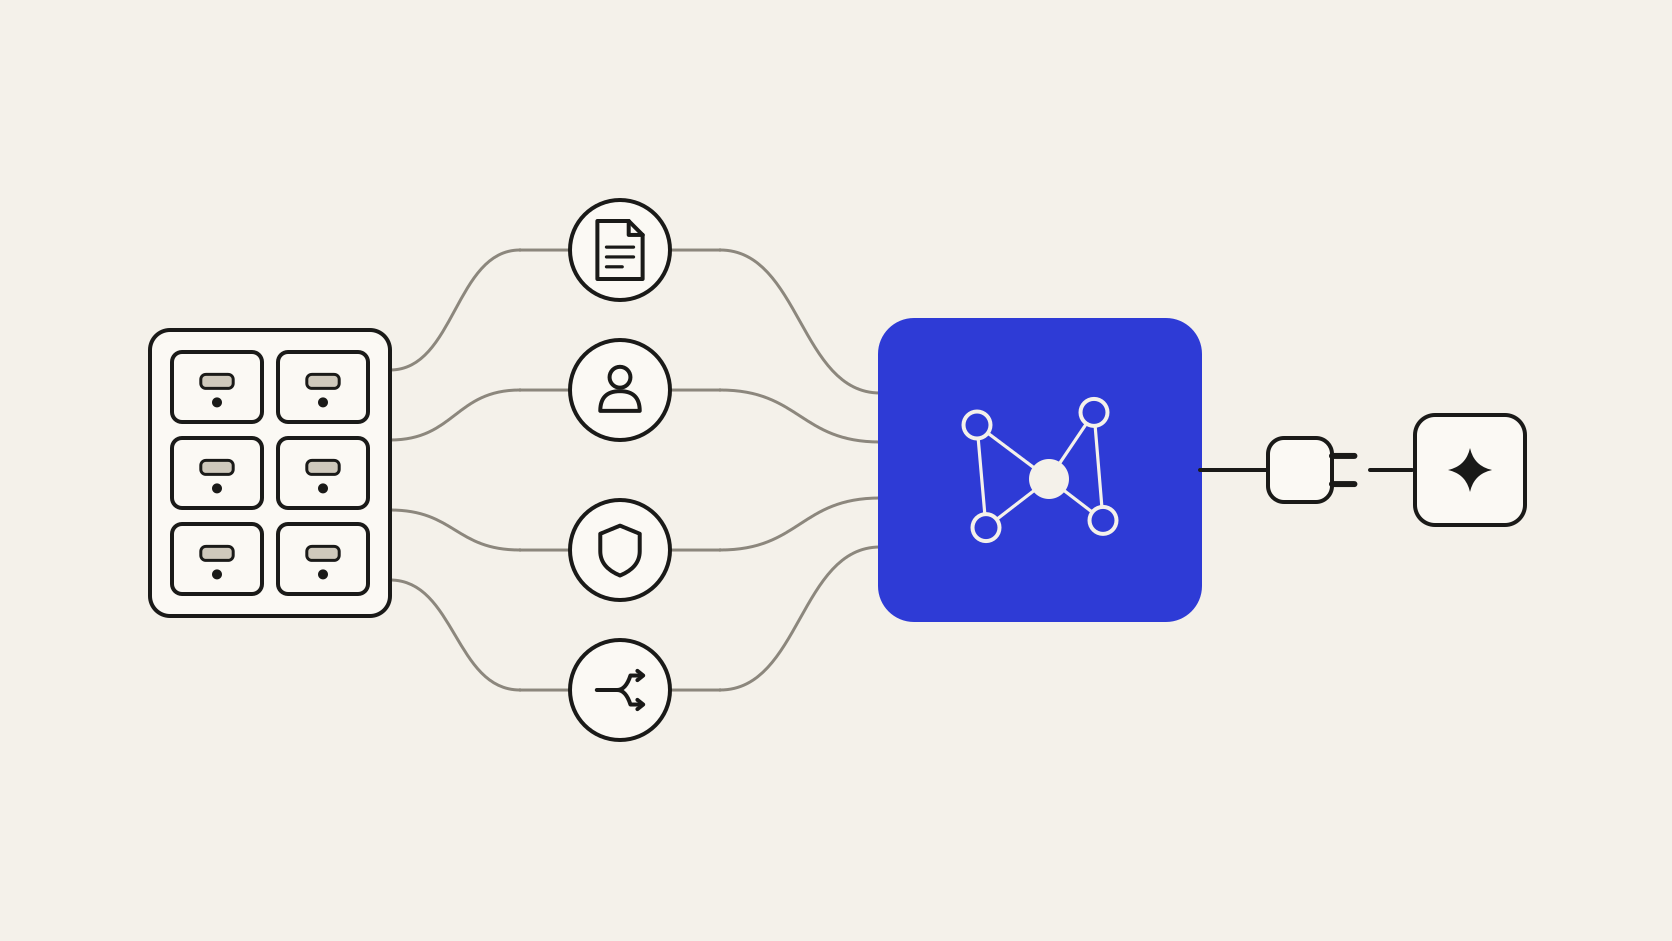
Uma empresa que já mantém um catálogo de dados tem parte do trabalho feita. O Company Brain importa descrições, donos, classificações e termos do glossário e os usa como ponto de partida. O glossário alimenta a ontologia do negócio. A linhagem reforça a rastreabilidade de cada resposta. A classificação complementa as regras de acesso, com a permissão herdada do sistema de origem.
A partir daí, o grafo de conhecimento liga os registros entre sistemas, a camada semântica traduz a pergunta para a consulta certa e o recorte é servido ao modelo via MCP. O projeto de IA começa pelo que o time de dados já documentou, e o primeiro caso de uso chega antes à produção.
Quando a descrição diz que a tabela é atualizada todo dia e o processo de carga parou há meses, uma analista atenta percebe pela data do último registro. Um agente que consome esse metadado repete a informação com a autoridade de fonte oficial, e o erro passa a circular em respostas que citam o catálogo de dados como origem.
Por isso, reaproveitar o catálogo exige metadados com dono e data de revisão, coleta automática do que pode ser coletado, como esquema, linhagem e uso, e revisão humana das definições de negócio.
O primeiro passo é reunir as perguntas do primeiro caso de uso de IA e listar as tabelas e os termos que elas tocam. Em seguida, conferir no catálogo de dados se cada ativo tem dono, definição atual e classificação. As lacunas mostram o trabalho que vem antes, e o que está completo entra no Company Brain como base.