
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Os dados de uma empresa estão organizados para os sistemas que os gravam. O CRM tem uma tabela de oportunidades com um campo de estágio codificado, o ERP tem lançamentos com centros de custo numerados e o helpdesk tem chamados com categorias que mudaram várias vezes desde a implantação. As pessoas fazem perguntas em outra língua, a do negócio. A camada semântica é a tradução entre as duas. Ela é um dos três componentes do Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
O conceito vem do business intelligence. Antes dele, cada analista escrevia a própria consulta para calcular receita, margem ou ticket médio, e relatórios diferentes mostravam números diferentes para o mesmo indicador. A camada semântica centralizou essas definições: a métrica passou a ser escrita uma vez, com nome de negócio, e as ferramentas de visualização passaram a consumi-la do mesmo lugar.
Esse desenho continua válido. Ferramentas de BI e plataformas de dados oferecem camadas semânticas para que receita líquida tenha a mesma fórmula no painel da diretoria e na planilha do controller.
No BI, as perguntas chegam estruturadas: alguém escolhe a métrica, o filtro e o período em um painel. Com agentes de IA, a pergunta chega em linguagem natural, com ambiguidades que o painel nunca precisou resolver. Perguntar quanto a empresa faturou com os clientes do Sul no último trimestre exige identificar qual métrica é faturamento, quais registros são clientes do Sul, qual recorte de trimestre a empresa usa e quais dados quem perguntou pode ver.
Cada uma dessas decisões tem mais de uma resposta possível. O trimestre pode ser o do calendário ou o do ano fiscal. Clientes do Sul podem ser definidos pelo endereço de faturamento ou pela regional comercial que atende a conta. Faturamento pode incluir ou excluir impostos e devoluções. Uma pessoa da área resolve essas escolhas pelo hábito. Um agente de IA só aplica a escolha certa se ela estiver registrada.
A camada semântica do Company Brain faz esse trabalho antes de qualquer consulta. Ela identifica os termos, busca na ontologia do negócio a definição que vale para cada um, localiza no grafo de conhecimento as entidades envolvidas e monta a consulta para os sistemas de origem.
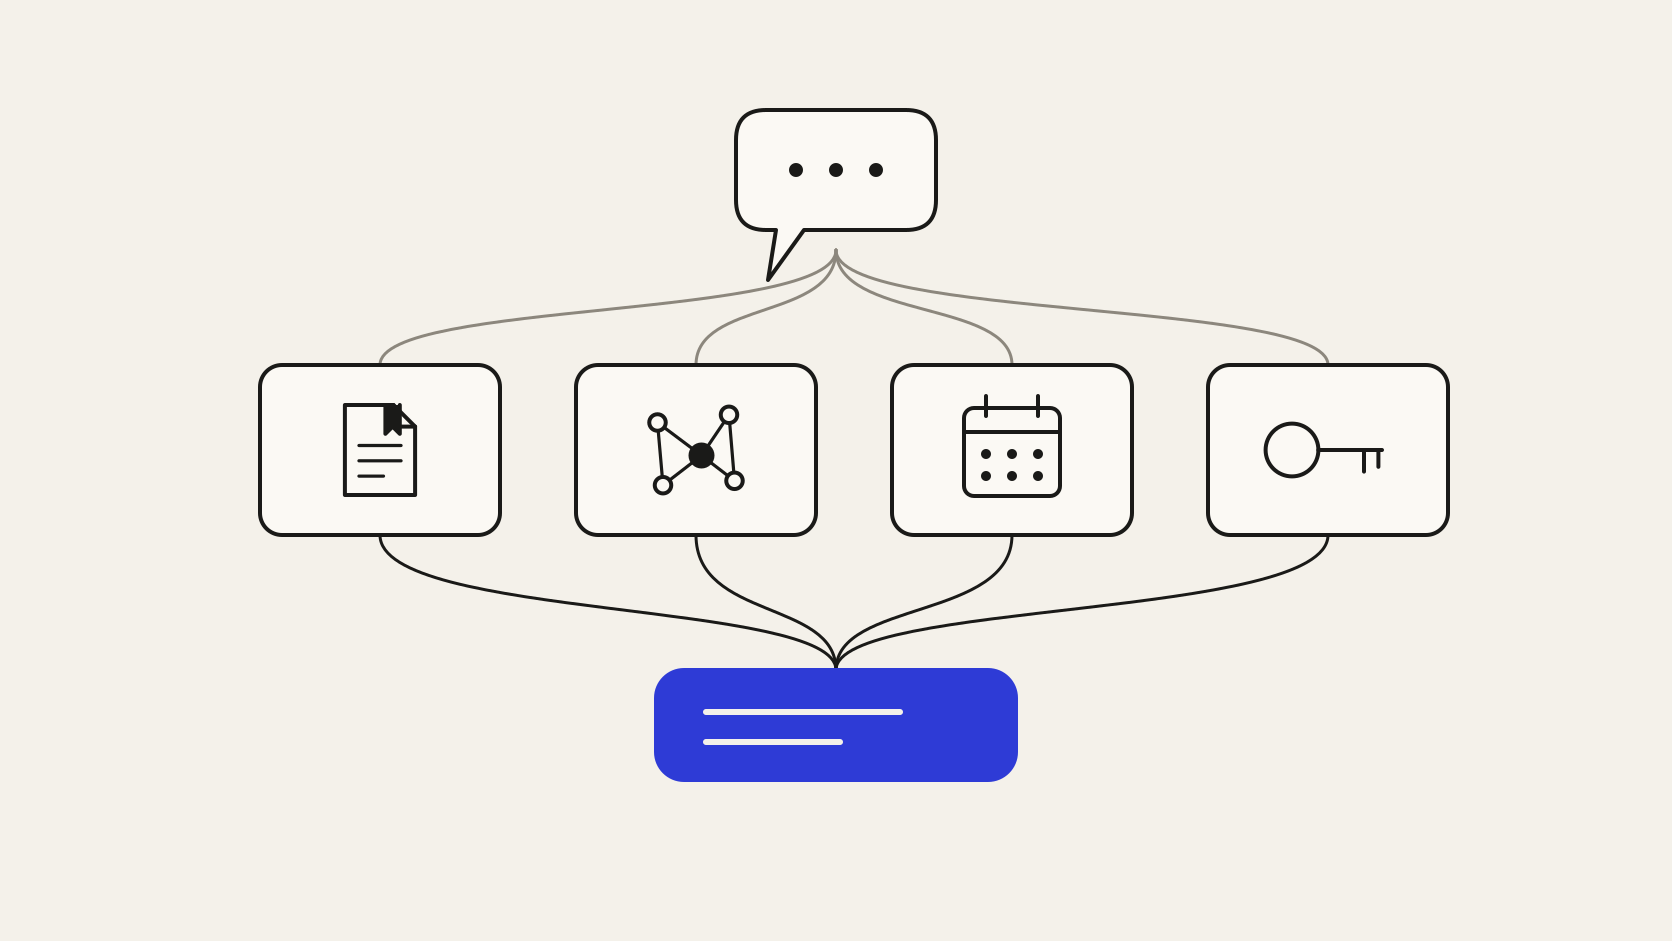
Uma abordagem comum em pilotos é pedir ao modelo de linguagem que escreva a consulta SQL a partir da pergunta, com o esquema do banco no prompt. Em demonstração, com tabelas bem nomeadas e perguntas simples, o resultado convence. Em produção, o modelo precisa adivinhar que um código de estágio específico significa contrato assinado, que clientes do Sul dependem de uma tabela de regiões em outro banco e que faturamento exclui devoluções.
Cada adivinhação é uma chance de erro silencioso, porque a consulta roda e devolve um número plausível. A camada semântica tira essas escolhas do modelo e as coloca em definições mantidas pelas áreas responsáveis. O modelo recebe o resultado já calculado, acompanhado da definição usada.
Há ainda um efeito sobre custo. Para gerar SQL com alguma chance de acerto, o prompt precisa carregar o esquema das tabelas, exemplos de consultas e notas sobre os campos. Esse texto acompanha todas as chamadas e cresce a cada sistema incluído. Com as definições resolvidas antes, o modelo recebe o resultado e um resumo curto da regra, e a mesma tarefa cabe em um modelo de custo menor.
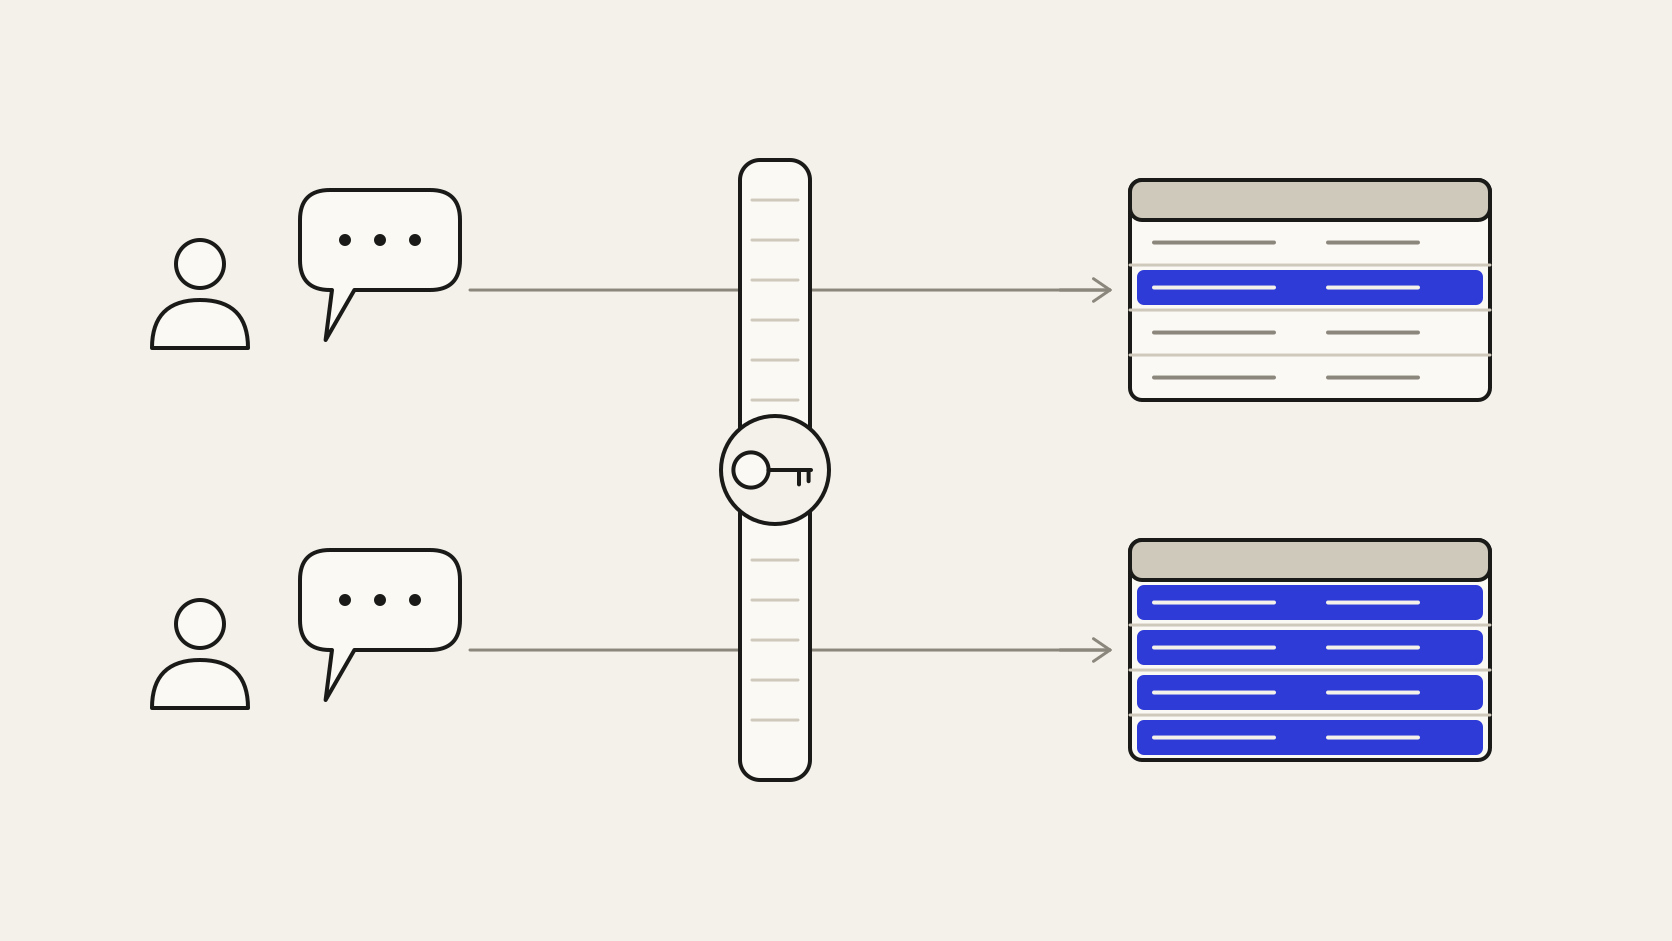
Toda consulta montada nessa etapa carrega a identidade de quem perguntou. No Company Brain, a permissão é herdada do sistema de origem: o vendedor recebe o faturamento da própria carteira, e a diretoria financeira recebe o consolidado. O filtro é aplicado na consulta, e o modelo recebe apenas as linhas que a pessoa já pode ver no sistema.
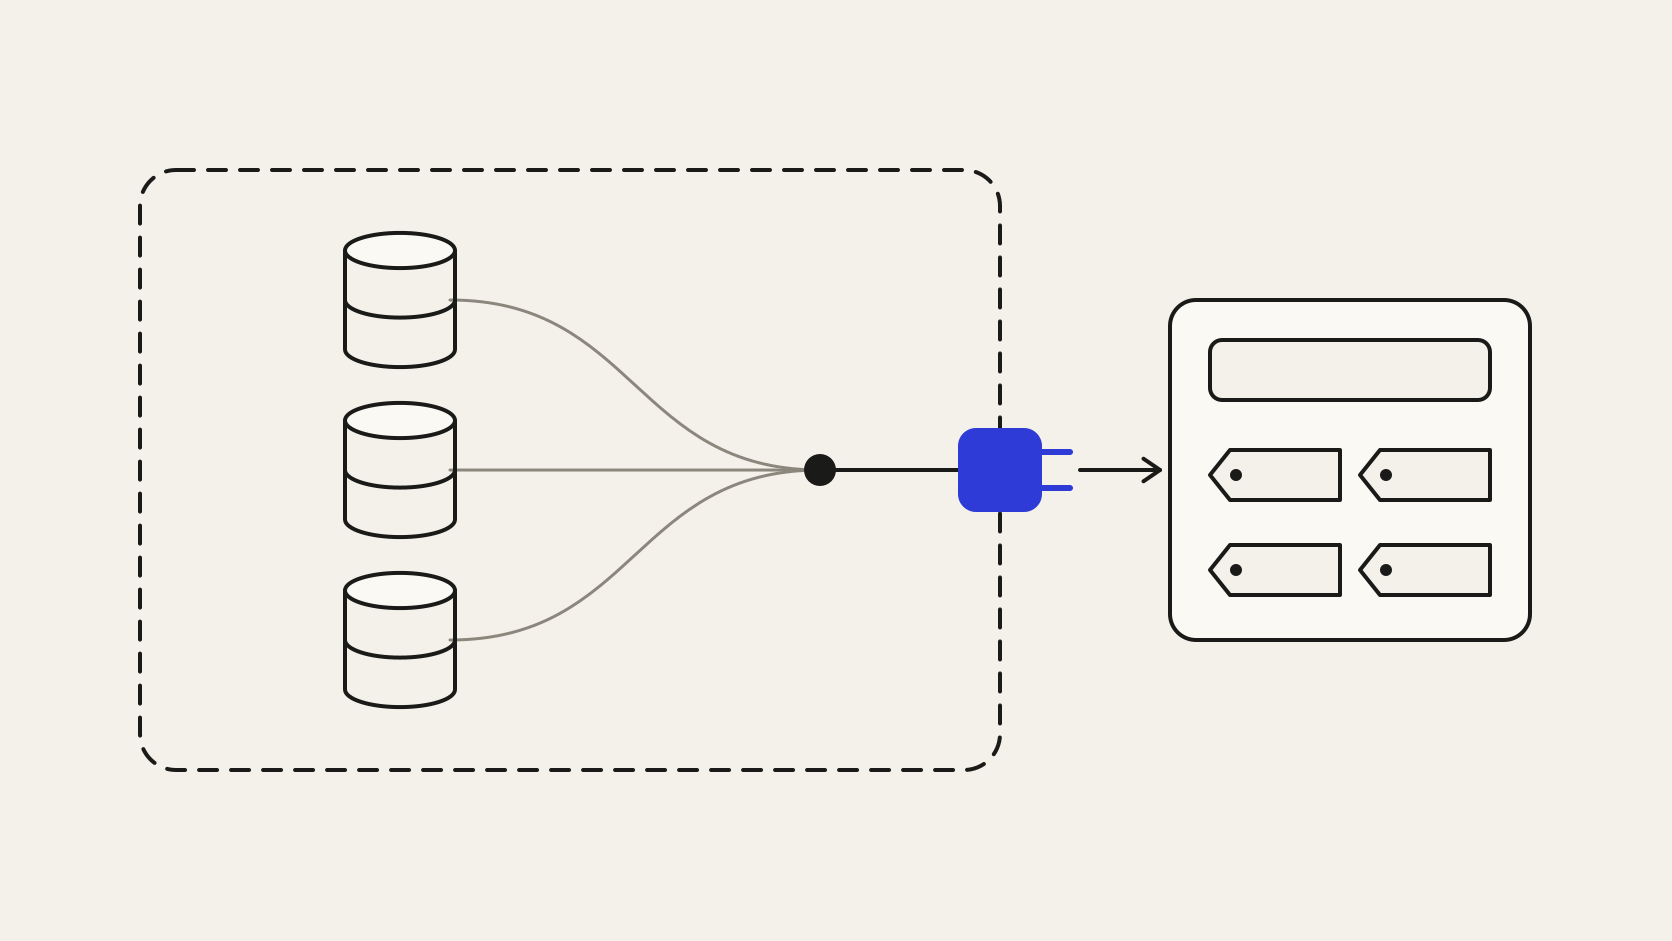
O mesmo desenho sustenta a soberania de dados. Os dados permanecem nos sistemas da empresa, a camada semântica consulta a origem no momento da pergunta e o modelo recebe apenas o recorte necessário, servido via MCP, o protocolo aberto que conecta modelos a fontes de dados. Nessa arquitetura, nenhuma base é copiada em bloco para o provedor do modelo.
Como a tradução é explícita, ela pode ser exibida. A resposta sobre o faturamento do Sul vem acompanhada da definição de faturamento aplicada, do recorte de região, do período e dos sistemas consultados. Quem recebe o número consegue verificar de onde ele saiu sem pedir a consulta a um analista.
A conversa sobre confiança em IA muda de assunto. Ela passa a tratar da definição aplicada e da fonte consultada, temas que as áreas de negócio sabem avaliar e corrigir.
O ponto de partida prático é o conjunto de perguntas que já chega à equipe de dados toda semana. Elas indicam quais métricas, entidades e recortes precisam estar definidos primeiro. Poucas métricas bem definidas atendem mais perguntas reais do que um modelo completo da empresa ainda em construção.
Cada métrica nova entra com definição, área responsável e fontes nomeadas. A partir da segunda, as entidades e regras já cadastradas são reaproveitadas, e o tempo para responder um novo tipo de pergunta diminui à medida que o vocabulário da empresa fica registrado.
Se a empresa já mantém uma camada semântica de BI, ela é uma fonte valiosa. As métricas definidas ali podem ser incorporadas ao Company Brain, que acrescenta o vínculo com as entidades do grafo, a herança de permissão e a entrega aos agentes de IA.