
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma empresa com três projetos de IA em andamento costuma ter três integrações com o mesmo CRM. O assistente de atendimento, o agente de cobrança e o painel de perguntas da diretoria foram construídos por times diferentes, cada um com os próprios filtros, as próprias regras de acesso e o próprio texto montado à mão para o modelo. Quando o cadastro de produtos muda, as três integrações quebram em semanas diferentes. A camada de contexto é a peça de arquitetura que evita essa repetição. Na Strattum, ela se chama Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
Os dados de uma empresa vivem em silos. Pedidos e faturas estão no ERP, oportunidades no CRM, chamados no helpdesk e contratos em uma ferramenta de gestão. Cada sistema guarda pouco sobre os registros dos outros.
Sem uma base comum, cada projeto de IA conecta as fontes, resolve as diferenças de cadastro, escreve as regras de acesso e monta o contexto que o modelo recebe. Esse contexto costuma ser montado à mão, por alguém que escolhe quais colunas entram no prompt.
No terceiro projeto, a mesma regra de negócio existe em três versões, e cada mudança na origem exige três correções.
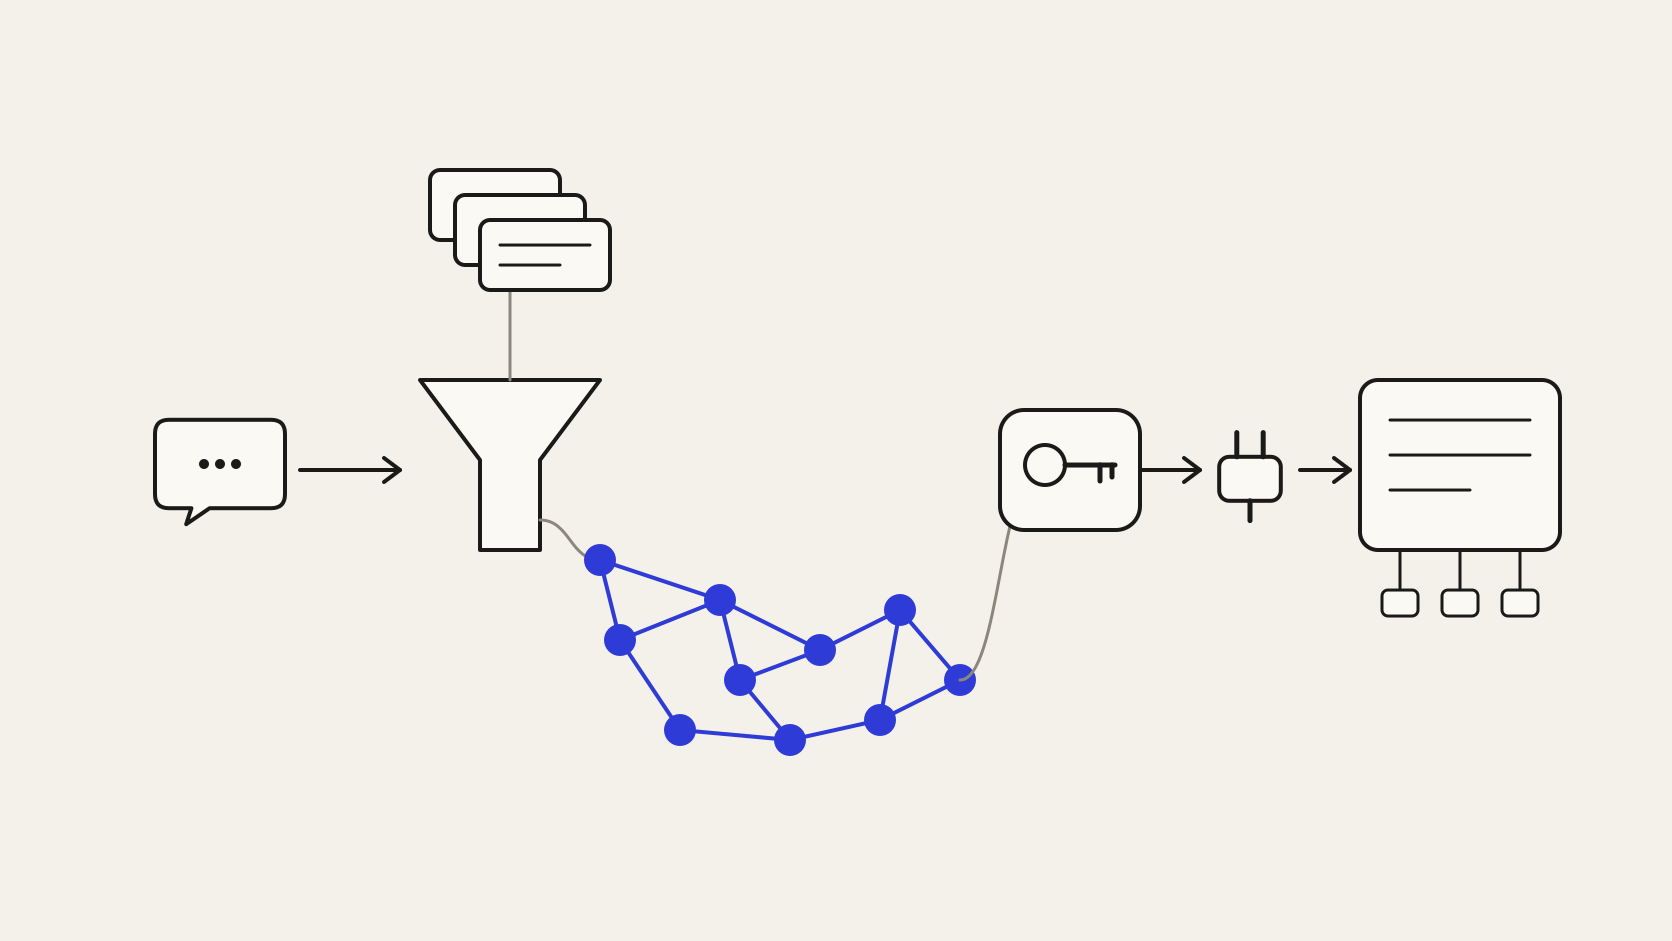
Camada de contexto é a camada intermediária que organiza o que os modelos de IA recebem sobre a empresa. Ela consulta os sistemas de origem, que continuam sendo a fonte do dado. Cinco funções a definem:
Cada função depende de um componente técnico:
Na prática, a pergunta entra pela camada semântica, que interpreta os termos pela ontologia e percorre o grafo até os registros. A permissão filtra o resultado antes da saída. O MCP faz a entrega, e a especificação do protocolo descreve recursos, ferramentas e prompts como o que um servidor oferece às aplicações de IA.
O mercado costuma começar pelo agente, porque ele demonstra bem em reunião, e o problema aparece quando ele age sobre dado incompleto. Um agente de cobrança que não enxerga o helpdesk envia a régua de cobrança a um cliente que abriu chamado contestando a mesma fatura.
A ordem que chega à produção começa pela camada de contexto. Com as fontes conectadas e as relações resolvidas, o agente de cobrança recebe a fatura já ligada ao chamado aberto. O agente seguinte consome a mesma camada e acrescenta apenas as fontes que faltam.
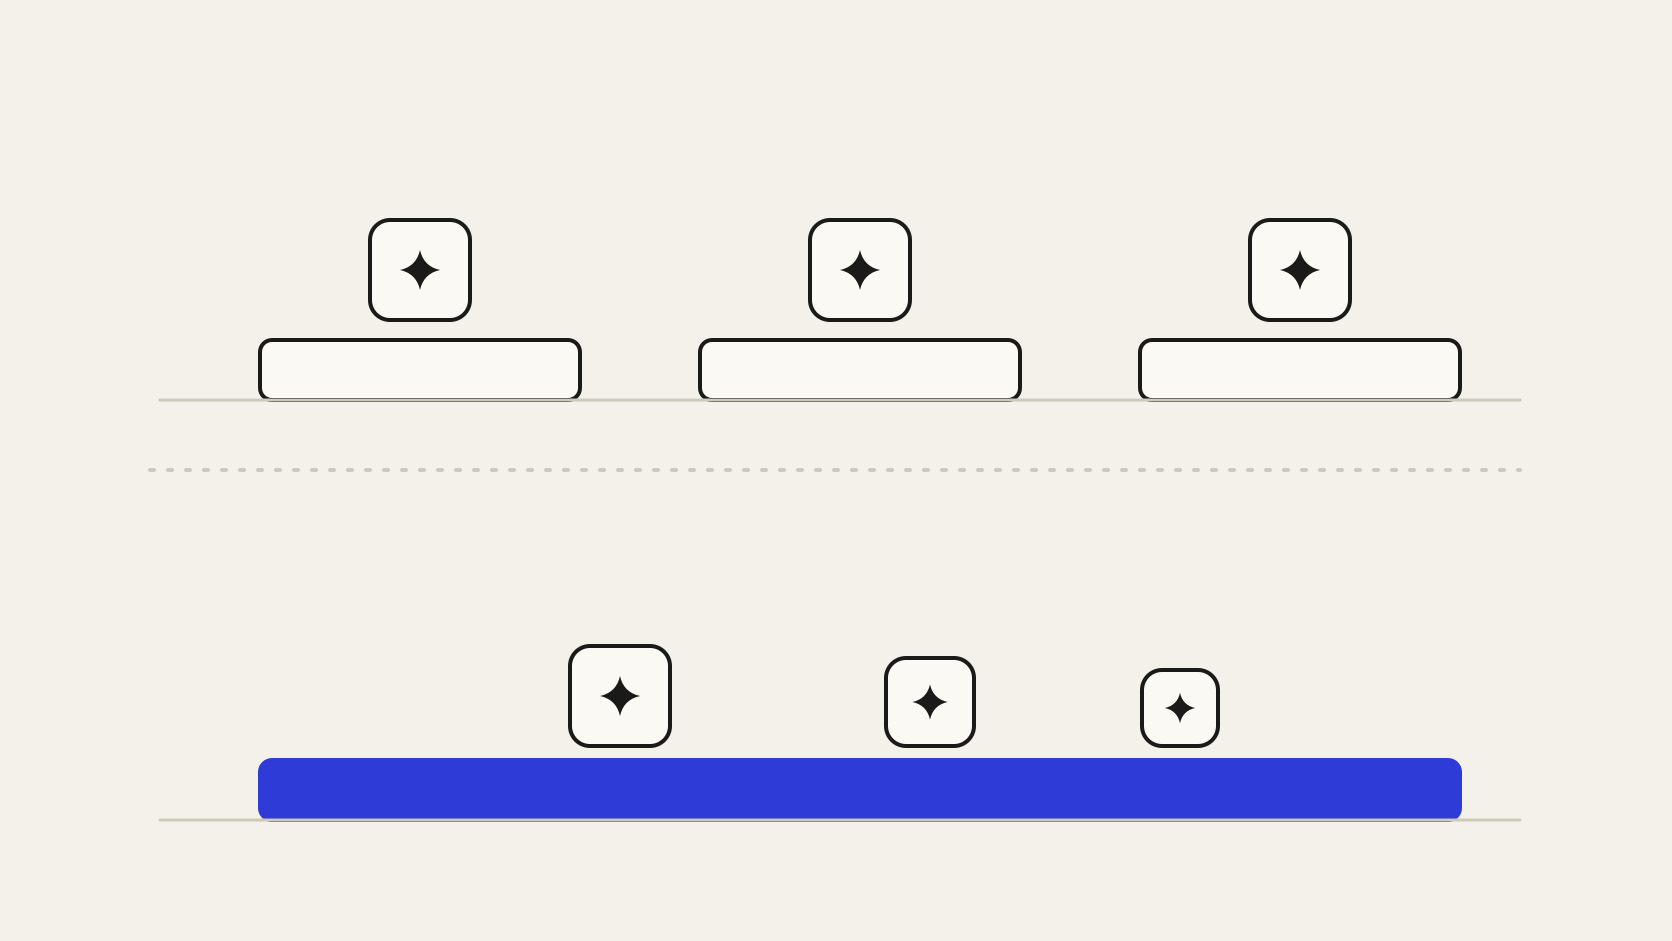
O primeiro efeito está nos tokens. Sem uma camada de contexto, os projetos compensam a falta de precisão enviando tabelas inteiras ou documentos longos ao modelo. Com o recorte resolvido, o prompt leva apenas os registros e as definições que a pergunta exige.
O segundo efeito está na escolha do modelo. Quando o contexto chega organizado, boa parte das tarefas roda em modelos de custo menor, porque encontrar e ligar os dados foi feito antes da chamada. Trocar de modelo também não exige refazer a integração.
O terceiro efeito está na integração reaproveitada. O segundo projeto parte das fontes conectadas, das entidades resolvidas e das permissões já aplicadas pelo primeiro.
O data warehouse consolida dados históricos em tabelas modeladas para relatório e BI, e responde bem a agregações sobre períodos fechados. O lago de dados armazena volume grande de dados brutos no formato original, para processamento posterior. O RAG isolado indexa os documentos de uma base para um projeto e recupera trechos parecidos com a pergunta.
A camada de contexto pode usar os três como fontes. Ela acrescenta a ligação entre registros de sistemas diferentes, o significado acordado de cada termo, a permissão por pessoa no momento da pergunta e a entrega por protocolo aos agentes.
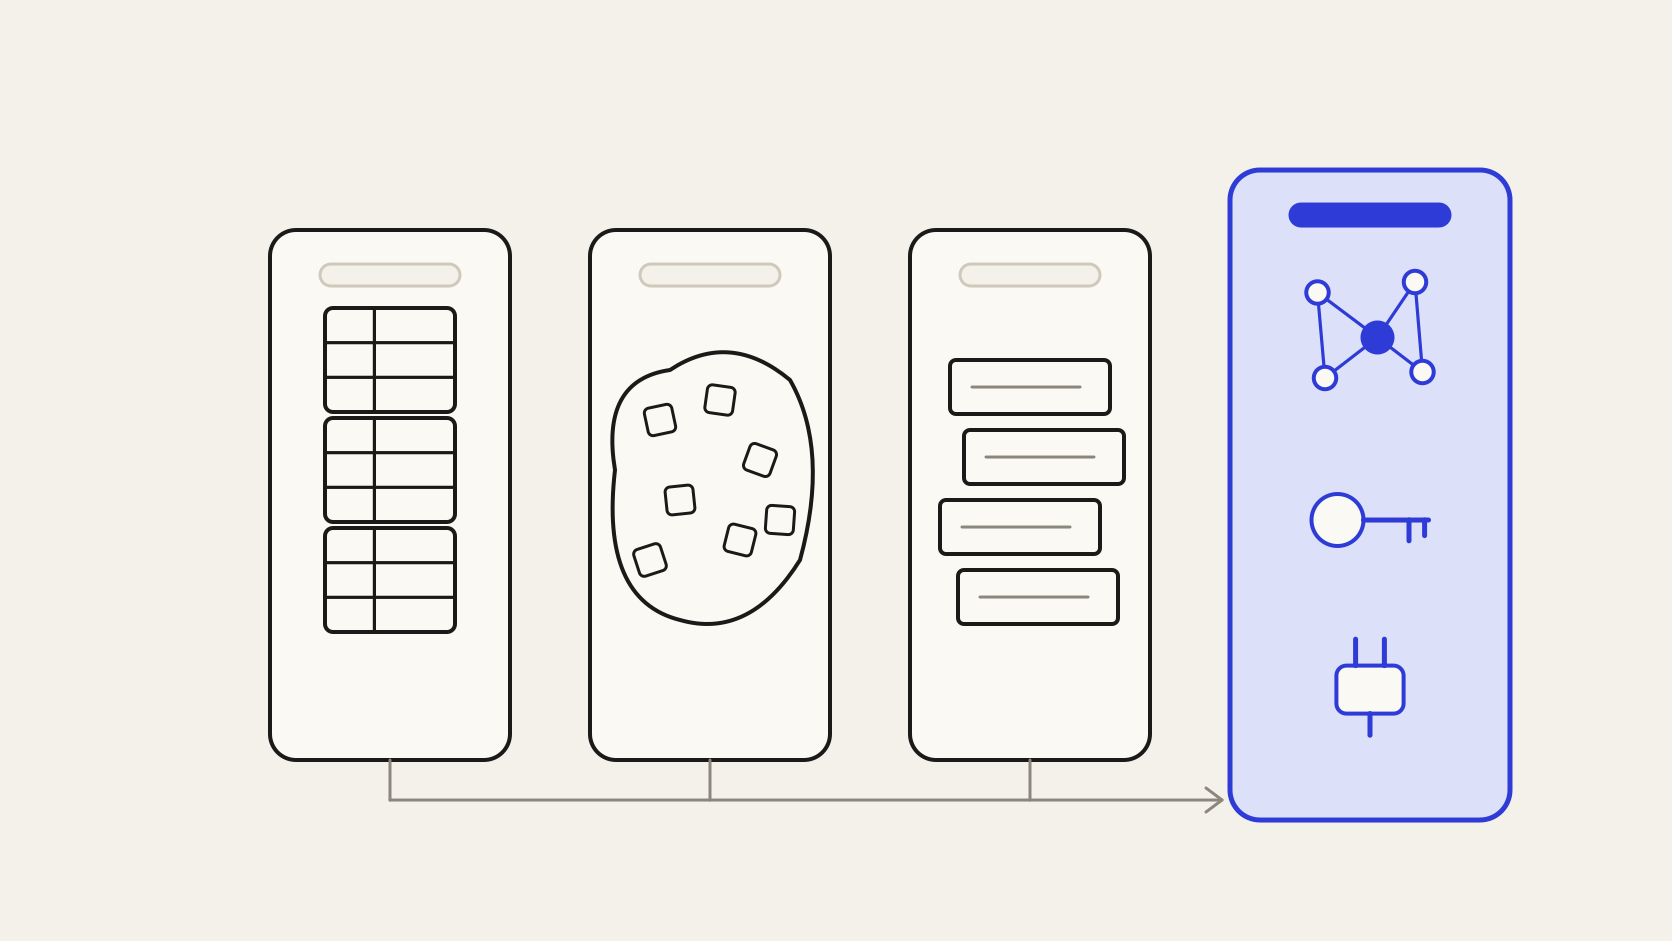
O Company Brain é o nome que a Strattum dá à camada de contexto construída para uma empresa específica, com as entidades, os termos e as permissões dela. Duas empresas com o mesmo ERP têm brains diferentes, porque pedido faturado segue regras próprias em cada uma.
Os dados permanecem nos sistemas e no ambiente do cliente. O modelo recebe, no momento da pergunta, o recorte que a permissão de quem perguntou autoriza, nos termos do contrato com o provedor.
A camada reduz as respostas erradas causadas por falta de contexto. A qualidade da resposta continua dependendo da qualidade do dado na origem.
O primeiro passo é listar os projetos de IA em andamento e planejados, com as fontes e os termos de cada um. A interseção indica o primeiro recorte. Se atendimento e cobrança dependem de cliente, contrato e fatura, essas três entidades e suas fontes formam a base, e os projetos seguintes partem dela.