
 Arthur Guttilla Head of Product Marketing, Strattum
Com passagens na Amazon Web Services e no Google, Guttilla trabalhou diretamente com fundadores de startups e empresas de capital de risco, compreendendo as necessidades de empresas tecnológicas em estágio inicial na interseção entre tecnologia e negócios.
Em resumo
Uma resposta de modelo de linguagem pode estar bem escrita, soar segura e citar um prazo contratual que não existe. Esse fenômeno tem nome: alucinação em IA. Ele não depende de falha no código nem de má-fé de quem configurou o sistema. Ele nasce, na maior parte dos casos, de uma pergunta que chega ao modelo sem o dado necessário para respondê-la. Por isso o tema leva direto ao Company Brain, a camada que conhece a empresa: quais dados existem, onde vivem, como se relacionam e quem pode ver o quê.
A definição mais aceita descreve a alucinação como um conteúdo gerado que soa fluente e coerente e que não corresponde aos fatos ou à fonte fornecida. A pesquisa acadêmica trata o tema há anos. Uma referência central é a revisão publicada na ACM Computing Surveys sobre alucinação em geração de linguagem natural, que organiza métricas, causas e formas de mitigação em diferentes tarefas.
O ponto que importa para a empresa está na palavra plausível. Uma resposta absurda é descartada na hora. Uma resposta plausível passa pela leitura rápida, porque tem o formato, o vocabulário e o tom de uma resposta certa.
Um LLM produz texto prevendo, a cada passo, o trecho mais provável a partir do que recebeu e do que aprendeu no treinamento. O mecanismo é o mesmo quando a informação está no prompt e quando não está. Se a pergunta é sobre o SLA contratado por um cliente e o contrato não chegou ao modelo, a continuação mais provável é um SLA típico de mercado, escrito com a mesma fluência.
O modelo não tem um sinal interno confiável que separe o que veio da fonte do que veio do padrão estatístico. A lacuna na entrada vira texto na saída. Por isso a alucinação em IA é, antes de tudo, um problema de contexto.
No uso pessoal, uma alucinação custa uma checagem. No uso corporativo, a resposta segue adiante. Um prazo inventado entra na proposta enviada ao cliente. Um desconto mal atribuído é gravado no ERP por um agente que tem permissão de escrita. Um número plausível vai para o material do comitê e sustenta uma decisão de investimento.
Cada etapa dá à informação errada uma aparência maior de validade, porque ela passa a constar em documento oficial. Quanto mais longe da origem o erro é descoberto, maior o custo de desfazê-lo.
Modelos mais recentes tendem a alucinar menos em perguntas de conhecimento geral, embora nem toda geração nova melhore nesse ponto. Eles continuam sem acesso ao contrato daquele cliente ou ao estoque daquela filial. Para dado interno, o tamanho do modelo não substitui o dado, e a alucinação em IA sobre o negócio continua com a mesma causa.
A instrução no prompt para responder apenas com base nas fontes ajuda, e tem limite. Quando a fonte enviada é a errada, desatualizada ou incompleta, o modelo segue a instrução e responde com base nela. A alucinação muda de origem e continua presente.
As medidas que funcionam atuam sobre a entrada e sobre a verificação da saída:
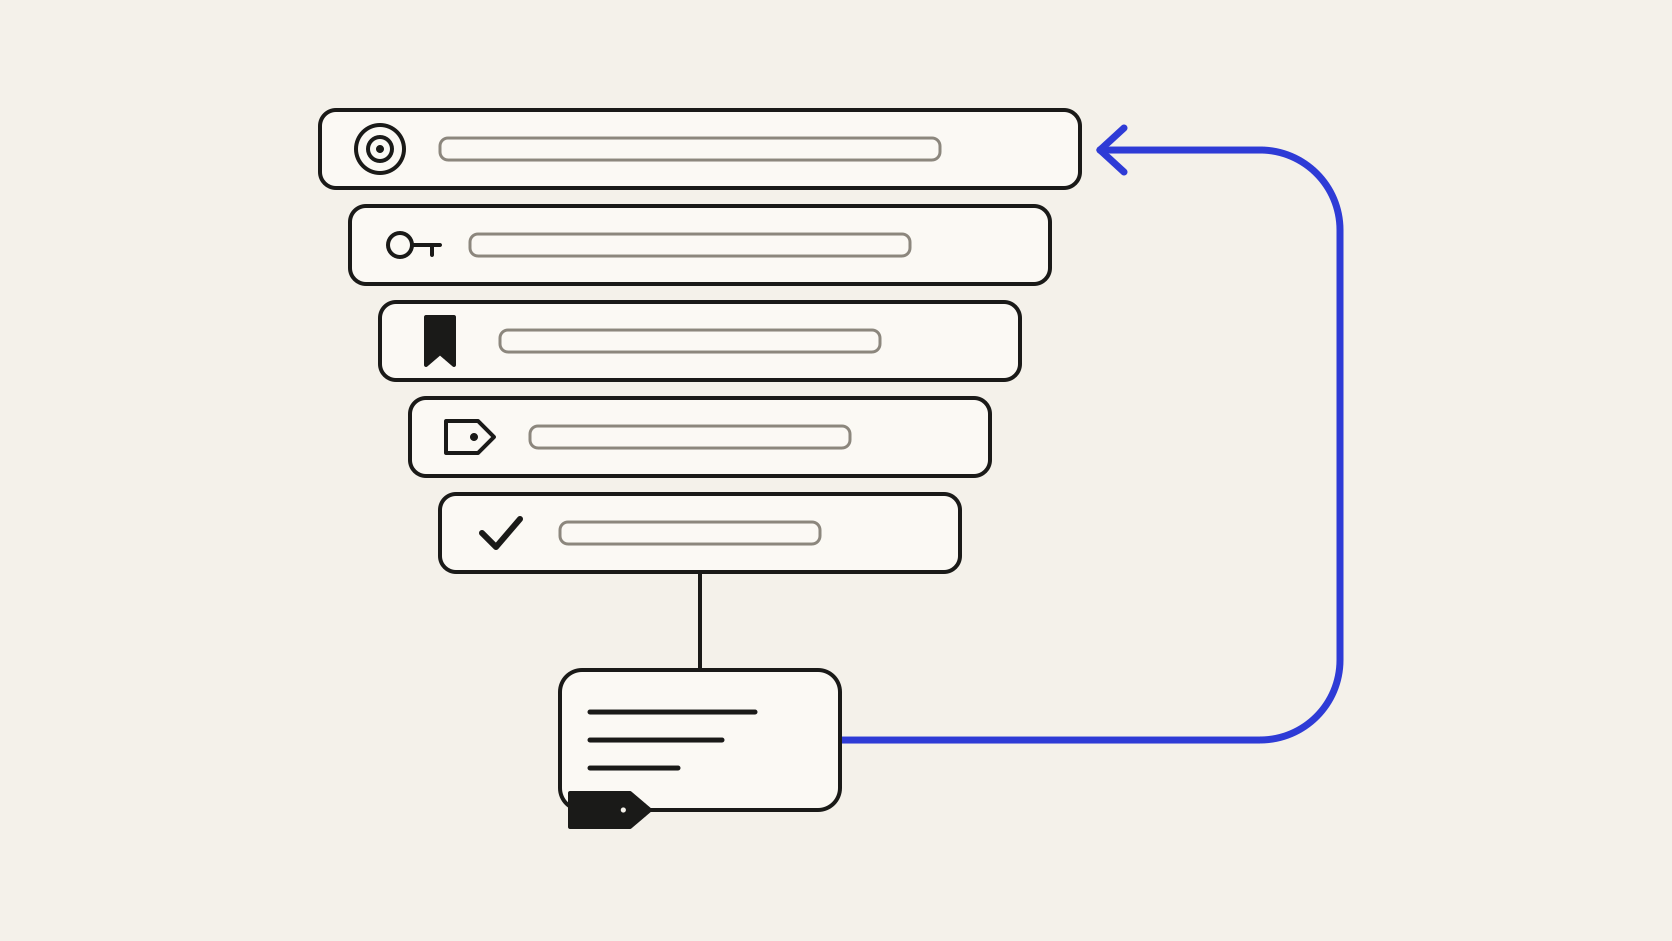
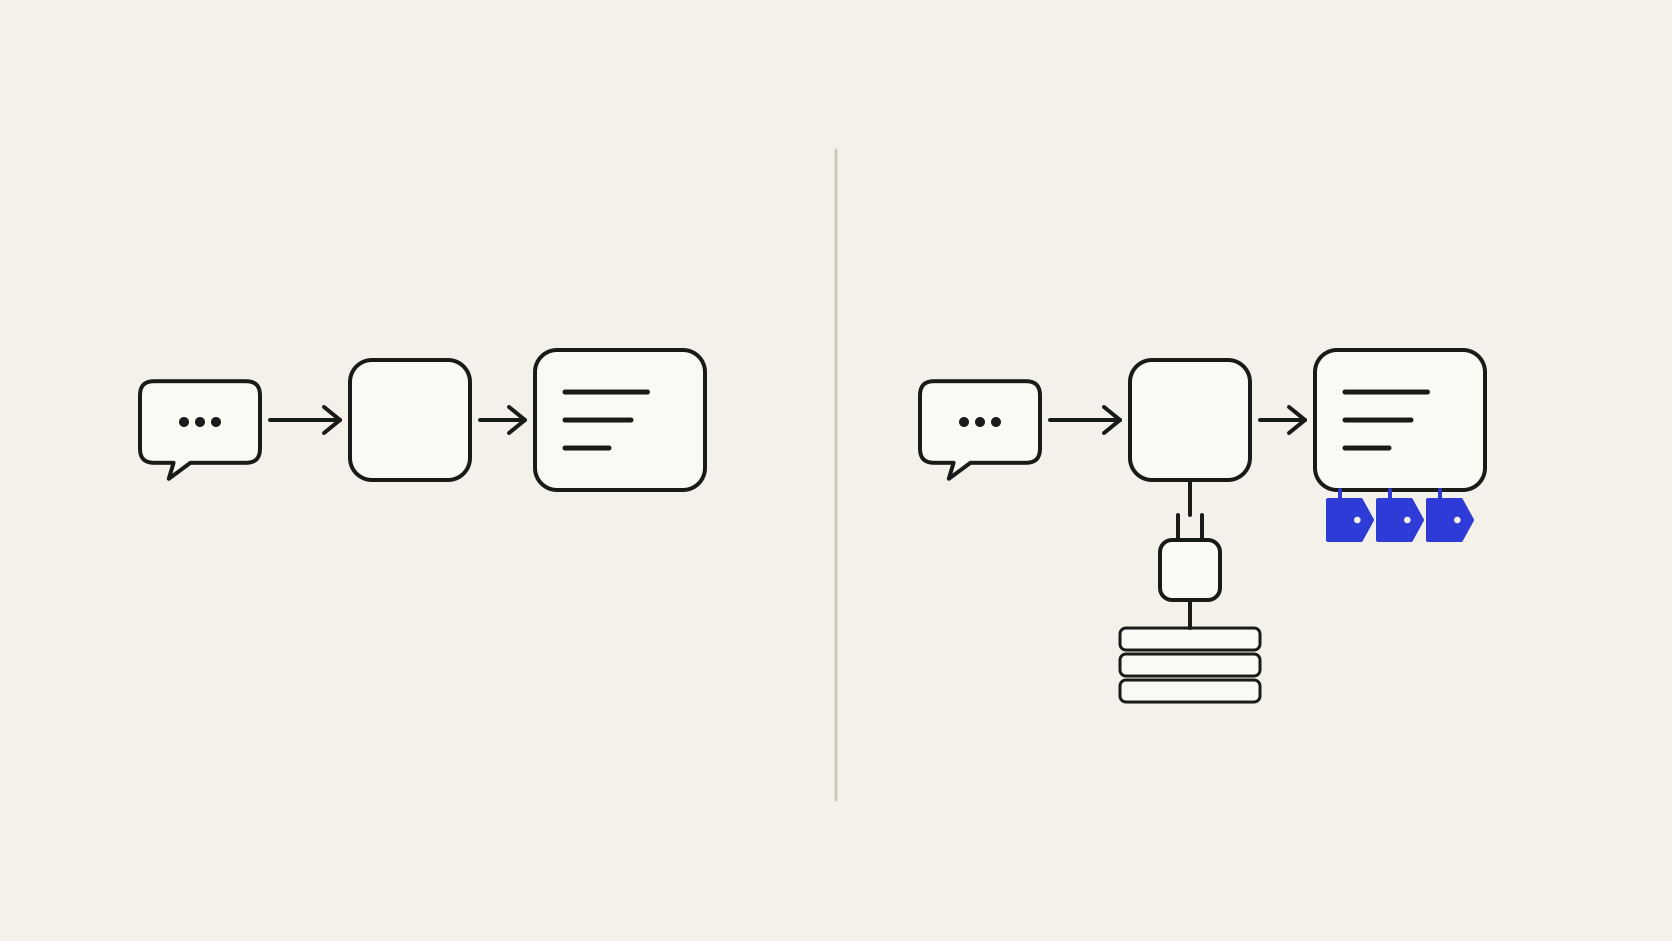
O Company Brain atua sobre a causa principal. O grafo de conhecimento liga o cliente ao contrato, aos pedidos e aos chamados, o que reduz a mistura de registros. A ontologia do negócio registra o que cada termo significa na empresa. A camada semântica traduz a pergunta para a consulta certa e aplica a permissão herdada do sistema de origem.
O recorte resultante é servido ao modelo via MCP com a origem de cada informação. Quando a resposta cita um SLA, a citação leva à cláusula do contrato. Quando o dado não existe nas fontes, o contexto chega vazio naquele ponto, e o fluxo pode tratar a ausência como ausência. A alucinação em IA diminui, e o que sobra fica verificável.
Nenhuma arquitetura elimina a alucinação. O Company Brain reduz a frequência e torna cada resposta auditável, e isso depende de fontes atualizadas, definições mantidas pelas áreas responsáveis e permissões corretas na origem. Dado errado no ERP continua errado na resposta.
O ponto de partida prático é reunir algumas dezenas de perguntas que as equipes já fazem, com a resposta correta conferida por quem conhece o processo. Esse conjunto mede a alucinação em IA antes e depois de cada mudança, e indica quais fontes e definições precisam entrar primeiro no contexto.